
Depuis quelques mois, Claude Code est devenu une sorte de réflexe pour les sessions de dev assisté : tu ouvres le terminal, tu donnes le contexte, et tu laisses l'agent avancer dans le repo. Le problème, c'est que cette expérience dépend énormément de deux choses qui ne pardonnent pas : la disponibilité de l'infra et le coût des tokens de sortie.
Et c'est précisément là que le paysage a changé. DeepSeek V4 Pro, GPT-5.5, Gemini 3.5 Flash testé dans Antigravity 2.0 et Qwen 3.7 Max ne sont plus des modèles "sympas à surveiller". Ce sont des alternatives crédibles, parfois moins élégantes que Claude, mais souvent beaucoup plus rationnelles pour du coding agentique au quotidien.
Le bon modèle n'est plus forcément le plus fort sur benchmark. Pour coder longtemps, il faut regarder le triptyque : qualité de raisonnement, stabilité de service, coût réel de sortie.
Pourquoi comparer maintenant ?
Parce que Claude a un paradoxe très net : le produit est excellent, mais l'expérience réelle se dégrade dès que la demande explose. Les erreurs HTTP 500, les ralentissements, les files d'attente implicites et les pics de latence cassent la continuité d'une session de code. Sur une tâche de refactor ou de debug multi-fichiers, une interruption n'est pas juste pénible : elle fait perdre le fil.
Anthropic documente d'ailleurs le cas des 5xx côté Claude Code : l'outil affiche le corps de réponse brut et renvoie vers le statut du service si l'erreur persiste. C'est normal côté support, mais côté utilisateur ça confirme un point simple : le modèle peut être excellent, si l'infra ne suit pas aux heures chargées, l'outil devient difficile à défendre comme dépendance unique.
Tableau technique
| Modèle | Forces | Points faibles | Meilleur usage coding |
|---|---|---|---|
| DeepSeek V4 Pro | Architecture MoE très compétitive, 1M tokens de contexte, rapport prix/performance agressif. | Écosystème moins intégré que Claude Code, qualité front-end parfois plus irrégulière, dépendance provider à surveiller. | Refactor, scripts, backend, data engineering, longues sessions à coût maîtrisé. |
| GPT-5.5 | Très solide en code, rapide en pratique, multimodalité fichier/image/texte, contexte 1.05M, intégration Codex avec skills, plugins, tools et workflow agentique complet. | Prix premium proche de Claude, sortie à $30/M tokens, et sur très gros prompts OpenAI applique une majoration au-delà de 272K tokens d'entrée. | Alternative premium à Claude Code : backup sérieux, voire remplacement principal si l'infra Anthropic bloque trop souvent. |
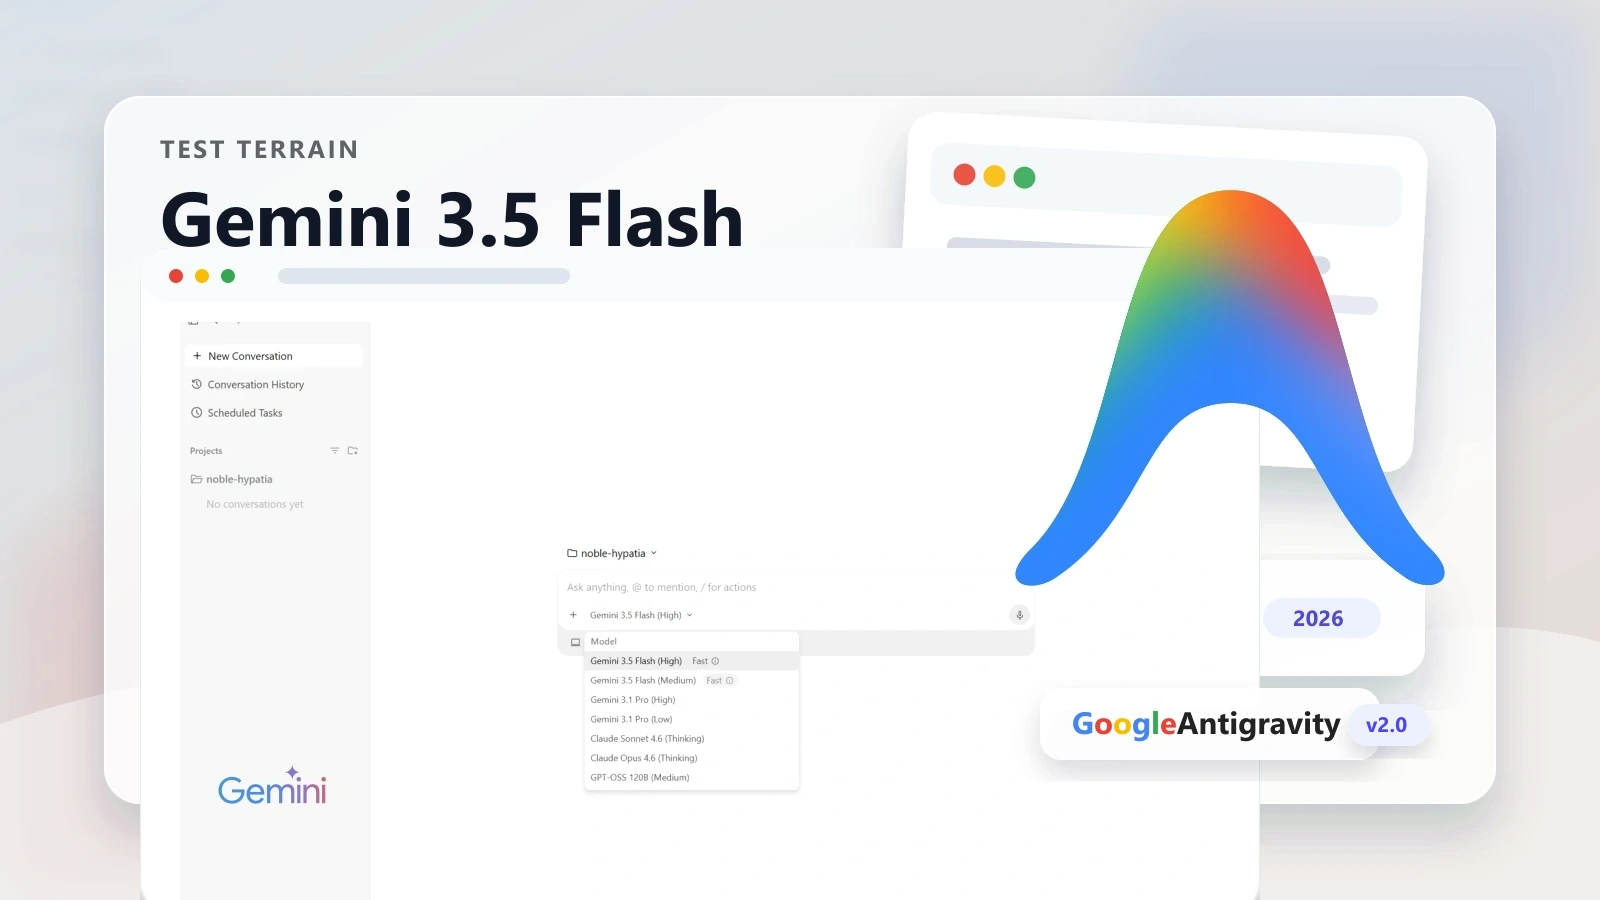
| Gemini 3.5 Flash | Très rapide, multimodal, bon candidat pour les workflows agentiques et Antigravity. | Prix plus élevé qu'attendu pour un "Flash", comportement parfois très produit Google, UX Antigravity encore ambivalente. | Prototypage front, génération UI, analyse multimodale, agents rapides. |
| Qwen 3.7 Max | Très bon positionnement agentique/coding, 1M tokens de contexte, prix intermédiaire, écosystème Qwen actif. | Modèle Max propriétaire, peut être verbeux, donc la facture réelle peut monter malgré un tarif correct. | Long-horizon agents, debug, tâches bureautiques et code multi-étapes. |
| Claude Opus 4.7 | Très fort en raisonnement, très bon en code, excellente compréhension de gros repos. | Prix de sortie élevé, incidents récurrents côté Claude/Claude Code, dépendance forte à l'infra Anthropic. | Tâches complexes où la qualité prime sur le coût : architecture, gros debug, review critique. |
Tableau pricing
Les prix bougent vite. Le tableau ci-dessous sert de repère au 25 mai 2026, à vérifier avant usage production. Je retiens le prix par million de tokens, parce que c'est là que la différence devient brutale.
| Modèle | Input / 1M tokens | Output / 1M tokens | Lecture rapide |
|---|---|---|---|
| DeepSeek V4 Pro | $0.435 | $0.87 | Le tarif sacrifié change complètement le calcul pour les agents de code. |
| DeepSeek V4 Flash | $0.14 | $0.28 | À surveiller pour de l'agentique rapide, du routage, des tâches simples ou répétitives. |
| GPT-5.5 | $5.00 | $30.00 | Prix premium, proche de Claude Opus, mais avec contexte 1.05M, image en entrée, cache à $0.50/M et intégration Codex très mature. |
| Gemini 3.5 Flash | $1.50 | $9.00 | Rapide et solide, mais plus vraiment un tarif "cheap flash". |
| Qwen 3.7 Max | $2.50 | $7.50 | Bon compromis, mais attention à la verbosité en sessions longues. |
| Claude Opus 4.7 | $5.00 | $25.00 | Excellent, mais la sortie coûte presque 29x DeepSeek V4 Pro au nouveau tarif. |
GPT-5.5 dans Codex : l'alternative premium qui tient la charge
Depuis que je l'utilise en réflexion moyenne, GPT-5.5 est devenu mon vrai backup à Claude Code, et même mon remplacement principal sur certaines sessions. J'ai fini par remplacer mon plan Claude Max par le plan Codex à 20 €, parce que ça me suffit largement comme LLM principal au quotidien. Ce n'est pas l'option low-cost du comparatif : OpenAI l'affiche à $5/M tokens en entrée et $30/M tokens en sortie, donc on reste dans une zone premium côté API. Mais côté usage produit, j'avais surtout besoin d'une alternative solide, stable, et moins pénible que Claude quand les bugs d'infra cassent le flow.
Le point fort, ce n'est pas seulement le modèle. C'est l'environnement autour : Codex, les skills, les plugins, les tools, l'intégration fichier/image/texte, et une boucle agentique qui donne moins l'impression de bricoler un routeur LLM à la main. La multimodalité est aussi un vrai plus : envoyer une capture, un fichier ou un bout de contexte visuel sans tout reformuler accélère énormément certains debug UI ou reviews produit.
Autre détail qui compte en DX : dans Codex, tu peux aussi générer directement des assets pour un article, une UI ou un prototype, puis les intégrer dans le projet sans sortir du workflow. Quand tu fais du front, de la doc produit ou des tests visuels, ce gain de continuité n'est pas anecdotique.
Côté specs, la page OpenAI indique 1 050 000 tokens de contexte, 128K tokens de sortie max, support du raisonnement, input texte + image, et endpoints Responses / Chat Completions. En Codex, OpenAI annonce aussi GPT-5.5 sur les plans Plus, Pro, Business, Enterprise, Edu et Go, avec une fenêtre de contexte de 400K côté produit Codex. Autrement dit : en API on regarde le million de contexte, mais dans Codex l'expérience produit peut avoir ses propres limites.


Ma lecture : GPT-5.5 ne vient pas battre Claude par le prix. Il vient le concurrencer par la fiabilité perçue, la vitesse d'exécution, la multimodalité, et l'écosystème Codex. Si Claude Code est ton outil principal mais que les erreurs 500 te coupent trop souvent dans le flow, GPT-5.5 est probablement l'alternative premium la plus naturelle.
DeepSeek V4 Pro et V4 Flash : le prix comme arme
Le mouvement le plus agressif vient clairement de DeepSeek. La remise de 75% sur V4 Pro, initialement présentée comme promotionnelle, est maintenant reprise comme permanente par plusieurs sources le 25 mai 2026. À ce tarif, on descend à $0.87 par million de tokens de sortie pour V4 Pro, ce qui change le coût d'une session agentique longue.
Ce n'est pas juste une baisse marketing. Les modèles chinois comme DeepSeek et Qwen poussent une logique MoE très adaptée à l'inférence économique : beaucoup de capacité totale, mais une fraction activée par token. En pratique, ça permet de proposer un niveau de performance haut de gamme sans calquer les tarifs des modèles fermés américains.
Et il ne faut pas oublier DeepSeek V4 Flash. Sur le papier, c'est moins prestigieux que V4 Pro, mais à $0.28 le million de tokens de sortie, il devient très intéressant pour des agents qui doivent itérer, classifier, router, relire, tester des hypothèses, ou faire du code répétitif sans mobiliser un flagship à chaque appel.
Concrètement, j'ai déjà délocalisé pas mal de workflows vers DeepSeek V4 Flash ou V4 Pro selon la tâche, notamment sur mon Hermes Agent. Et franchement, c'est un régal : vitesse, qualité d'exécution, très peu d'hallucinations, et une précision qui rend le setup beaucoup plus agréable qu'un agent premium utilisé partout par défaut.
Le vrai sujet Claude Code : excellent, mais fragile
Je ne vais pas faire semblant : Claude Code reste très fort. Quand Opus répond vite, avec assez de contexte, sur un gros repo, c'est encore une des expériences les plus confortables. Le modèle comprend bien l'intention, lit les diffs proprement, sait garder une vision architecture, et fait souvent moins d'erreurs absurdes que des alternatives moins chères.
Mais l'équation se dégrade. À $25 le million de tokens de sortie, chaque boucle agentique longue coûte cher. Et quand, en plus, tu te retrouves avec des erreurs 500 ou des ralentissements aux heures de charge, tu payes une prime premium pour une expérience qui n'est pas toujours premium.
Le problème de Claude aujourd'hui n'est pas seulement le prix. C'est le couple prix + disponibilité. Pour du code, la continuité de session compte presque autant que la qualité du modèle.
— notes terrain
Verdict
Mon avis actuel : Claude Opus 4.7 reste un choix premium quand la tâche est vraiment difficile et que le coût est secondaire. Mais l'utiliser par défaut pour toute session de code devient de moins en moins rationnel, surtout si l'infra te coupe au mauvais moment.
Pour du développement quotidien, DeepSeek V4 Pro est probablement le meilleur pari coût/performance du moment. GPT-5.5 est l'alternative premium la plus sérieuse à Claude Code : chère en API, oui, mais très rapide, multimodale, bien intégrée et nettement plus rassurante si tu veux éviter les problèmes de disponibilité Claude. Dans mon cas, le plan Codex à 20 € a remplacé mon Claude Max parce qu'il couvre déjà mon usage principal. DeepSeek V4 Flash mérite d'être branché comme modèle de routage ou de tâches agentiques peu critiques. Qwen 3.6 Plus dans OpenCode donne déjà un bon aperçu de ce que la famille Qwen peut apporter aux workflows longs. Gemini 3.5 Flash garde un intérêt fort si tu es déjà dans l'écosystème Google ou Antigravity, mais son tarif le rend moins évident que son nom ne le suggère.
La bonne stratégie n'est donc pas de remplacer Claude par un seul modèle. C'est de construire un setup multi-modèles : GPT-5.5 ou Claude pour les tâches premium, DeepSeek pour le volume, Qwen pour les longues sessions agentiques, Gemini pour les workflows rapides et multimodaux. En 2026, la vraie compétence n'est plus seulement de bien prompter. C'est de bien router.
— Ruben
Sources
- DeepSeek API pricing — page officielle des tarifs.
- Dataconomy, DeepSeek V4 Pro price cut — reprise du passage permanent de la remise.
- OpenAI, Introducing GPT-5.5 — annonce, disponibilité Codex, contexte et évaluations.
- OpenAI API, GPT-5.5 model — contexte, sortie max, modalités et pricing détaillé.
- OpenAI API pricing — prix GPT-5.5 standard.
- Anthropic, Claude Opus — prix Opus et fiche produit.
- Claude Code error reference — documentation des erreurs 5xx.
- Anthropic status — incidents et état de service Claude.
- Google AI, Gemini API pricing — tarifs Gemini API.
- OpenRouter, Qwen 3.7 Max pricing — route et tarif API.