Terminal-Bench passe de 61,8 à 82,7. DeepSWE passe de 7,3 à 54,4. Et ce petit modèle dépasse le grand modèle de la même maison sur les neuf benchmarks publiés. Voilà pour le communiqué.
Ce qui m’intéresse dans cet article n’est pas la course aux scores, qui périme en trois semaines. C’est ce que ces vingt-quatre heures disent du marché : le prix au million de tokens ne veut plus rien dire, et ce qui compte désormais est le coût par tâche terminée. Sur ce terrain, l’écart n’est plus un écart, c’est une falaise.
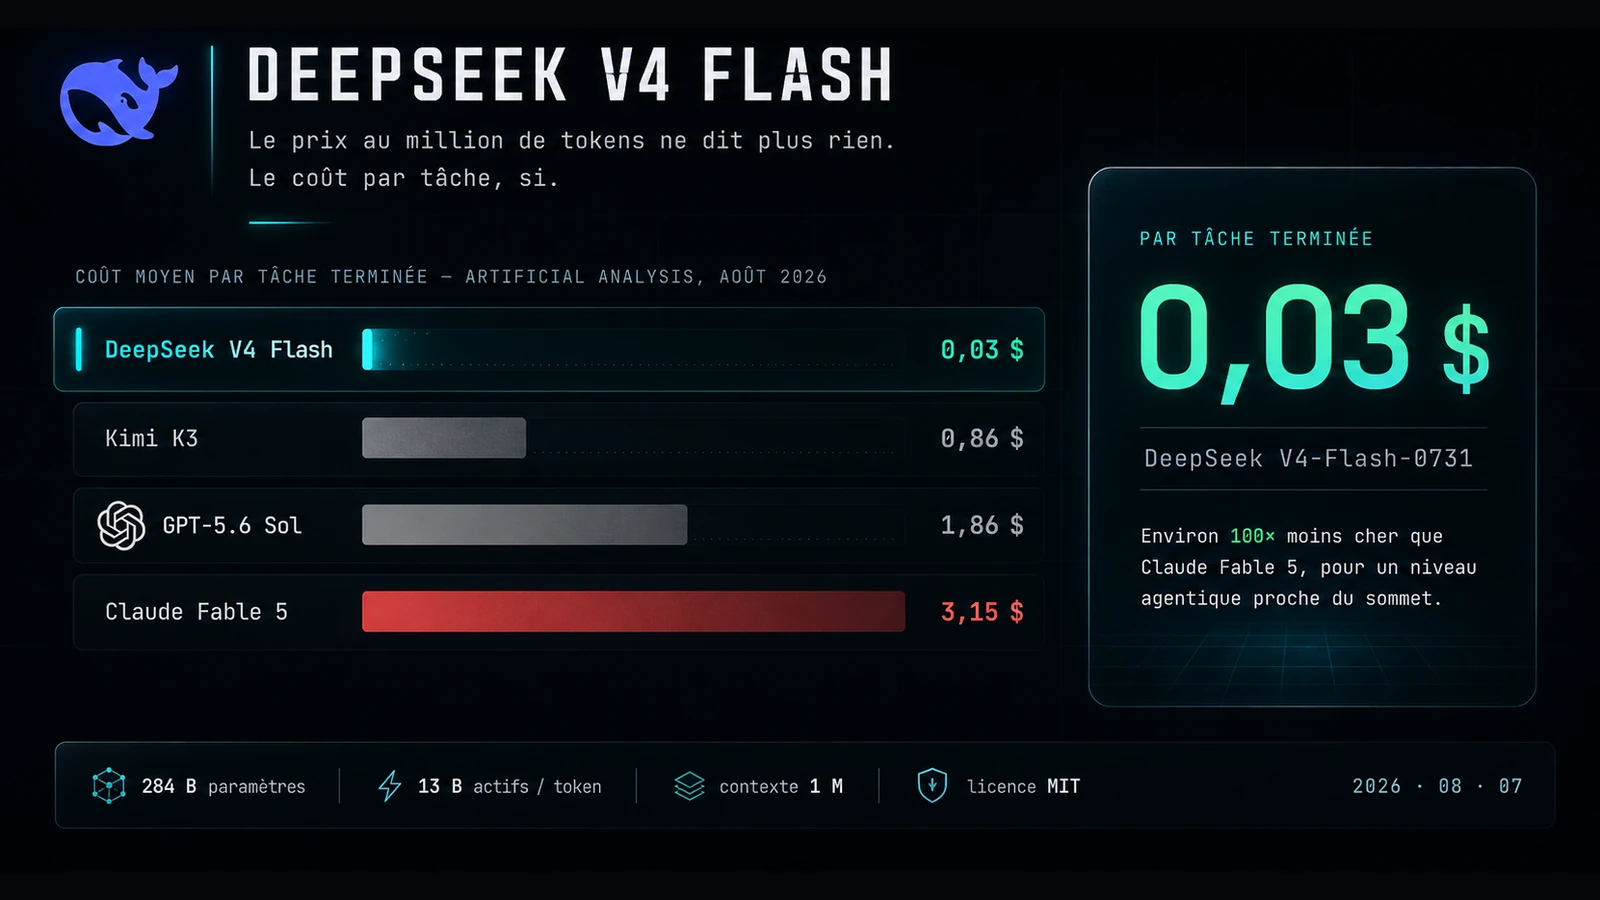
V4 Flash coûte environ 0,03 $ par tâche, là où GPT-5.6 Sol en coûte 1,86 $. Pour une grande partie des étapes agentiques, il suffit. Le choix de modèle devient donc une décision budgétaire avant d’être une décision technique. Chiffres arrêtés au 7 août 2026.
Ce qui a changé le 31 juillet
D’abord une précision, parce qu’elle change la lecture. DeepSeek n’a pas sorti un nouveau modèle. La famille V4 existe depuis le 24 avril 2026, sous licence MIT, avec les poids disponibles sur Hugging Face. Ce qui est arrivé fin juillet, c’est une nouvelle version appelée V4-Flash-0731. Même modèle, même architecture. Seul le post-entraînement a été refait.
Tout le gain vient donc de la phase d’entraînement agentique. Le socle n’a pas bougé, et c’est précisément ce qui rend le saut intéressant : il ne coûte pas un nouveau cycle de pré-entraînement.
| Benchmark | Version preview | Version 0731 |
|---|---|---|
| Terminal-Bench 2.1 | 61,8 | 82,7 |
| DeepSWE | 7,3 | 54,4 |
| Cybergym | 38,7 | 76,7 |
| NL2Repo | 39,4 | 54,2 |
| Toolathlon-Verified | — | 70,3 |
| Agent Last Exam | — | 25,2 |
| Automation Bench (public) | — | 25,1 |
| DSBench-FullStack | — | 68,7 |
| DSBench-Hard | — | 59,6 |
DeepSWE est multiplié par 7,5. Cybergym double. Et le petit modèle passe devant le vaisseau amiral de la maison sur les neuf benchmarks publiés.
Trois précautions avant de s’emballer
Ces chiffres viennent de DeepSeek, pas d’un tiers indépendant. Trois choses à garder en tête.
Le harness compte autant que le modèle. L’évaluation a tourné avec le harness maison de DeepSeek, en mode minimal, palier max, top_p à 0,95 et température à 1,0. DeepSeek précise elle-même que les scores agent y sont très sensibles. Vos chiffres seront différents des siens.
Deux benchmarks sur neuf sont internes. DSBench-FullStack et DSBench-Hard appartiennent à DeepSeek. Ils ne se comparent à rien d’autre.
Le sommet n’est pas pris. Sur Terminal-Bench 2.1, Opus 4.8 reste devant avec 85,0 contre 82,7. GLM-5.2 est à 81,0. Mon propos n’est donc pas que DeepSeek fait mieux. Il est que DeepSeek fait presque aussi bien, pour beaucoup moins cher.
Pourquoi un petit modèle y arrive
284 milliards de paramètres, ce n’est pas petit. Mais ce n’est pas ce que vous payez.
V4 Flash est un modèle Mixture-of-Experts. Sur les 284 milliards de paramètres stockés, 13 milliards seulement s’activent par token. Le coût de calcul suit ce qui s’active, pas ce qui est stocké.
S’ajoute une attention hybride, qui combine deux mécanismes de compression. Le résultat annoncé : 27 % des FLOPs par token de V3.2, et 10 % de son cache KV à un million de tokens de contexte.
Concrètement, le contexte long arrête d’être une taxe. Un agent qui traîne 300 000 tokens d’historique, de documentation et de sorties d’outils ne fait plus exploser la facture. C’est exactement le profil d’un agent réel, par opposition à un chatbot.
Le débit suit : 81,3 tokens par seconde contre 35,6 pour V4 Pro sur l’endpoint officiel. Sur une boucle d’agent à quarante étapes, cet écart de latence compte souvent plus qu’un point de benchmark.
Dernier point pratique. En quantification 4 bits, le modèle tient dans 150 à 190 Go. Un nœud H100 ou H200 suffit. Une machine à 192 Go de mémoire unifiée aussi. C’est le premier modèle de ce niveau qu’une ETI peut réellement héberger elle-même.
V4 Flash
Appels d’outils, extraction, classification, lecture de logs, boucles de reprise.
Modèle intermédiaire
Agrégation de sorties, rédaction destinée à un humain, vérification d’un enchaînement.
Modèle frontière
Arbitrages d’architecture, refactor transverse, décisions dont l’erreur coûte cher.
Ce que ça coûte vraiment
Voici les tarifs officiels, après la baisse d’OpenAI du 30 juillet.
| Modèle | Entrée / M tokens | Sortie / M tokens |
|---|---|---|
| DeepSeek V4 Flash | 0,14 $ (0,0028 $ en cache-hit) | 0,28 $ |
| GPT-5.6 Luna | 0,20 $ | 1,20 $ |
| Claude Opus 4.8 | 5,00 $ | 25,00 $ |
| GPT-5.6 Sol | 5,00 $ | 30,00 $ |
Première chose à corriger : arrêtez de comparer V4 Flash à Sol. Personne ne fait tourner quarante étapes d’agent sur un modèle à 30 $ le million de tokens en sortie. Ce serait choisir l’adversaire le plus facile.
Depuis le 30 juillet, le vrai concurrent de V4 Flash s’appelle Luna. Face à Luna, l’écart n’est plus de 100 fois. Il est de 1,4 fois en entrée et 4,3 fois en sortie. C’est moins spectaculaire. C’est aussi beaucoup plus solide, parce que c’est la sortie qui coûte dans une boucle d’agent.
Le prix au token ne dit pas tout
Un modèle pas cher mais bavard, qui a besoin de trois fois plus d’étapes, revient plus cher qu’un modèle cher et efficace. C’est pour ça qu’Artificial Analysis mesure autre chose : le coût moyen d’une tâche terminée.
| Modèle | Coût moyen par tâche |
|---|---|
| DeepSeek V4 Flash | 0,03 $ |
| Kimi K3 | 0,86 $ |
| GPT-5.6 Sol | 1,86 $ |
| Claude Fable 5 | 3,15 $ |
Sur leur Intelligence Index, qui agrège neuf benchmarks, V4 Flash obtient 50 sur 100. À égalité avec Gemini 3.6 Flash, un point sous Muse Spark 1.1 et GLM-5.2. Leur conclusion : c’est le modèle connu le moins cher à faire tourner.
Un exemple chiffré
Prenons un agent de support. Quarante étapes par ticket, 200 000 tokens en entrée et 40 000 en sortie, 10 000 tickets par mois. Ça fait 2 milliards de tokens en entrée et 400 millions en sortie. J’affiche les hypothèses exprès : ajustez-les à votre trafic, la structure du calcul restera la même.
| Modèle | Par mois | Par an |
|---|---|---|
| V4 Flash · API DeepSeek | 392 $ | 4 704 $ |
| V4 Flash · API DeepSeek, 70 % de cache | 200 $ | 2 400 $ |
| V4 Flash · alias OpenRouter (0,09 $ / 0,18 $) | 252 $ | 3 024 $ |
| GPT-5.6 Luna | 880 $ | 10 560 $ |
| Claude Opus 4.8 | 20 000 $ | 240 000 $ |
| GPT-5.6 Sol | 22 000 $ | 264 000 $ |
L’écart entre Sol et Flash dépasse 259 000 $ par an, sur un seul cas d’usage.
Le cache mérite une mention. À 0,0028 $ le million, un agent avec un prompt système stable et des outils figés divise encore sa facture par deux. Et comme le trafic agentique réel est massivement dominé par l’entrée, ce poste pèse en pratique plus lourd que ne le suggère mon ratio 5:1, volontairement conservateur.
Un détail pour les responsables de budget. Avant le 30 juillet, la ligne Luna affichait 4 400 $ par mois. La baisse d’OpenAI vient de faire économiser 3 520 $ par mois à cette entreprise fictive. Elle n’a rien demandé, rien renégocié, rien migré. Quelqu’un d’autre a obtenu cette baisse pour elle. C’est la même mécanique que celle que je décrivais dans mon réveil FinOps sur la facture des agents de code : la ligne budgétaire bouge sans que l’équipe technique ait touché à quoi que ce soit.
La hausse annoncée par DeepSeek
Petit élément amusant. Pendant la rédaction de cet article, j’ai reçu ce mail.
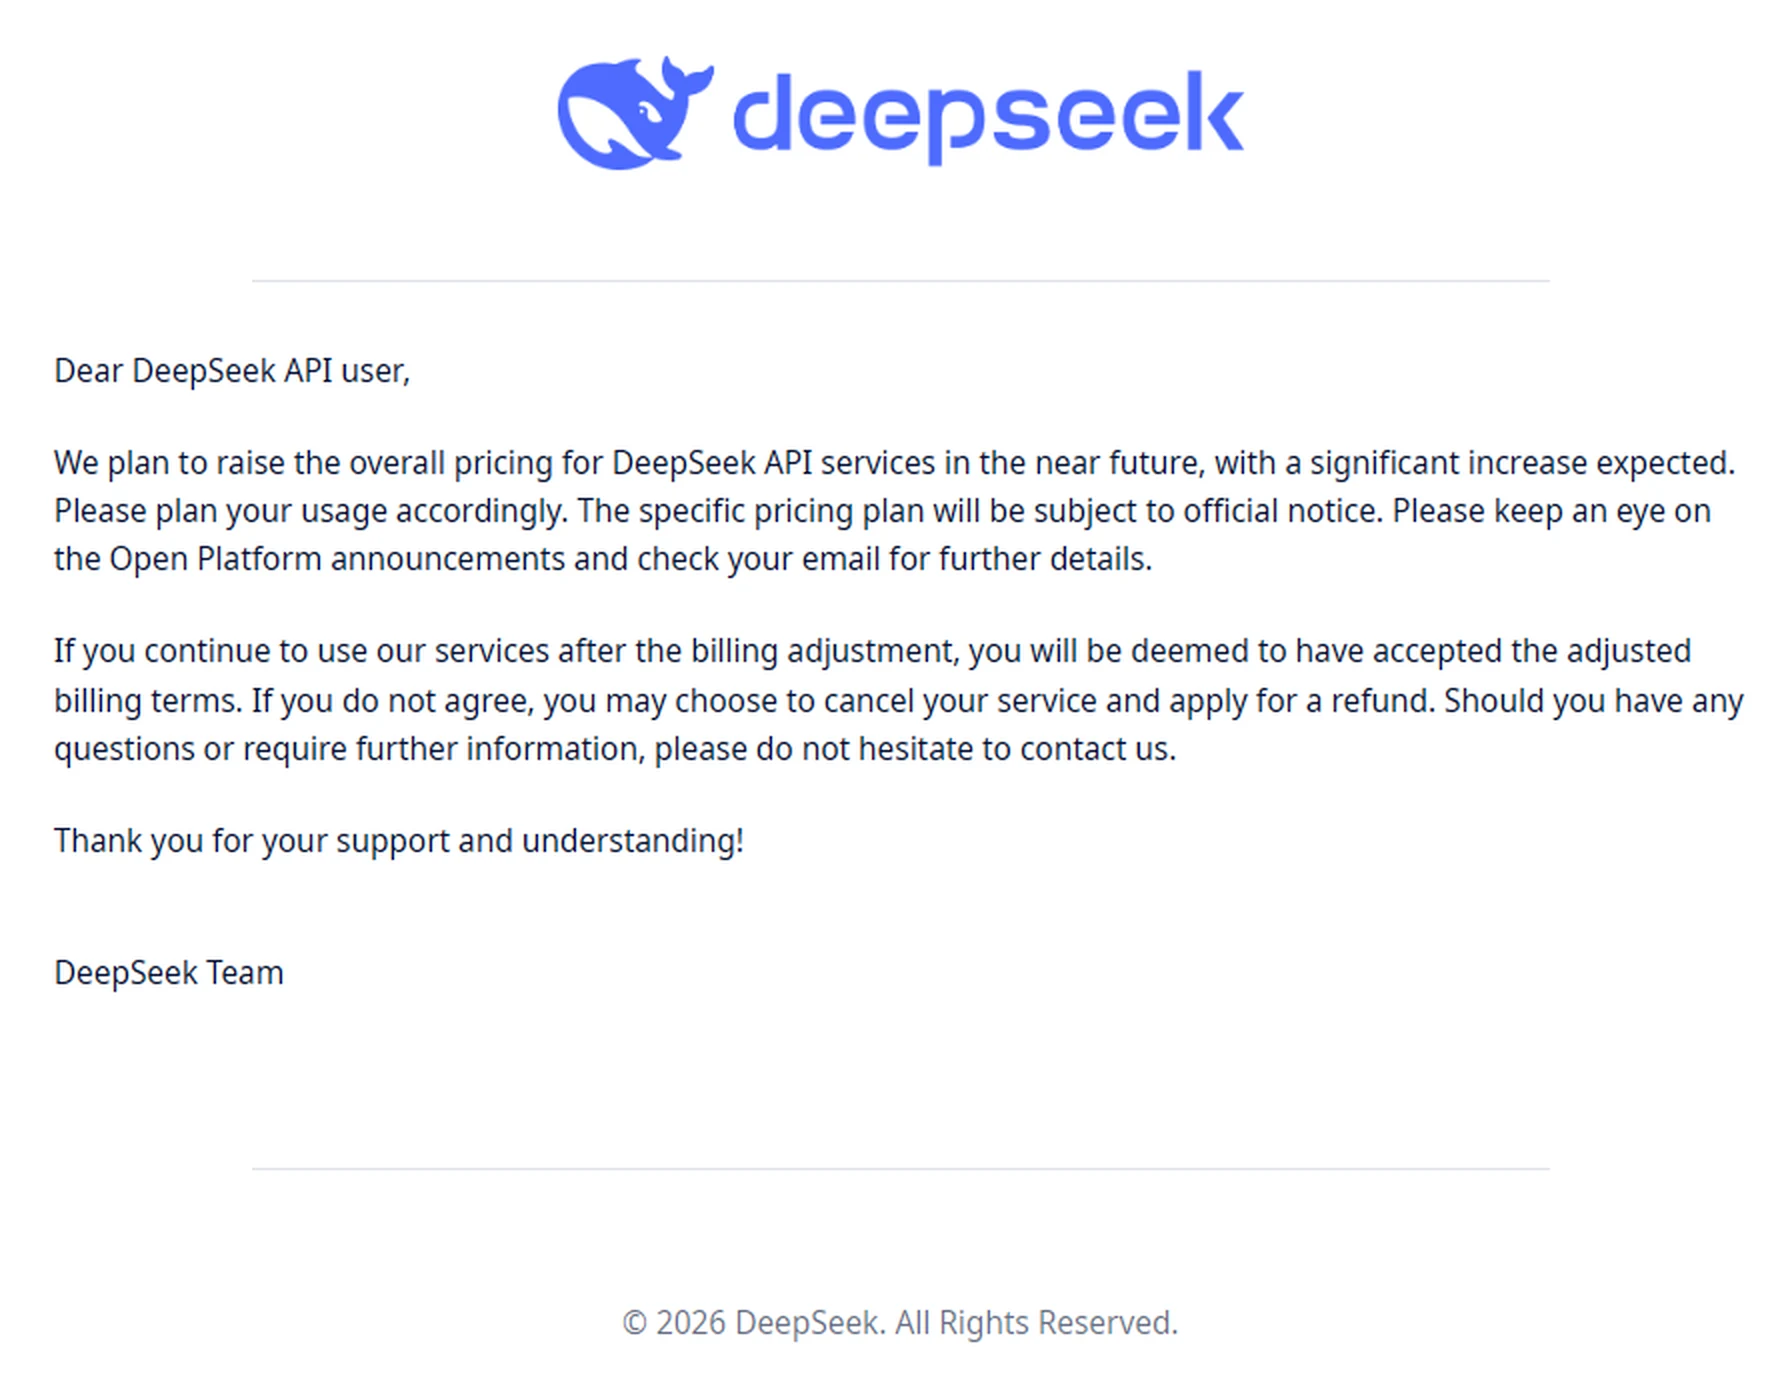
Le motif annoncé publiquement est assez ironique : le prix très bas a attiré tellement de monde que la plateforme sature et devient instable. DeepSeek est victime de son propre argument commercial.
Le timing intrigue aussi. Cinq jours après une mise à jour qui place son petit modèle devant son flagship. Six jours après la baisse de 80 % d’OpenAI.
Est-ce que ça invalide cet article ? Non. Et la raison est justement le cœur du sujet.
DeepSeek peut augmenter le prix de son API. DeepSeek ne peut pas augmenter le prix de son modèle.
— la conséquence d’une licence MIT
Les poids sont publiés. N’importe qui peut les héberger et les revendre au prix qu’il veut. Ce n’est pas une hypothèse : sur OpenRouter, l’alias qui pointe toujours vers la dernière version de la famille est affiché à 0,09 $ le million en entrée et 0,18 $ en sortie, soit environ 35 % sous le tarif officiel de DeepSeek.
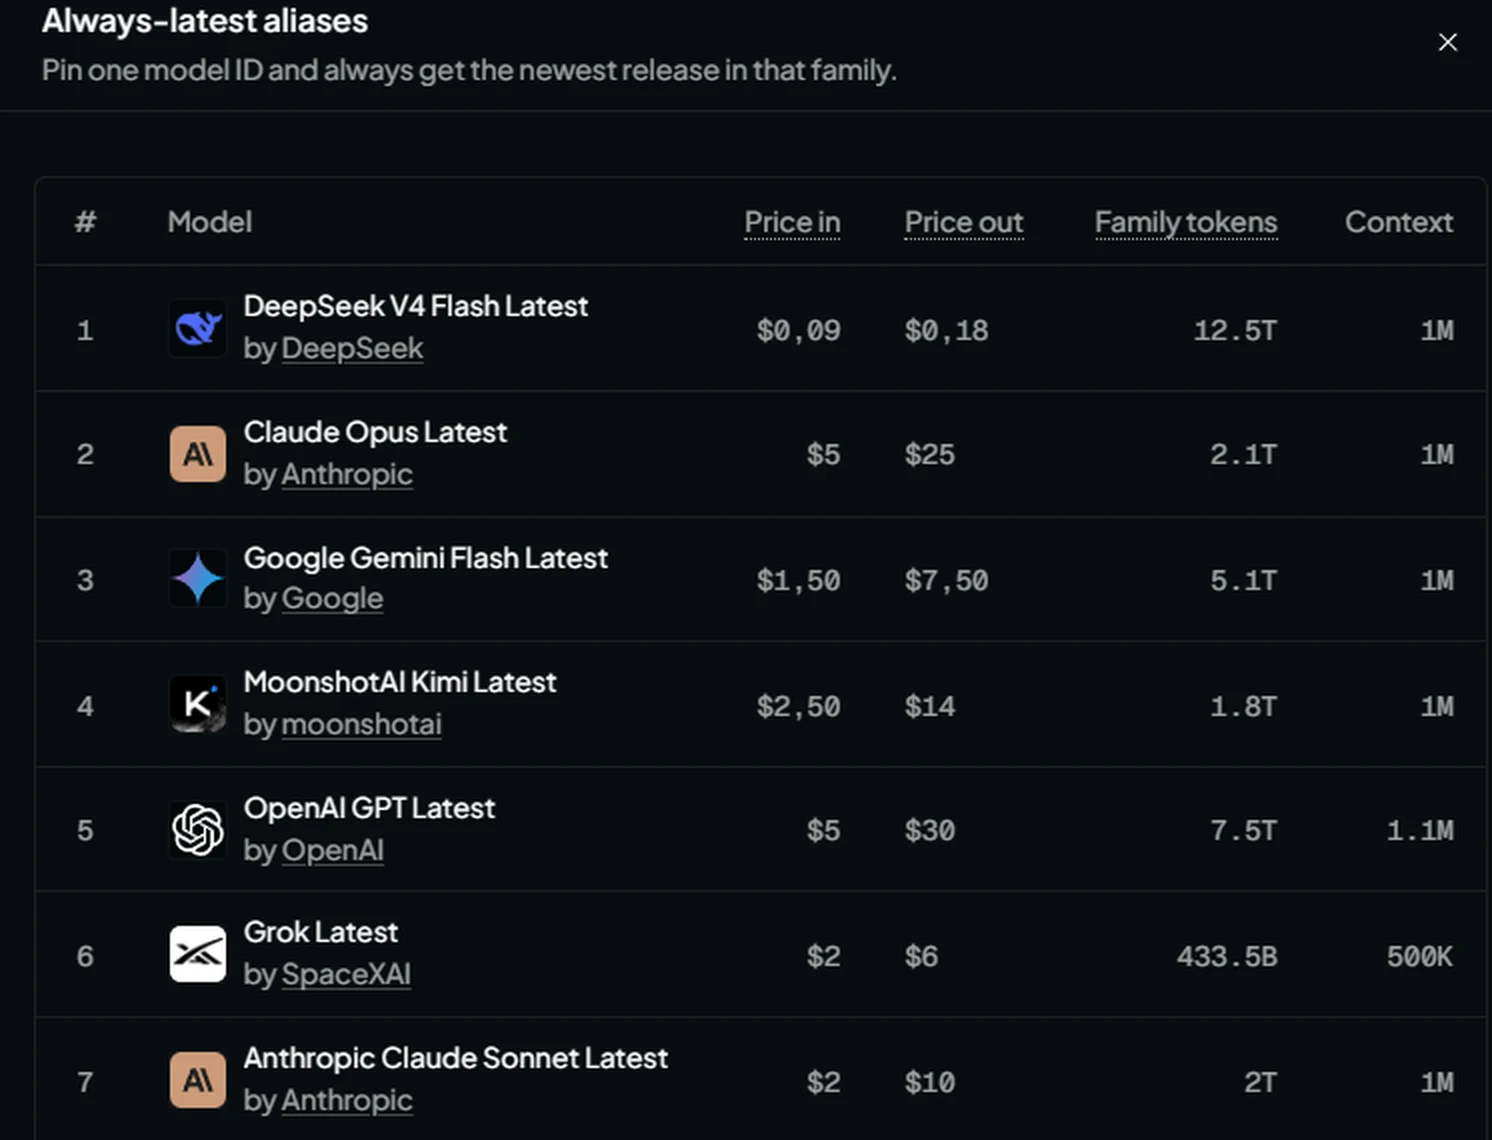
Le modèle est aussi le plus utilisé au monde sur la plateforme. Autrement dit, le laboratoire qui a fabriqué le modèle ne fixe déjà plus son prix. Si l’API officielle devient chère, le trafic part chez les autres hébergeurs.
Ce qu’il faut surveiller dans les prochaines semaines, ce n’est donc pas l’annonce de DeepSeek. C’est la réaction des fournisseurs sur OpenRouter. Mon hypothèse, et je l’assume comme telle : les prix n’y bougeront pas beaucoup, parce qu’aucun de ces hébergeurs n’a de raison de suivre la hausse d’un concurrent. Je mettrai cette section à jour si les faits me contredisent.
Traitez les 0,14 $ et 0,28 $ comme un prix du moment. DeepSeek avait déjà annoncé un tarif doublé sur deux créneaux quotidiens en heure de Pékin, sans jamais communiquer de date d’application. La bonne architecture n’est pas « je branche DeepSeek ». C’est « je branche V4 Flash, et je change d’hébergeur en modifiant une variable d’environnement ».
Ce que Flash fait bien, et ce qu’il ne fait pas
On lit souvent qu’un modèle comme celui-ci couvre 80 % des usages agentiques. Soyons honnêtes sur ce chiffre : c’est une estimation de terrain, pas une mesure. Aucune étude ne l’établit, et il ne faut pas le confondre avec les 80 % de startups open source qui font tourner un modèle chinois, qui est une statistique différente.
Ce qui est établi, c’est le mécanisme. Les charges agentiques sont dominées par des étapes répétitives et étroites. Parser un appel d’outil, extraire des données, classer, reformuler. Ces étapes n’ont pas besoin d’un modèle frontière.
La pratique qui s’impose en 2026 s’appelle le routage à étages. Un petit modèle traite la majorité des étapes et n’escalade vers un gros modèle que sur le raisonnement difficile. Les mesures publiées vont dans ce sens : environ 98 % de la qualité pour la moitié du coût chez Orq.ai, jusqu’à 85 % d’économie d’inférence selon IBM.
Ce que V4 Flash absorbe bien :
- les appels d’outils et le traitement de leurs retours ;
- l’extraction et la normalisation de données ;
- la classification et le routage de tickets ;
- la lecture et le résumé de logs ;
- la génération de tests et les correctifs localisés ;
- les boucles de reprise sur erreur ;
- la navigation dans un gros contexte.
Ce sur quoi je ne le mettrais pas :
- les choix d’architecture ;
- les refactorings qui touchent plusieurs modules ;
- le raisonnement juridique ou financier à enjeu ;
- tout ce dont une erreur coûte plus cher que dix mille appels de modèle.
D’où ma règle : routez par coût d’erreur, pas par difficulté perçue. Une tâche peut être simple et mériter le modèle le plus cher, parce qu’un faux positif se paie en incident client. Une autre peut sembler compliquée et très bien tourner sur Flash, parce que l’erreur est rattrapée à l’étape suivante.
Pour situer les modèles entre eux avant d’arbitrer, mon comparatif des LLM de coding 2026 donne le paysage général.
Les 24 heures du 30 au 31 juillet
Voici la chronologie du mois. Elle parle d’elle-même.
| Date | Événement |
|---|---|
| 7 juillet | CNBC documente que les modèles chinois captent jusqu’à 46 % des tokens entreprise américains sur OpenRouter |
| 9 juillet | OpenAI lance la famille GPT-5.6 : Sol, Terra, Luna |
| 24 juillet | Plus de 50 entreprises, dont Meta et Microsoft, signent une lettre contre l’interdiction des modèles open weight. Ni OpenAI ni Anthropic ne la signent |
| 29 juillet | Mark Zuckerberg déclare qu’interdire les modèles chinois n’est pas une solution efficace, et évoque un risque de capture réglementaire en citant OpenAI et Anthropic |
| 30 juillet | OpenAI baisse Luna de 80 % et Terra de 20 %. Sol ne bouge pas |
| 31 juillet | DeepSeek publie V4-Flash-0731 |
| 5 août | DeepSeek annonce une hausse « significative » de son API |
Rien ne permet d’affirmer qu’OpenAI a baissé ses prix à cause de DeepSeek. Ce qu’on peut dire, c’est que les deux décisions tombent à vingt-quatre heures d’écart, et qu’elles répondent à la même réalité de marché.
Un détail mérite l’attention. OpenAI n’a pas défendu Sol, il a défendu Luna. On ne baisse pas de 80 % le prix d’un modèle sorti trois semaines plus tôt par confort. Et on ne le fait pas sur le segment où l’on est tranquille. Le geste dit où se situe la pression : sur le volume d’étapes agentiques, pas sur le raisonnement de pointe.
La bascule est déjà faite
Le classement hebdomadaire d’OpenRouter du 27 juillet au 2 août est clair.
| Rang | Modèle | Tokens traités |
|---|---|---|
| 1 | DeepSeek V4 Flash | 7,22 T |
| 2 | Xiaomi MiMo-V2.5 | 5,1 T |
| 3 | Tencent Hunyuan Hy3 | 5,01 T |
| 4 | DeepSeek V4 Flash (autre fiche) | 3,45 T |
| 5 | GPT-5.6 Luna | 2,99 T |
Les quatre premières places sont chinoises. V4 Flash en occupe deux. Sur la semaine, les modèles chinois ont traité 28,13 trillions de tokens, soit la quatorzième semaine consécutive devant les modèles américains.
Une ligne mérite un arrêt. GPT-5.6 Luna bondit de 738 % en une semaine. La baisse du 30 juillet a marché tout de suite. C’est la meilleure confirmation possible : sur ce segment, le volume suit le prix, pas le benchmark.
Le reste du décor :
- les modèles chinois sont passés de moins de 2 % de la consommation de tokens fin 2024 à plus de 50 % en juin 2026 ;
- la part des modèles open weight sur OpenRouter est passée de 34 % en janvier à 65 % en juin ;
- sur la passerelle IA de Vercel, en juin, les modèles chinois ouverts représentaient 29 % des tokens pour moins de 4 % de la dépense ;
- Flo Crivello, fondateur de Lindy, a basculé 100 % de son trafic vers DeepSeek V4 en juin ;
- Martin Casado, chez Andreessen Horowitz, estime qu’environ 80 % des startups sur stack IA open source font tourner un modèle chinois.
Ce que ça fait aux marges
OpenAI tourne autour de 25 milliards de dollars de revenus annualisés, pour une marge brute estimée à 33 %. Anthropic a vu sa marge d’inférence passer de 38 % à plus de 70 % en 2026, portée par Claude Code.
Le problème n’est pas passager, il est structurel. Dès que n’importe qui peut héberger un modèle, plus personne n’en contrôle le prix. L’inférence tend vers le coût du matériel.
Et cette règle ne fait pas d’exception. Elle s’applique aussi à DeepSeek, qui vient de l’apprendre en direct : le laboratoire annonce une hausse pendant que d’autres vendent son modèle un tiers moins cher. Publier ses poids en MIT, c’est gagner l’adoption et perdre le contrôle du prix.
C’est aussi la meilleure grille de lecture pour la sortie de Zuckerberg. Sans lui prêter d’intention, on peut constater deux choses. Une entreprise qui a bâti sa stratégie sur les modèles ouverts n’a pas intérêt à ce que le marché se referme. Et les deux acteurs qui n’ont pas signé la lettre du 24 juillet sont ceux qui opèrent les modèles fermés dominants.
Pour une entreprise française, la conséquence est simple. Votre pouvoir de négociation vient d’augmenter, même si vous ne changez pas de fournisseur. Avoir une alternative crédible et testée change la conversation contractuelle.
Le point conformité
Il faut poser la réserve, et elle est sérieuse.
L’API hébergée par DeepSeek stocke les données sur des serveurs en Chine. Les autorités européennes s’en sont saisies. L’Italie a bloqué l’accès fin janvier 2025. La Belgique a ouvert une enquête. La CNIL a annoncé une analyse des outils DeepSeek. Les griefs portent sur la base légale, la durée de conservation, l’identification des sous-traitants et l’absence de représentant dans l’Union.
Pour une entreprise française qui traite des données clients, brancher un agent de production sur l’API publique DeepSeek n’est pas raisonnable.
Mais les poids sont sous licence MIT. Vous pouvez les télécharger, les héberger, les modifier et les exploiter commercialement. Le modèle et le service sont deux choses différentes : seul le service pose un problème de résidence.
Trois voies, par coût d’infrastructure croissant :
- L’API DeepSeek, pour prototyper et mesurer sur des données non sensibles. Rapide, presque gratuit, à exclure en production sur données clients.
- Une inférence opérée dans l’Union européenne. Plusieurs fournisseurs proposent V4 Flash sur des GPU en Europe, avec DPA, liste de sous-traitants publiée et pas d’exposition au CLOUD Act. Les ordres de grandeur relevés vont de 0,10 € en entrée et 0,20 € en sortie pour une offre dédiée, jusqu’à 1,20 € et 3,40 € pour un routeur mutualisé. Vérifiez ces grilles au moment de décider : elles bougent vite.
- L’auto-hébergement. 150 à 190 Go en 4 bits, un nœud H100 ou H200. Un vrai coût d’entrée, un contrôle total, et un amortissement rapide au-delà d’un certain volume.
Le prix chinois sans le risque chinois est atteignable. Mais il se paie en travail d’infrastructure, pas en clé d’API. C’est le même arbitrage que celui que je décris dans ne choisissez pas un modèle, choisissez une stratégie.
Par où commencer
Cinq étapes, dans l’ordre.
1. Instrumentez avant de migrer. Mesurez votre coût par tâche terminée, pas par token. Sans cette mesure, vous ne saurez jamais si un changement de modèle vous a fait gagner ou perdre de l’argent. La plupart des équipes n’ont pas ce chiffre.
2. Repérez vos trois boucles les plus bavardes. Dans presque toutes les architectures d’agents que je vois, deux ou trois boucles concentrent l’essentiel de la dépense. Souvent des étapes de reformulation ou de reprise que personne n’a relues depuis leur écriture.
3. Rejouez ces boucles sur V4 Flash, avec le même harness. C’est la condition d’une comparaison honnête, puisque DeepSeek reconnaît elle-même la sensibilité au harness. Comparez trois choses : taux de réussite, coût, latence de bout en bout.
4. Routez ce qui passe, gardez le gros modèle pour le reste. Ne cherchez pas à tout basculer. Le but n’est pas de quitter votre fournisseur. Il est d’arrêter de payer le tarif du raisonnement de pointe pour du parsing d’appels d’outils.
5. Choisissez l’hébergement selon la sensibilité des données. Cette décision se prend avec le DPO, pas seulement avec l’équipe technique.
Et surtout, ne vous attachez à aucun fournisseur. Le nom du modèle et l’URL de l’endpoint doivent être des variables de configuration, jamais des constantes dans le code. V4 Flash étant servi par plusieurs hébergeurs via une API compatible OpenAI, changer de fournisseur doit rester un changement de variables d’environnement :
import os
from openai import OpenAI

# Changer d'hébergeur = changer ces trois variables, jamais le code.
#   LLM_BASE_URL=https://api.deepseek.com          LLM_MODEL=deepseek-v4-flash
#   LLM_BASE_URL=https://openrouter.ai/api/v1      LLM_MODEL=deepseek/deepseek-v4-flash
#   LLM_BASE_URL=http://mon-noeud-h200:8000/v1     LLM_MODEL=DeepSeek-V4-Flash  (vLLM)

client = OpenAI(
    base_url=os.environ["LLM_BASE_URL"],
    api_key=os.environ["LLM_API_KEY"],
)

resp = client.chat.completions.create(
    model=os.environ["LLM_MODEL"],
    messages=[
        {"role": "system", "content": "Tu extrais des donnees structurees. Reponds en JSON strict."},
        {"role": "user", "content": "Ticket 4821 : la synchro Fabric echoue depuis 03h12, code 429."},
    ],
    temperature=0,
)

usage = resp.usage
print(resp.choices[0].message.content)
# Le poste a suivre n'est pas le prix affiche, c'est le cout par tache terminee.
print(f"in={usage.prompt_tokens} out={usage.completion_tokens}")
Le compteur de tokens en fin de script n’est pas décoratif. C’est le point de départ de l’étape 1 : sans mesure par tâche, la comparaison entre deux modèles reste une opinion.
Mon avis
Le débat sur les modèles chinois masque le vrai basculement. La question n’est plus de savoir qui fabrique le modèle le plus intelligent. Sur ce terrain, l’écart entre le sommet et le milieu de gamme se resserre chaque trimestre. La question est de savoir combien coûte une tâche terminée.
Fin juillet, quelque chose a changé. Un modèle à 13 milliards de paramètres actifs atteint un bon niveau agentique pour trois centimes par tâche. Un laboratoire américain baisse de 80 % le prix de son entrée de gamme la veille. Et plus de la moitié des tokens consommés dans le monde viennent de modèles chinois ouverts.
Cinq jours plus tard, DeepSeek annonce qu’il augmente ses prix, sans pouvoir empêcher que son propre modèle continue d’être vendu un tiers moins cher ailleurs. C’est sans doute la leçon la plus durable de cet épisode. Une fois les poids publiés, aucun laboratoire ne reprend la main sur le prix, pas même celui qui les a entraînés.
Mon conseil : testez V4 Flash cette semaine sur un cas non sensible, mesurez le coût par tâche, et gardez une architecture capable de changer d’hébergeur. La question à poser en réunion n’est plus « quel est le meilleur modèle ». C’est « quel est le modèle le moins cher qui passe mes tests, et est-ce que je peux en changer la semaine prochaine ».
Mise à jour du 22 août 2026. DeepSeek vient aussi de combler le principal trou de sa gamme API avec V4 Flash Vision Exp, sa nouvelle variante multimodale pour les agents.
Sources
- DeepSeek — annonce GA de V4 Flash et benchmarks agent.
- DeepSeek API Docs — modèles et tarifs officiels.
- Artificial Analysis — fiche DeepSeek V4 Flash, coût par tâche et Intelligence Index.
- vLLM Recipes — 284 B paramètres, 13 B actifs, contexte 1 M.
- MarkTechPost — gains agentiques de la version 0731.
- Bloomberg — DeepSeek prévoit une hausse significative de ses tarifs.
- TechNode — hausse annoncée des tarifs de l’API DeepSeek.
- TechNode — V4 Flash en tête du classement hebdomadaire OpenRouter.
- OpenRouter — fiche de l’alias DeepSeek V4 Flash Latest.
- CNBC — OpenAI baisse le prix de deux modèles GPT-5.6 (30 juillet 2026).
- VentureBeat — guerre des prix, la compétition bascule vers le coût.
- CNBC — les modèles chinois gagnent du terrain chez les entreprises américaines.
- Forbes — la chute du coût du token et la compression des marges.
- TNW — Zuckerberg contre le blocage des modèles chinois (29 juillet 2026).
- Euractiv — DeepSeek et les autorités européennes de protection des données.
- CNPD Luxembourg — recommandations sur DeepSeek.