Le M5 Max 128 Go est déjà une excellente porte d'entrée pour les modèles denses de 27 à 70B et les MoE compacts. Le M5 Ultra 256 Go change réellement de catégorie. Il peut accueillir des quantifications adaptées de Qwen3.8-Flash-Next, DeepSeek V4 Flash ou GLM-5.3 Flash, conserver une marge pour le contexte et servir un agent comme Hermes depuis une seule machine.
Le prix ne s'amortit pas rapidement face à un abonnement cloud utilisé occasionnellement. La logique devient solide lorsque l'on valorise la confidentialité, la capacité garantie, l'absence de facture au token, le travail hors ligne et la maîtrise de la chaîne.
Ce qu'Apple vient réellement de lancer
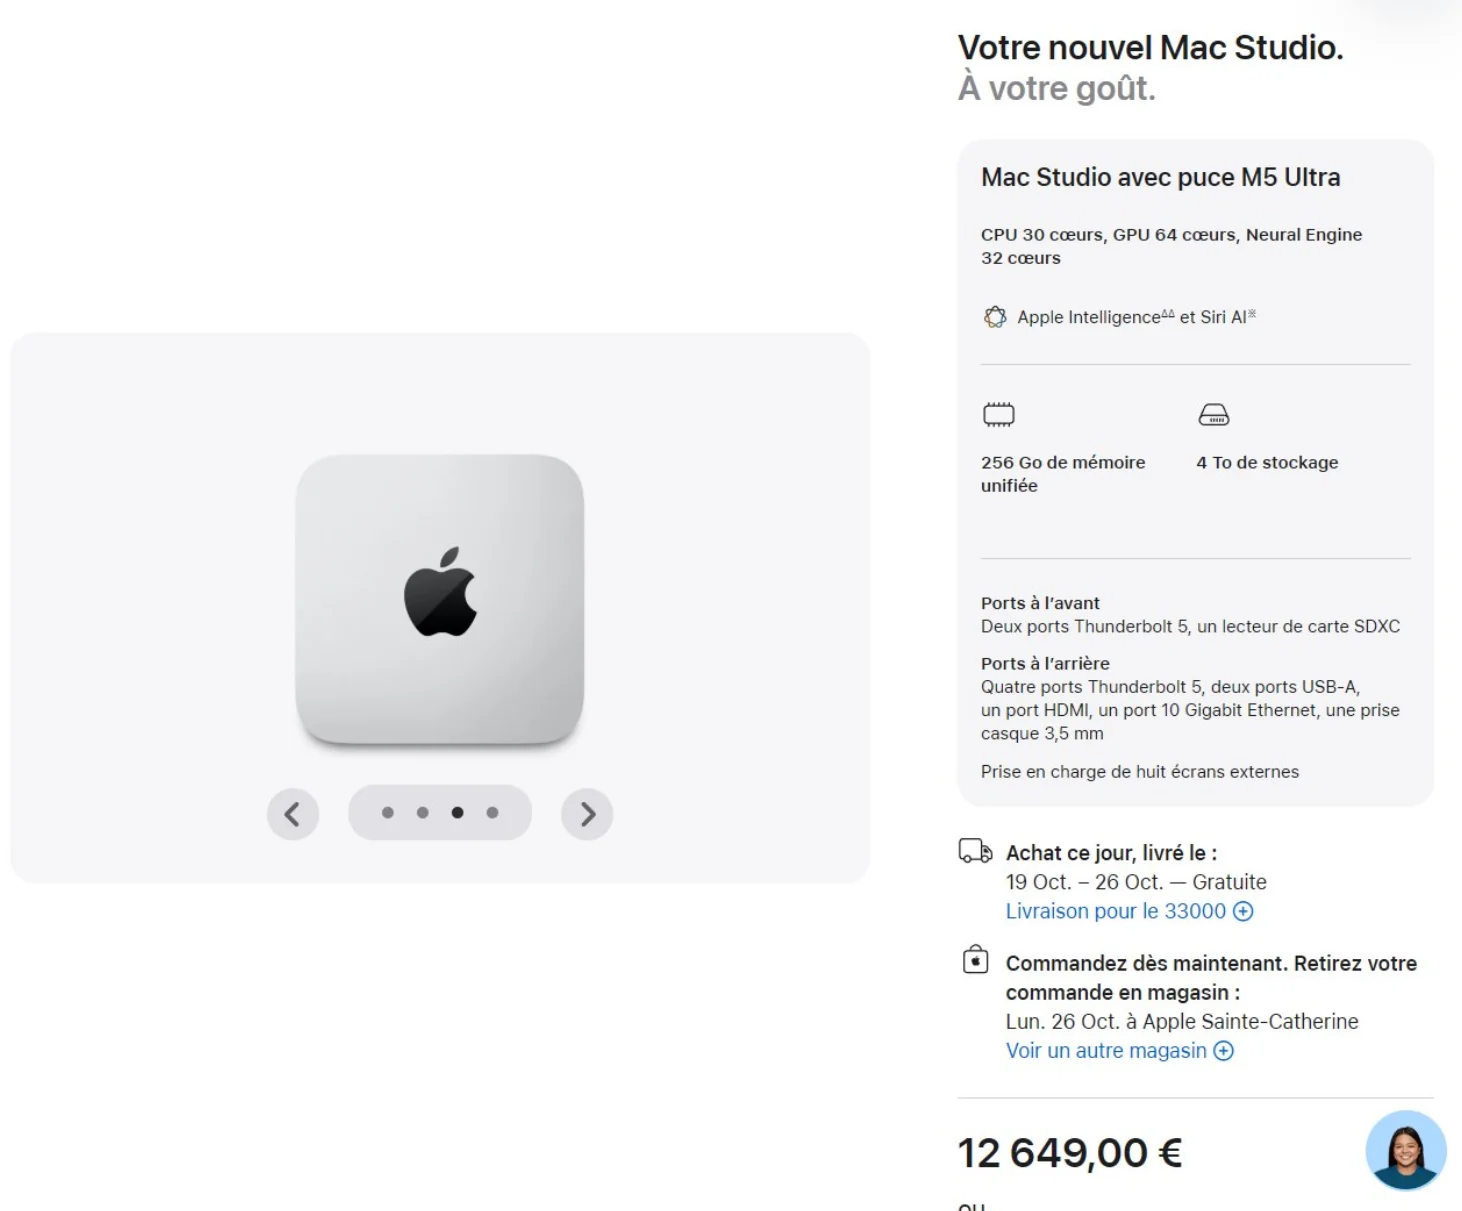
Apple a ouvert les précommandes le 25 août 2026. Les premières livraisons sont annoncées à partir du 22 septembre, tandis que l'option 512 Go doit arriver fin octobre. La configuration observée le 2 septembre associe un M5 Ultra à 30 cœurs CPU, 64 cœurs GPU, 256 Go de mémoire unifiée et 4 To de stockage pour 12 649 € TTC. Le délai affiché allait alors du 19 au 26 octobre pour Bordeaux.
Le M5 Max monte jusqu'à 128 Go et 614 Go/s. Le M5 Ultra propose 256 ou 512 Go avec 1,2 To/s. Passer de 256 à 512 Go augmente la capacité, pas la bande passante. Le choix dépend donc d'abord de la taille des poids, du cache KV et du nombre de modèles à garder en mémoire.
| Configuration | Mémoire maximale | Bande passante | Positionnement IA locale |
|---|---|---|---|
| Mac Studio M5 Max | 128 Go | jusqu'à 614 Go/s | 27B à 70B, petits et moyens MoE |
| Mac Studio M5 Ultra | 256 ou 512 Go | 1,2 To/s | gros MoE, plusieurs modèles, contexte long |
| Mac Studio M3 Ultra | 256 ou 512 Go | plus de 800 Go/s | toujours une référence très puissante pour les très gros modèles |
| NVIDIA DGX Spark | 128 Go | 273 Go/s | CUDA, modèles jusqu'à 200B selon NVIDIA |
Apple annonce jusqu'à quatre fois plus de traitement du prompt dans LM Studio face au M3 Ultra. Ce résultat vient de son propre protocole et ne doit pas être confondu avec une multiplication par quatre du débit de génération. Le décodage reste très dépendant du modèle, du quant, du contexte et du moteur.
Pourquoi 128 Go est déjà sérieux
Sur un GPU classique, la VRAM est une frontière dure. Une carte de 24 ou 32 Go ne peut pas exploiter les centaines de gigaoctets de RAM système comme si elles étaient de la VRAM locale. Les transferts et l'offload pénalisent rapidement le débit.
Apple Silicon utilise une mémoire unifiée accessible au CPU et au GPU. MLX s'appuie directement sur ce modèle et évite de dupliquer inutilement les données. Cela ne rend pas la mémoire infinie, mais cela permet d'affecter une part très importante des 128 Go aux poids du modèle et au cache.
Une configuration 128 Go est adaptée à plusieurs usages durables.
- Un modèle dense de 27B ou 32B peut tourner avec une quantification confortable et un débit très fluide.
- Un 70B en 4 bits tient largement, avec une marge pour le contexte et les outils.
- Les MoE compacts tels que Qwen3.8-Flash-Next peuvent devenir très rapides, car seuls quelques milliards de paramètres sont activés par token.
- Deux modèles plus petits peuvent rester chargés, par exemple un modèle principal et un modèle rapide pour le routage ou la vision.
La limite apparaît lorsque les poids quantifiés approchent 100 à 120 Go. macOS, le runtime, le contexte et les buffers ont aussi besoin de mémoire. Acheter 128 Go pour un fichier de poids annoncé à 125 Go revient donc à travailler sans marge.
Cela ne rend pas la version 128 Go inutile, loin de là. DeepSeek V4 Flash illustre bien ce point. Le modèle compte 284B de paramètres au total, mais seulement 13B actifs par token. Des quantifications très compactes peuvent entrer dans 128 Go avec un runtime compatible, un contexte raisonnable et une marge soigneusement surveillée. Il faut accepter davantage de compromis sur la précision ou le cache qu'avec 256 Go, mais on conserve déjà un modèle local très solide pour le code et l'agentique.
Garder 128 Go en local et louer les pointes
Rien n'oblige non plus à dimensionner la machine pour le cas le plus rare. Une station 128 Go peut traiter le quotidien en local, puis louer ponctuellement un GPU européen pour une quantification plus lourde, un long contexte ou un traitement par lots.
Scaleway affiche en région parisienne un L40S à partir de 1,46 € par GPU et par heure hors taxes, et un H100 PCIe autour de 2,86 €. Nebius publie pour sa région européenne un L40S à 1,35 $ par heure, auquel s'ajoutent CPU et RAM, et un H100 à 2,95 $. Selon la machine et les ressources annexes, retenir un ordre de grandeur proche de 2 € par heure pour un besoin ponctuel est donc raisonnable. Un H100 ou une configuration multi-GPU coûtera davantage.
Cette approche hybride évite d'immobiliser plusieurs milliers d'euros dans de la mémoire utilisée quelques heures par mois. Scaleway opère notamment à Paris et Varsovie. Nebius propose des capacités européennes en Finlande et développe aussi son infrastructure en France. Pour parler réellement de souveraineté européenne, il faut néanmoins sélectionner une région UE, conserver le stockage et les journaux dans cette région, contrôler les accès et vérifier le cadre contractuel. Une location européenne réduit la dépendance, sans offrir exactement le même niveau de maîtrise qu'une machine coupée du cloud.
Pourquoi 256 Go change de catégorie
Avec 256 Go, on ne double pas seulement une fiche technique. On ouvre une classe de modèles qui ne tient pas proprement sur une machine 128 Go.
Après le système, MLX ou llama.cpp, les buffers et le cache KV, il est prudent de viser moins de 220 à 240 Go de poids résidents. La marge exacte varie avec le runtime et le contexte. Cela suffit néanmoins à accueillir des quantifications 3 ou 4 bits de plusieurs modèles MoE de premier plan.
| Modèle | Architecture publiée | Lecture réaliste sur 256 Go |
|---|---|---|
| Qwen3.8-Flash-Next | 125B, 6B actifs, plus embeddings et MTP | Très bon candidat dans une quantification adaptée |
| DeepSeek V4 Flash | 284B, 13B actifs | La Q4 communautaire peut tenir avec une marge mesurée |
| GLM-5.3 Flash | 320B, 18B actifs | Q3 ou Q4 envisageable, 8 bits plutôt réservé à 512 Go |
| Modèle dense 70B | 70B actifs | Peut même être chargé en précision élevée selon le format |
| DeepSeek V3/R1 671B | 671B total | 256 Go impose une quantification très agressive, 512 Go est plus cohérent |
Apple a montré dès 2025 un modèle DeepSeek de 670 milliards de paramètres quantifié à 4,5 bits sur un M3 Ultra 512 Go. Les poids occupaient environ 380 Go. Cette démonstration donne une règle simple. Le 256 Go vise les MoE modernes de 125 à 320B et les denses plus petits. Le 512 Go vise les familles proches de 670B avec une quantification plus saine.
Le MoE rend cette machine beaucoup plus intéressante
Un Mixture-of-Experts possède beaucoup de paramètres au total, mais n'en active qu'une fraction à chaque token. Les poids complets doivent rester accessibles, d'où le besoin de capacité. Le calcul et les lectures les plus intenses portent surtout sur les experts sélectionnés, d'où l'importance de la bande passante et d'un runtime capable d'éviter les déplacements inutiles.
Qwen3.8-Flash-Next annonce 125B de paramètres pour 6B actifs. DeepSeek V4 Flash annonce 284B pour 13B actifs. GLM-5.3 Flash annonce 320B pour 18B actifs. Ces architectures sont précisément celles qui transforment 256 Go de mémoire unifiée en outil concret plutôt qu'en luxe théorique.
Il reste un piège. Un nombre faible de paramètres actifs ne garantit pas un bon débit. Le routage des experts, la disposition des poids, le préremplissage, l'attention, le cache KV et la maturité des kernels Metal comptent énormément. Il faut donc tester un modèle, une quantification et un contexte précis avant tout achat professionnel.
Peut-on vraiment viser 30 à 50 tokens par seconde
Les premiers retours communautaires recoupés sur les puces M5 montrent déjà DeepSeek V4 Flash autour de 30 à 40 tokens par seconde sur certaines recettes M5 Max 128 Go. Des résultats plus faibles apparaissent avec llama.cpp standard et des contextes longs. D'autres moteurs spécialisés gagnent beaucoup sur le préremplissage.
Les 30 à 50+ tok/s évoqués dans mon premier retour doivent donc être lus comme un ordre de grandeur atteignable sur des modèles et quantifications bien choisis, pas comme une garantie du M5 Ultra pour tous les MoE. Aucun benchmark public, reproductible et suffisamment large ne permet encore de donner un chiffre unique à cette nouvelle machine.
La bonne nouvelle se trouve ailleurs. Un débit de 20 à 40 tok/s sur un modèle agentique solide est déjà très confortable pour du code, de la recherche ou un agent qui appelle des outils. Le temps total dépend souvent davantage des commandes, des tests, du navigateur et des API que du seul débit de décodage.
Une alternative à plusieurs DGX Spark
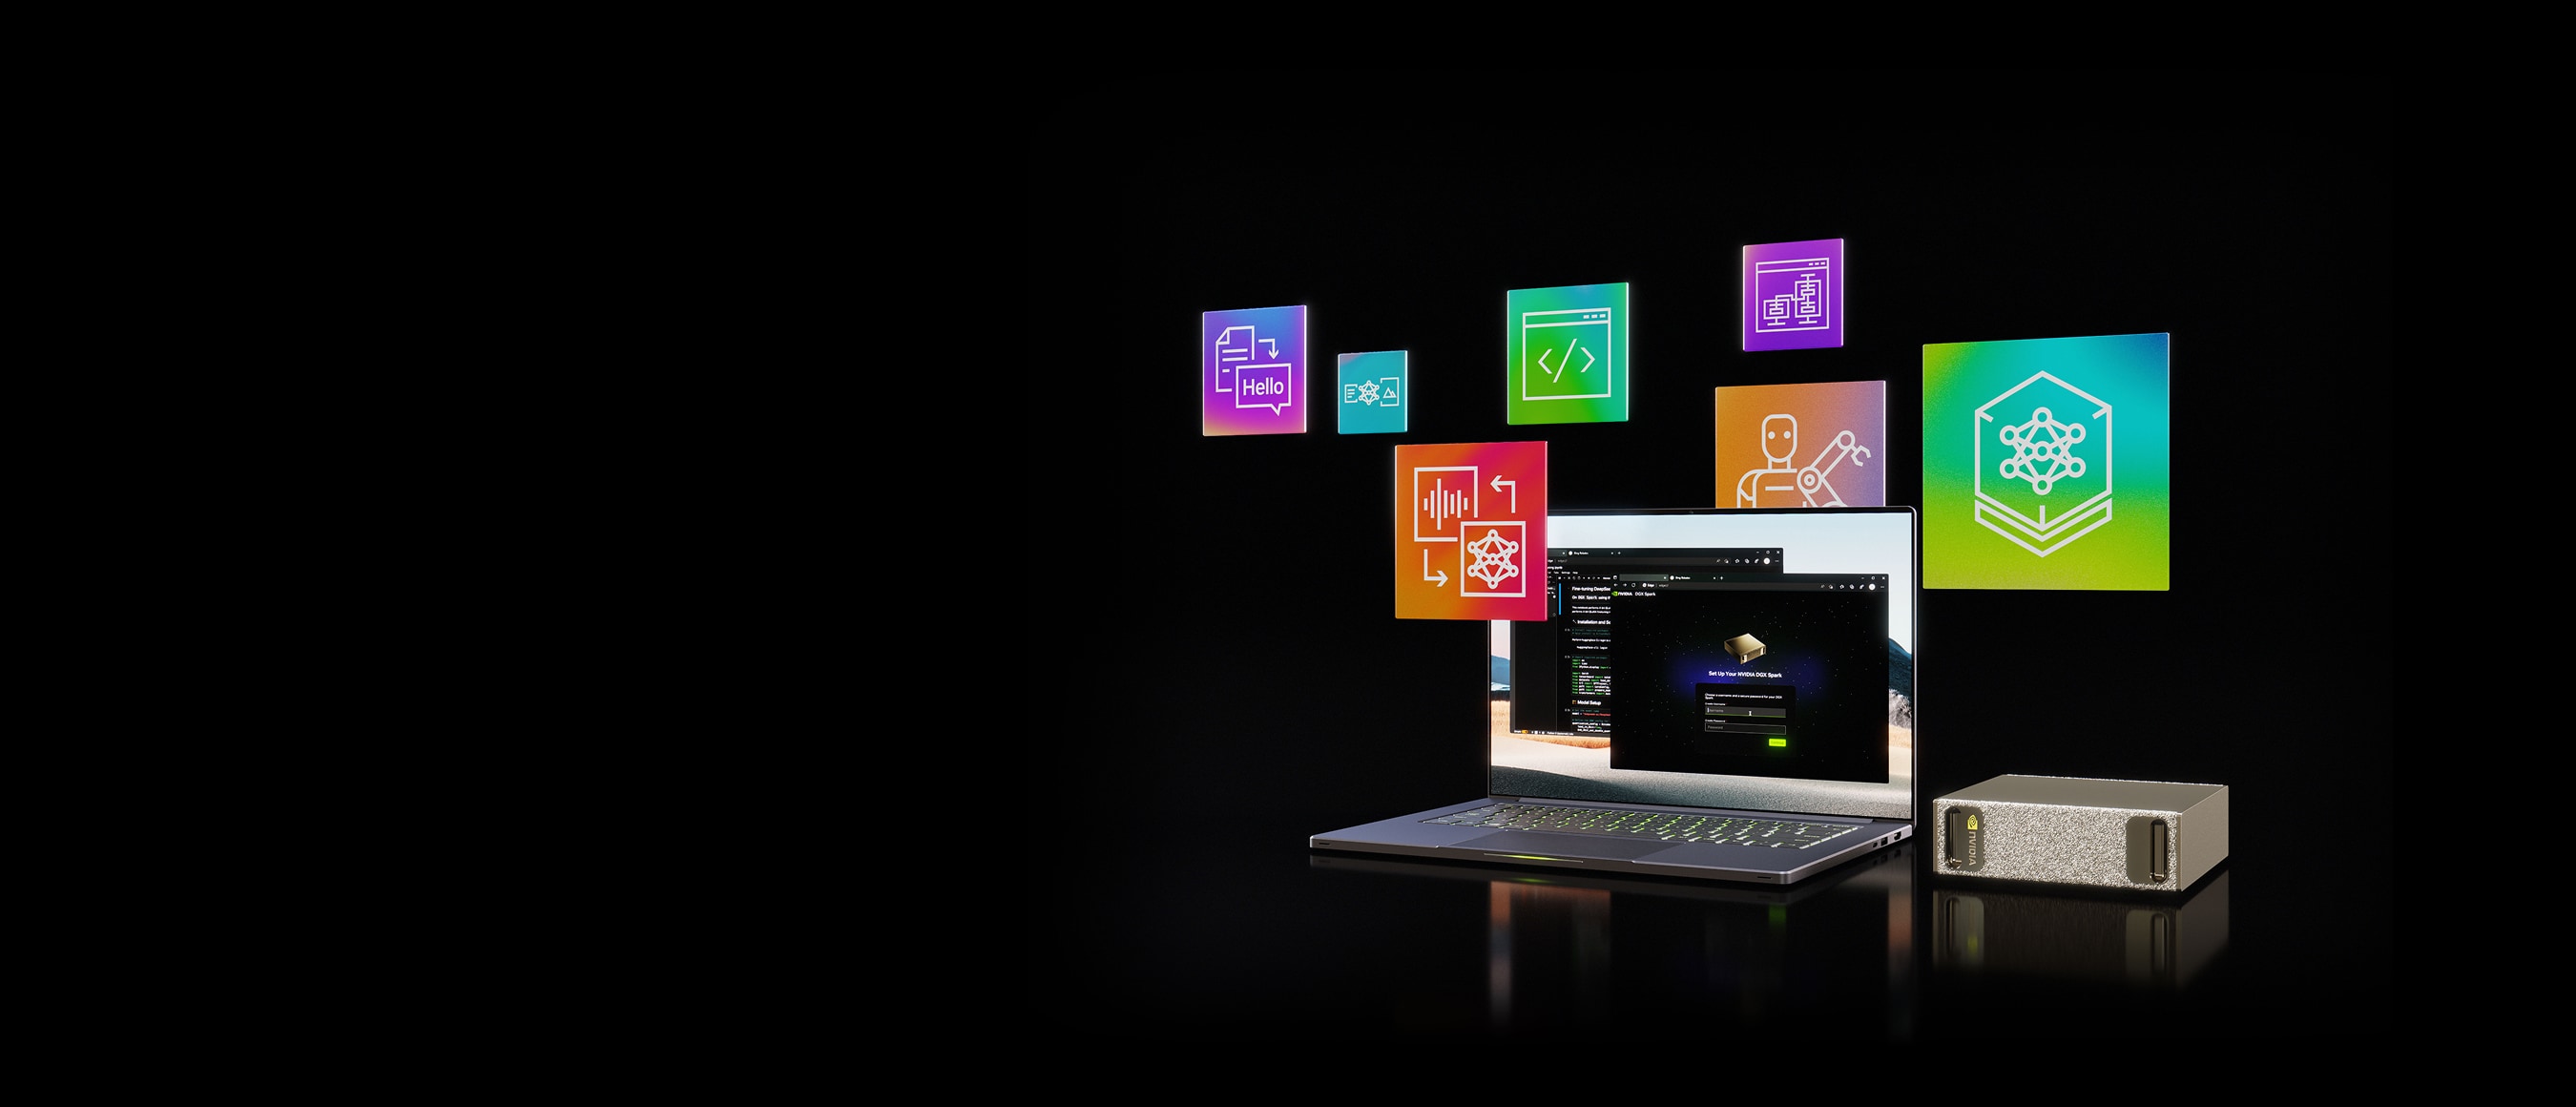
Un DGX Spark offre 128 Go à 273 Go/s, 4 To de stockage, un SoC GB10 de 140 W et surtout CUDA. NVIDIA documente les modèles jusqu'à 200B sur une machine et jusqu'à 405B sur deux unités reliées. Deux Spark apportent donc 256 Go agrégés, soit la même capacité brute que le Mac Studio présenté ici, mais pas un pool mémoire aussi simple qu'une seule machine. Le placement des poids, la communication et la prise en charge du moteur deviennent des sujets d'exploitation.
Le prix rend la comparaison beaucoup plus intéressante. Le 2 septembre, LDLC affichait le DGX Spark 4 To à 6 099,95 €, avec une disponibilité annoncée à plus de quinze jours. D'autres offres européennes approchaient 6 999 €. Il faut donc compter environ 6 100 à 7 000 € par unité, avec une disponibilité encore irrégulière.
| Solution | Capacité mémoire | Bande passante publiée | Stockage | Prix observé ou estimé |
|---|---|---|---|---|
| Mac Studio M5 Ultra 256 Go | 256 Go sur un seul nœud | 1,2 To/s | 4 To | 12 649 € |
| Deux DGX Spark | 2 × 128 Go agrégés | 273 Go/s par nœud | 2 × 4 To | environ 12 200 à 14 000 € |
| Mac Studio M5 Ultra 512 Go | 512 Go sur un seul nœud | 1,2 To/s | 4 To dans cette projection | prix non annoncé, autour de 20 000 € selon mon estimation |
| Quatre DGX Spark | 4 × 128 Go agrégés | 273 Go/s par nœud | 4 × 4 To | environ 24 400 à 28 000 € |
L'équivalence porte ici sur la capacité mémoire, pas sur les performances. Deux ou quatre Spark ne forment pas magiquement une mémoire unifiée de 256 ou 512 Go. Il faut distribuer le modèle et les échanges entre les machines. À l'inverse, le Mac garde les poids, le cache et les runtimes dans un seul espace mémoire. Il devient ainsi particulièrement pratique pour l'inférence personnelle, le développement et les agents locaux.
Le Mac Studio M5 Ultra 256 Go concentre la capacité dans un seul système. Sa bande passante publiée est plus de quatre fois supérieure à celle d'un Spark pris isolément. Cette comparaison ne signifie pas qu'il est quatre fois plus rapide. Les Tensor Cores, CUDA, TensorRT-LLM, le batching et les kernels NVIDIA peuvent donner l'avantage au Spark sur de nombreux workloads.
NVIDIA conserve en effet un avantage logiciel majeur. Les pilotes, DGX OS, CUDA, cuDNN, TensorRT-LLM et NIM forment une pile extrêmement optimisée et largement adoptée. Les Tensor Cores Blackwell de cinquième génération prennent en charge le NVFP4. NVIDIA annonce jusqu'à 1 pétaFLOP FP4 avec sparsité sur le Spark, et fournit ses propres outils pour quantifier puis déployer les modèles dans ce format. Ce niveau d'intégration reste difficile à égaler dès qu'un projet dépend déjà de CUDA ou cherche un débit de service très optimisé.
Le Mac a néanmoins de moins en moins à lui envier pour l'usage qui nous intéresse ici. MLX progresse, la mémoire unifiée évite une partie des transferts, et 1,2 To/s permet d'alimenter de très gros modèles depuis une seule machine. Le Spark garde l'écosystème le plus mature. Le Mac gagne en capacité par nœud, en simplicité et, dans cette comparaison tarifaire, en valeur utile.
La version 512 Go sera donc à surveiller de très près. Apple confirme son arrivée fin octobre, mais ne publie pas encore son tarif français. Mon estimation la place autour de 20 000 € avec 4 To. Ce n'est pas un prix officiel. Même à ce niveau, elle offrirait sur un seul nœud la capacité brute de quatre DGX Spark, dont le coût actuel se situerait plutôt entre 24 400 et 28 000 €. Pour les gros MoE, l'écart de valeur peut devenir encore plus favorable au Mac.
Le Mac devient rationnel lorsque le problème principal est de faire tenir un gros modèle avec le moins de complexité possible. Le Spark reste souvent préférable lorsque l'application dépend de CUDA, doit servir beaucoup d'utilisateurs en parallèle ou nécessite une pile NVIDIA déjà validée.
Et face à un rig de huit GPU
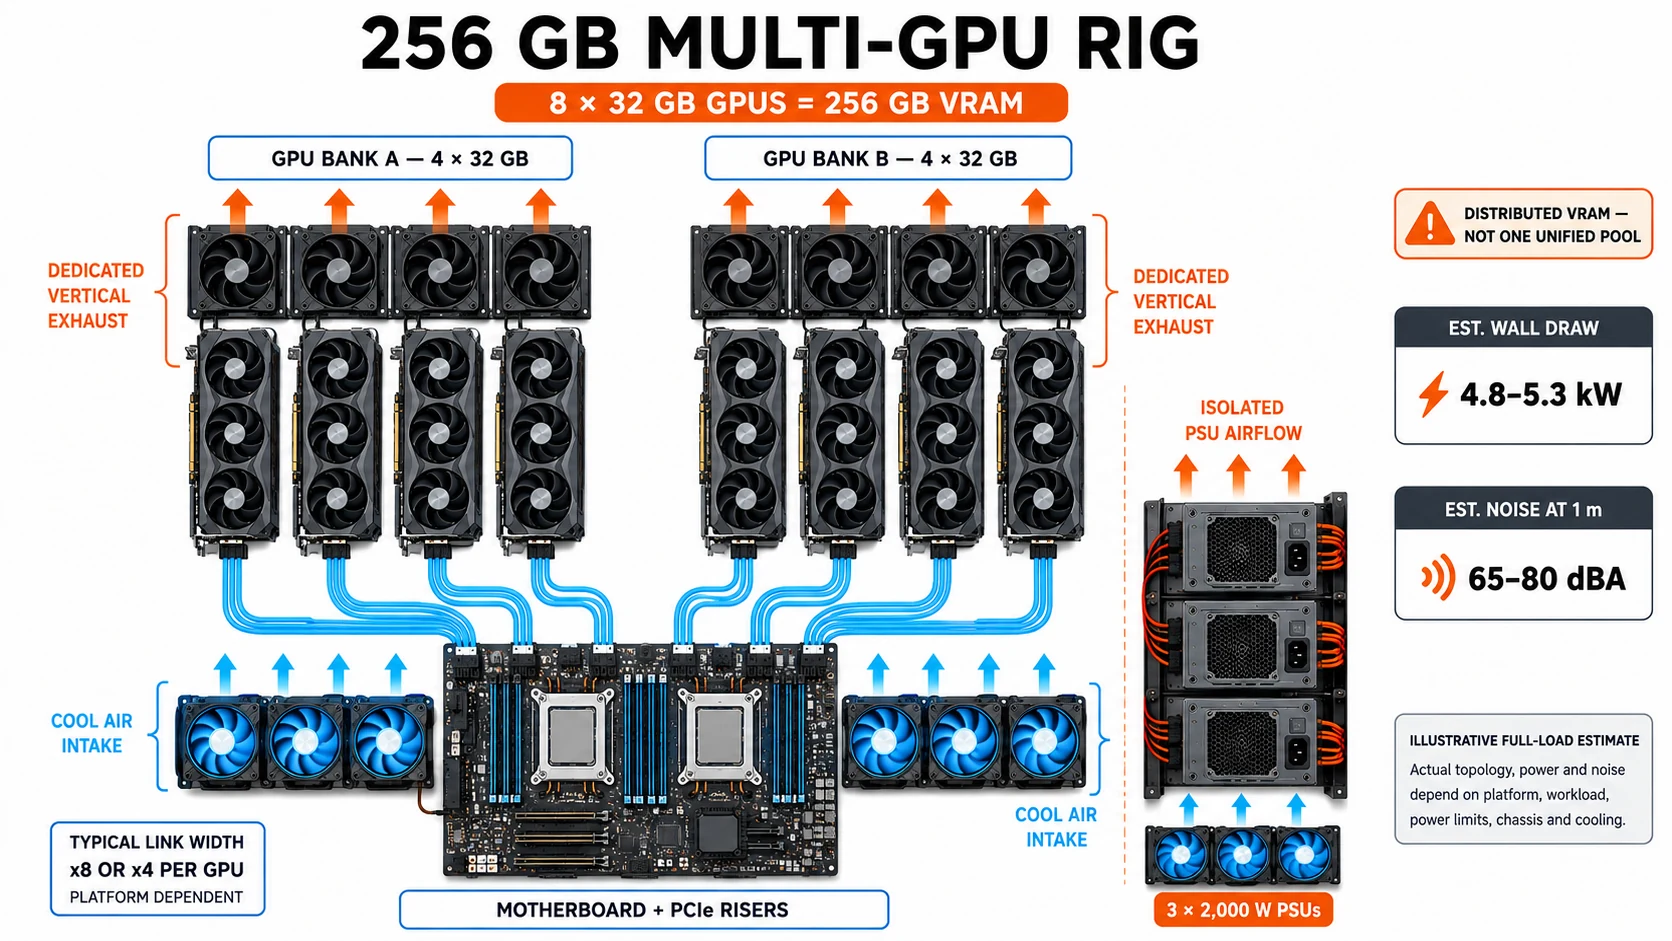
Huit cartes de 24 ou 32 Go donnent 192 à 256 Go de VRAM agrégée et beaucoup plus de calcul brut. Elles demandent aussi une carte mère adaptée, plusieurs alimentations ou une alimentation massive, du refroidissement, de la place, un réseau d'interconnexion et une vraie discipline logicielle.
Ce schéma reste une vue de principe. Selon la plateforme, les huit liaisons ne fonctionneront pas nécessairement en PCIe x16 ; du x8 ou du x4 par carte est fréquent. Le refroidissement doit aussi séparer les deux bancs et isoler le flux des alimentations afin que ni les GPU ni les PSU n'aspirent un air déjà réchauffé.
Le Mac Studio ne remplace pas ce rig pour l'entraînement lourd, les très gros batchs ou les kernels exclusivement CUDA. Il peut éviter sa construction pour une station personnelle d'inférence, un laboratoire RAG, un serveur de code privé ou quelques agents internes.
Apple ouvre même la porte au clustering via Thunderbolt 5 et annonce jusqu'à trois fois plus de performances en inférence distribuée avec plusieurs Mac Studio. Je commencerais néanmoins par une seule machine. Tout ce qui tient sur un nœud évite une couche de synchronisation et de panne.
MLX, la partie qui rend le matériel exploitable
La mémoire ne sert à rien sans une pile logicielle correcte. MLX a été conçu par Apple pour Apple Silicon. MLX-LM permet de charger, quantifier, affiner et servir des LLM depuis Python ou la ligne de commande. Le projet mesure séparément le préremplissage, la génération et le pic mémoire, ce qui évite de résumer un modèle à un seul chiffre flatteur.
« À mon sens, Apple prépare ses propres modèles d'IA locale, profondément optimisés pour Apple Silicon. Le matériel, la mémoire unifiée et MLX sont déjà là. Si l'entreprise complète cette base par une pile logicielle réellement aboutie, elle pourra maîtriser presque toute la chaîne et proposer une solution tout-en-un particulièrement cohérente pour l'IA locale. »
— Ruben Torney
L'écosystème progresse vite, mais il reste moins universel que CUDA. Certaines architectures arrivent plus tard, certains quants sont communautaires et des régressions apparaissent encore sur les modèles hybrides ou les très longues générations. Cette jeunesse doit figurer dans la décision.
Pour les logiciels OpenAI compatibles, un serveur MLX local peut néanmoins être exposé comme une API standard. C'est suffisant pour brancher une interface, un pipeline RAG ou un agent sans modifier toute l'application.
Hermes sur Mac Studio, un vrai cas d'usage
Hermes Agent accepte les endpoints OpenAI compatibles et documente l'usage de modèles locaux sur Mac avec MLX et omlx. Un Mac Studio 256 Go peut donc devenir le cerveau d'un agent disponible en continu sur le réseau local.
Le modèle principal peut coder, naviguer, analyser des documents ou appeler des outils. Un second modèle plus petit peut gérer les tâches rapides. Une variante multimodale comme DeepSeek V4 Flash Vision ou GLM-5.3 Flash peut lire les captures et les pièces jointes sans envoyer les données à un autre fournisseur.
Cette architecture apporte trois gains concrets.
- Le code, les documents et les conversations restent sur la machine.
- Le coût marginal d'une longue tâche devient presque nul hors électricité.
- L'agent ne s'arrête pas parce qu'un quota change ou qu'un fournisseur dégrade un modèle.
Elle demande en échange de gérer les mises à jour, les sauvegardes, la sécurité réseau et l'observabilité. La souveraineté n'est jamais un bouton magique.
12 649 € neuf face à 19 999 € reconditionné
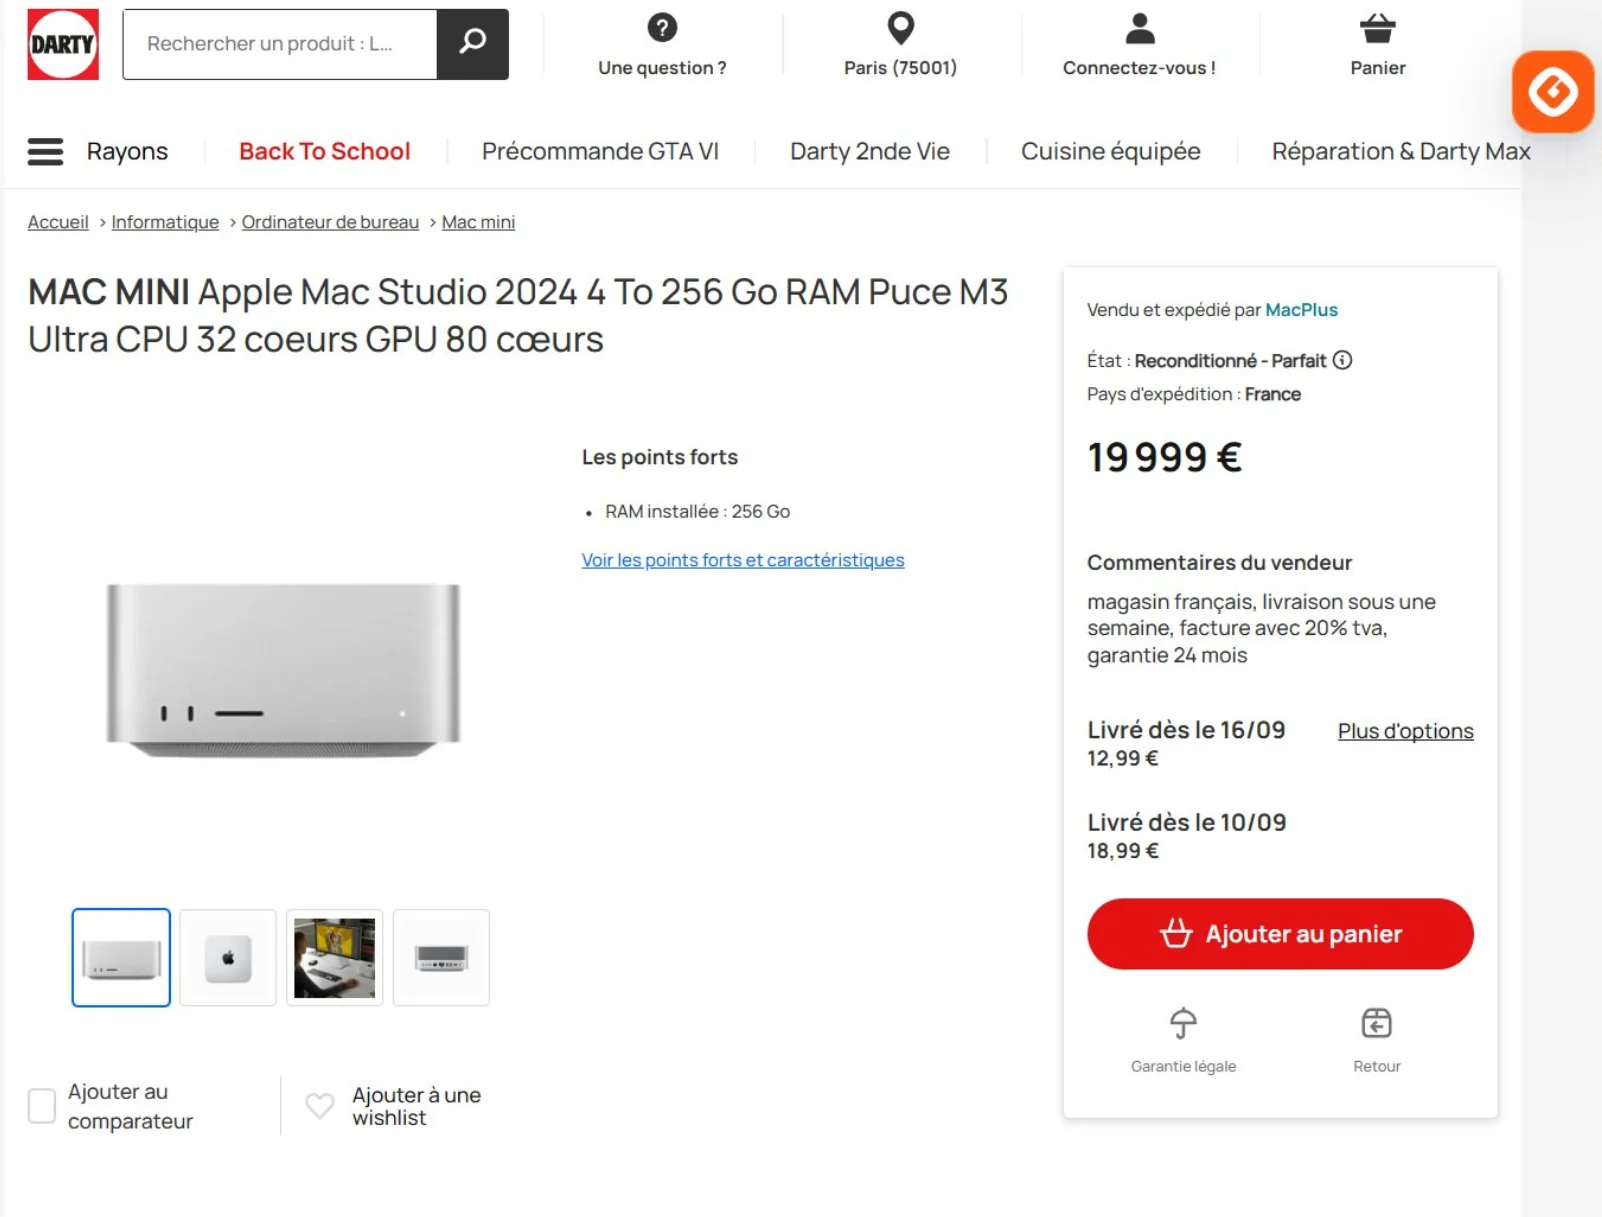
Le marché de l'occasion rend ce lancement étonnamment compétitif. Le 2 septembre, une annonce de marketplace publiée sur Darty affichait un Mac Studio M3 Ultra reconditionné avec 256 Go, 4 To, 32 cœurs CPU et 80 cœurs GPU à 19 999 €. La configuration M5 Ultra neuve observée chez Apple avec la même mémoire et le même stockage était affichée à 12 649 €.
L'écart atteint 7 350 €. Le nouveau modèle ajoute une bande passante de 1,2 To/s contre plus de 800 Go/s sur le M3 Ultra, une garantie neuve et une architecture IA plus récente.
Il faut rester précis. Le tarif Darty est le prix demandé par un vendeur tiers, pas la preuve qu'une transaction se conclut à ce niveau. Ce n'est pas une moyenne de marché. Il montre néanmoins la rareté et la rigidité de l'offre haut de gamme M3 Ultra. Dans cet instantané, acheter neuf est nettement plus rationnel que payer la pénurie de l'ancienne génération.
Le calcul face à un abonnement cloud
Comparé à un abonnement à 200 $ par mois, 12 649 € représentent plus de cinq années avant même de compter l'électricité, la maintenance et le coût du capital. Pour une personne qui utilise occasionnellement Claude, ChatGPT ou Grok, le Mac ne gagne pas sur le prix.
Le calcul change pour un usage constant, plusieurs utilisateurs, des charges longues ou des données sensibles. Une machine locale fournit une capacité fixe, disponible à toute heure, sans tarification par token. Elle conserve aussi une valeur de revente et peut servir au développement, à la vidéo, à la data ou à la compilation.
Le vrai achat porte pourtant sur autre chose. Vous payez pour que le code et les documents ne quittent pas votre infrastructure. Vous réduisez la dépendance aux changements de modèle, aux quotas, aux politiques commerciales et aux lois extraterritoriales. Ce n'est pas la solution la moins chère pour tout le monde. C'est le prix de la souveraineté pour ceux qui en ont besoin.
Ce qui doit encore faire hésiter
- La mémoire est figée à l'achat. Une erreur de dimensionnement ne se corrige pas avec deux barrettes.
- CUDA reste incontournable pour de nombreux outils, entraînements et kernels spécialisés.
- Les performances réelles des nouveaux Neural Accelerators dépendront de leur adoption par MLX et les runtimes.
- Les contextes très longs consomment beaucoup de mémoire et ralentissent le préremplissage.
- Le chiffre de 480 W publié par Apple correspond à la consommation maximale continue, pas à une mesure d'inférence typique.
- La confidentialité locale dépend aussi du système, des logiciels installés, des accès distants et des sauvegardes.
Quelle configuration choisir
M5 Max 128 Go. Le meilleur compromis pour un développeur qui veut des 27B à 70B, des MoE compacts et une station silencieuse. Il faut éviter de l'acheter pour un quant qui remplit déjà presque toute la mémoire.
M5 Ultra 256 Go. Le point d'équilibre pour les gros MoE actuels, plusieurs modèles résidents, la vision locale et un agent Hermes sérieux. C'est la configuration que je trouve la plus rationnelle pour un usage professionnel souverain.
M5 Ultra 512 Go. Le choix pour les modèles proches de 670B, les quants plus élevés, plusieurs gros services simultanés ou la recherche. La capacité arrive fin octobre et la facture monte fortement.
Mon verdict
12 649 € reste une somme considérable. Pourtant, au regard des 19 999 € demandés pour une configuration M3 Ultra reconditionnée équivalente, du gain de bande passante et de la capacité à faire tenir des MoE réellement utiles, le M5 Ultra 256 Go ressemble à un bon plan dans sa niche.
Je ne le conseillerais pas à quelqu'un qui cherche seulement une alternative moins chère à Claude. Je le regarderais très sérieusement pour du code privé, du RAG, de la recherche documentaire, de la vision locale et des agents autonomes qui travaillent plusieurs heures par jour.
On obtient une machine compacte, silencieuse et beaucoup plus simple à exploiter qu'un rig de huit GPU. On accepte en retour un écosystème moins large que CUDA et un investissement initial élevé. À chacun de voir où il met le curseur entre coût, vitesse, simplicité et souveraineté.
Questions rapides
Le Mac Studio M5 Ultra 256 Go peut-il remplacer deux DGX Spark ?
Il peut les remplacer pour certains workloads d'inférence où la capacité sur un seul nœud, la simplicité et MLX comptent davantage que CUDA. Il ne les remplace pas universellement pour le batching, l'entraînement ou les applications optimisées NVIDIA.
Quels modèles peuvent tenir dans 256 Go ?
Des quantifications adaptées de Qwen3.8-Flash-Next, DeepSeek V4 Flash et GLM-5.3 Flash peuvent tenir, avec une marge variable pour le contexte. Un DeepSeek 671B en 4 bits demande plutôt 512 Go.
Peut-on réellement obtenir 30 à 50 tokens par seconde ?
Oui sur certaines combinaisons de modèle, quantification, contexte et moteur. Ce n'est pas une garantie générale. Les premiers benchmarks reproductibles du M5 Ultra seront nécessaires pour fixer des attentes précises.
Le Mac Studio est-il plus souverain qu'une API cloud ?
Il permet de garder les poids, les prompts et les données sur site. La souveraineté reste partielle tant que le système, les mises à jour, les modèles et les accès réseau ne sont pas eux aussi gouvernés.
Sources
- Apple, caractéristiques du Mac Studio M5 Max et M5 Ultra.
- Apple Newsroom, annonce du Mac Studio M5 et calendrier de précommande.
- Apple Developer WWDC25, grands modèles de langage avec MLX.
- Apple Developer WWDC26, IA agentique locale avec MLX.
- MLX-LM, runtime et outils de benchmark.
- NVIDIA, spécifications officielles du DGX Spark.
- NVIDIA, guide de quantification NVFP4 avec Model Optimizer sur DGX Spark.
- LDLC, prix et disponibilité du DGX Spark 128 Go / 4 To consultés le 2 septembre 2026.
- DeepSeek, model card officielle de DeepSeek V4 Flash.
- Qwen, model card officielle de Qwen3.8-Flash-Next.
- Z.ai, model card officielle de GLM-5.3 Flash.
- Nous Research, exécution de modèles locaux sur Mac avec Hermes Agent.
- Scaleway, tarifs officiels des instances GPU en Europe.
- Nebius AI Cloud, tarification officielle des ressources GPU.
- Nebius, implantation et extension de ses capacités IA en Finlande et en France.
- Darty Marketplace, annonce M3 Ultra 256 Go / 4 To consultée le 2 septembre 2026.