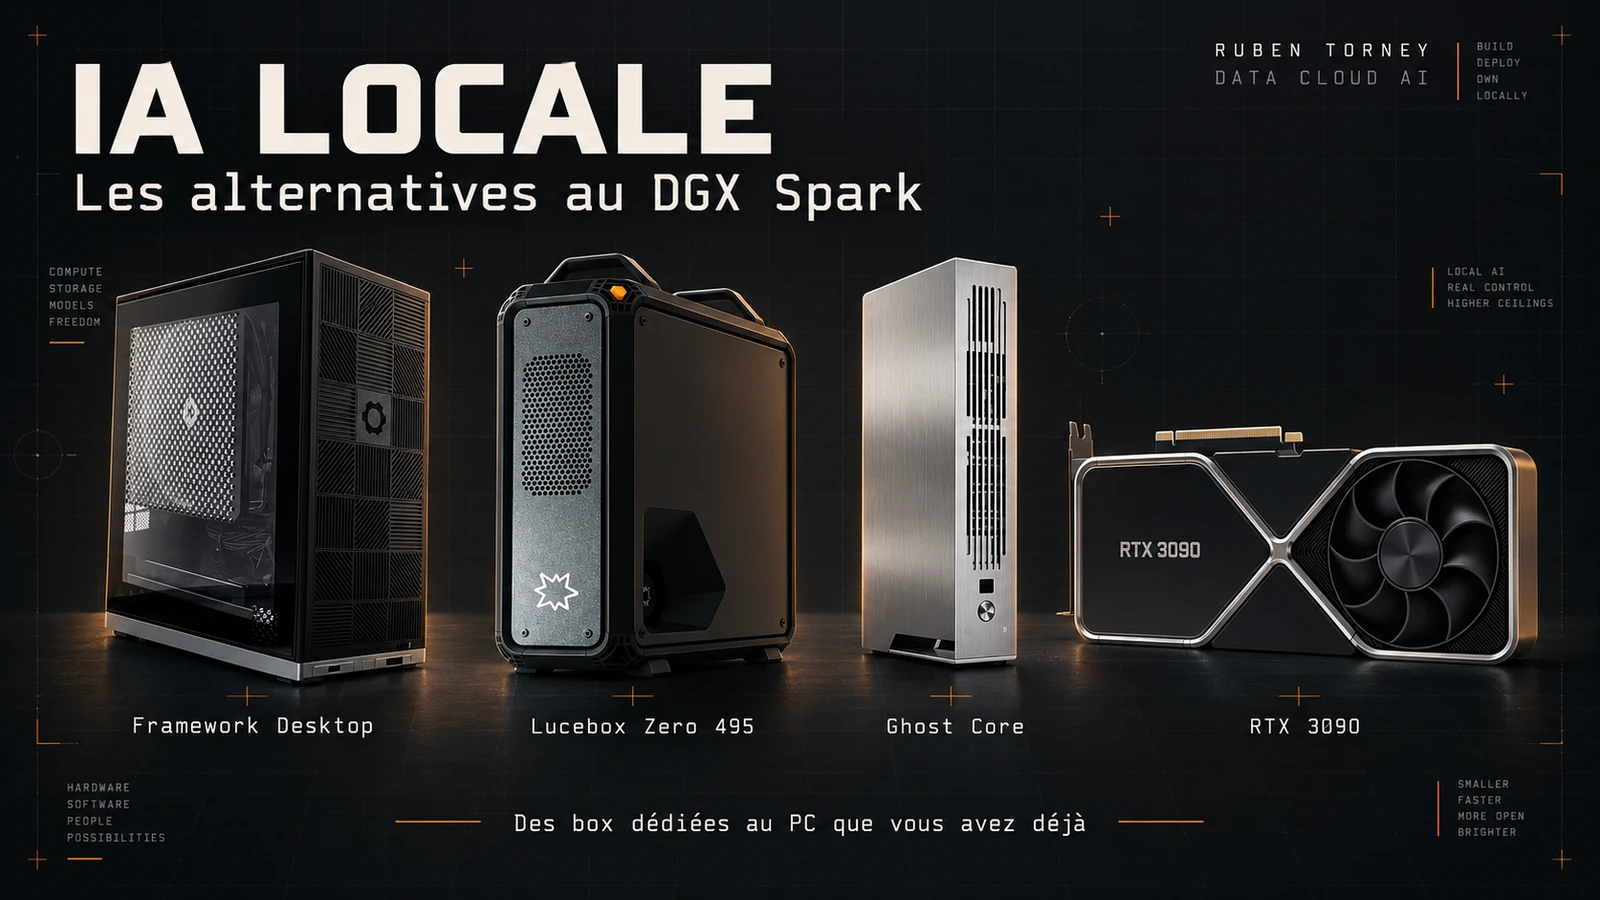
Une petite boîte plutôt qu’un serveur dans le salon
Ce qui m’intéresse dans cette nouvelle vague de box IA, c’est une promesse très simple. Avoir une machine compacte, accessible dans un bureau, qui fait tourner des modèles localement sans installer un serveur de plusieurs dizaines de kilos. L’inférence, autrement dit l’exécution du modèle, devient un équipement que l’on peut acheter et administrer chez soi.
Le marché ne propose cependant pas un produit unique. Framework vend une plateforme matérielle, Lucebox une station avec son moteur d’inférence préinstallé, et Ghost un ordinateur pensé autour d’un assistant personnel. Le degré de préparation logicielle compte autant que la capacité mémoire. Une machine assemblée ne signifie pas forcément qu’un agent métier est prêt à travailler.
Je n’ai pas testé ces trois box. Je compare ici leurs annonces au 6 octobre 2026 et mon expérience sur mon propre PC. Les captures des boutiques documentent les prix affichés à cette date, pas une disponibilité immédiate ni une performance mesurée.
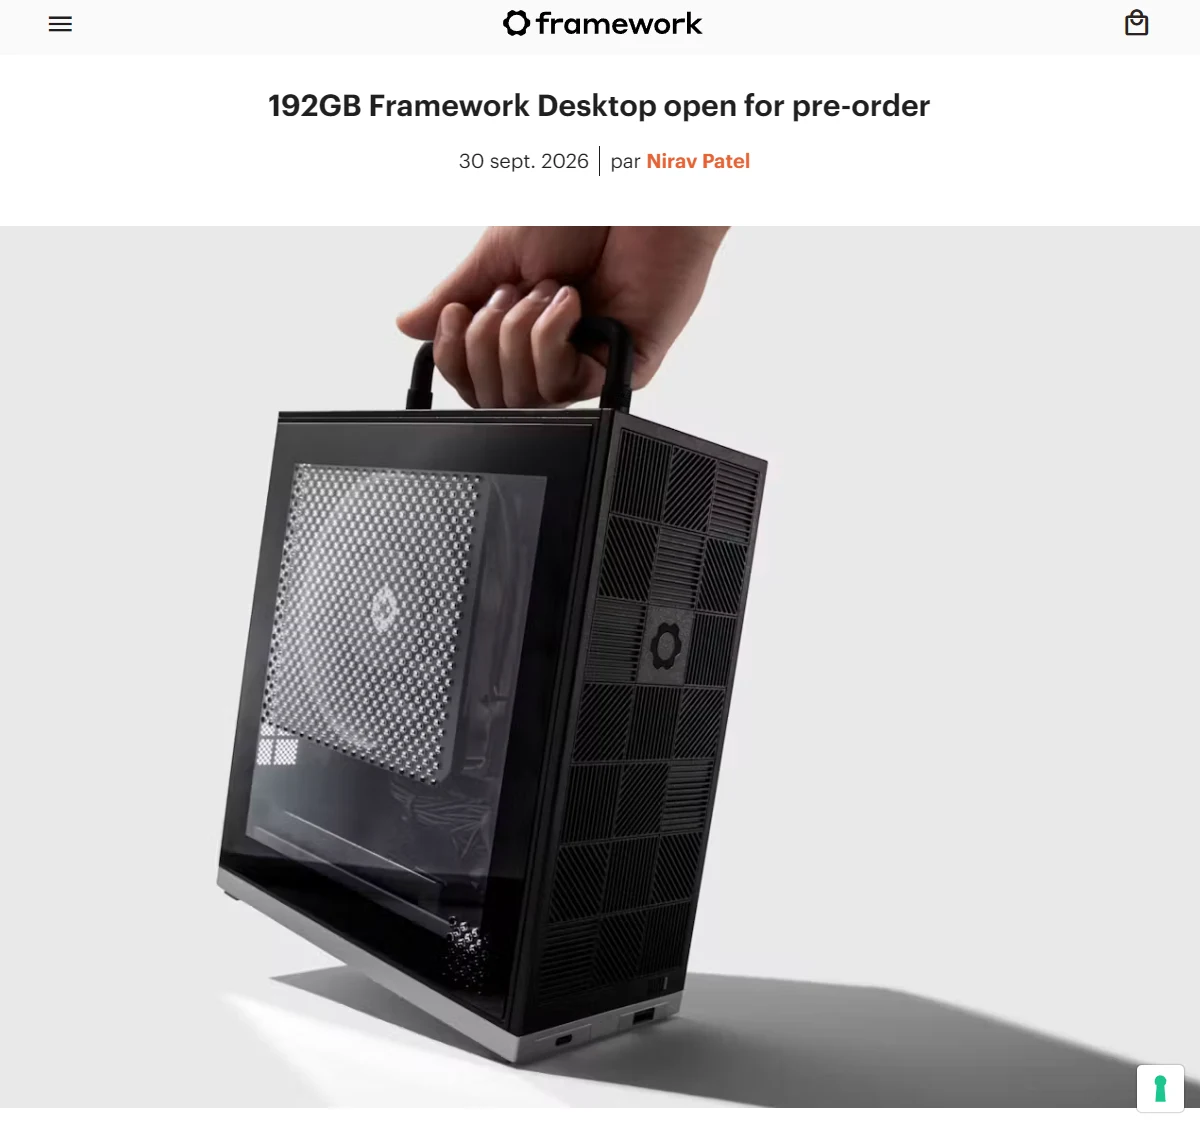
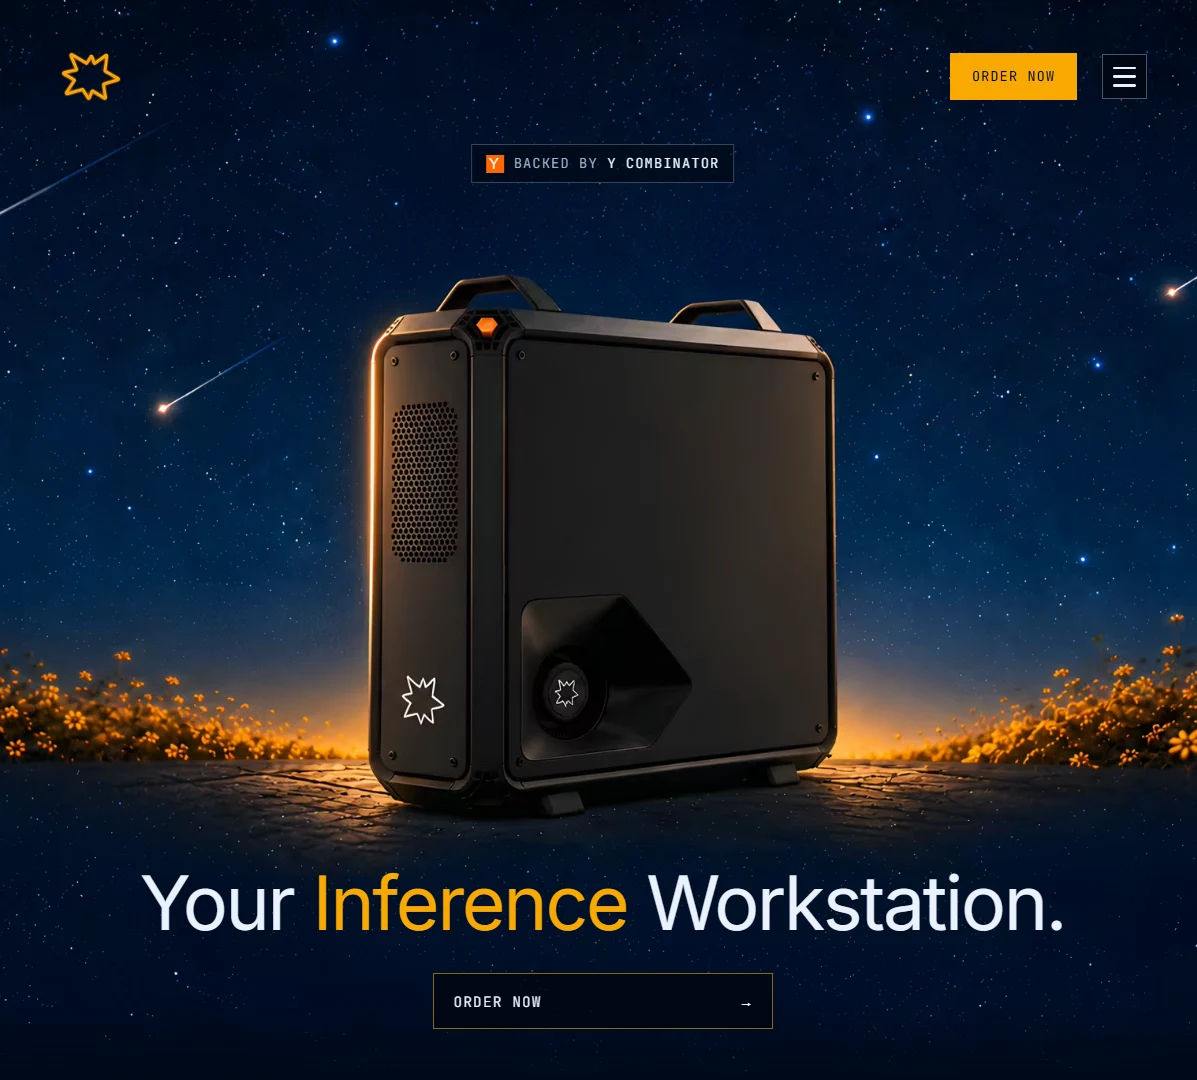
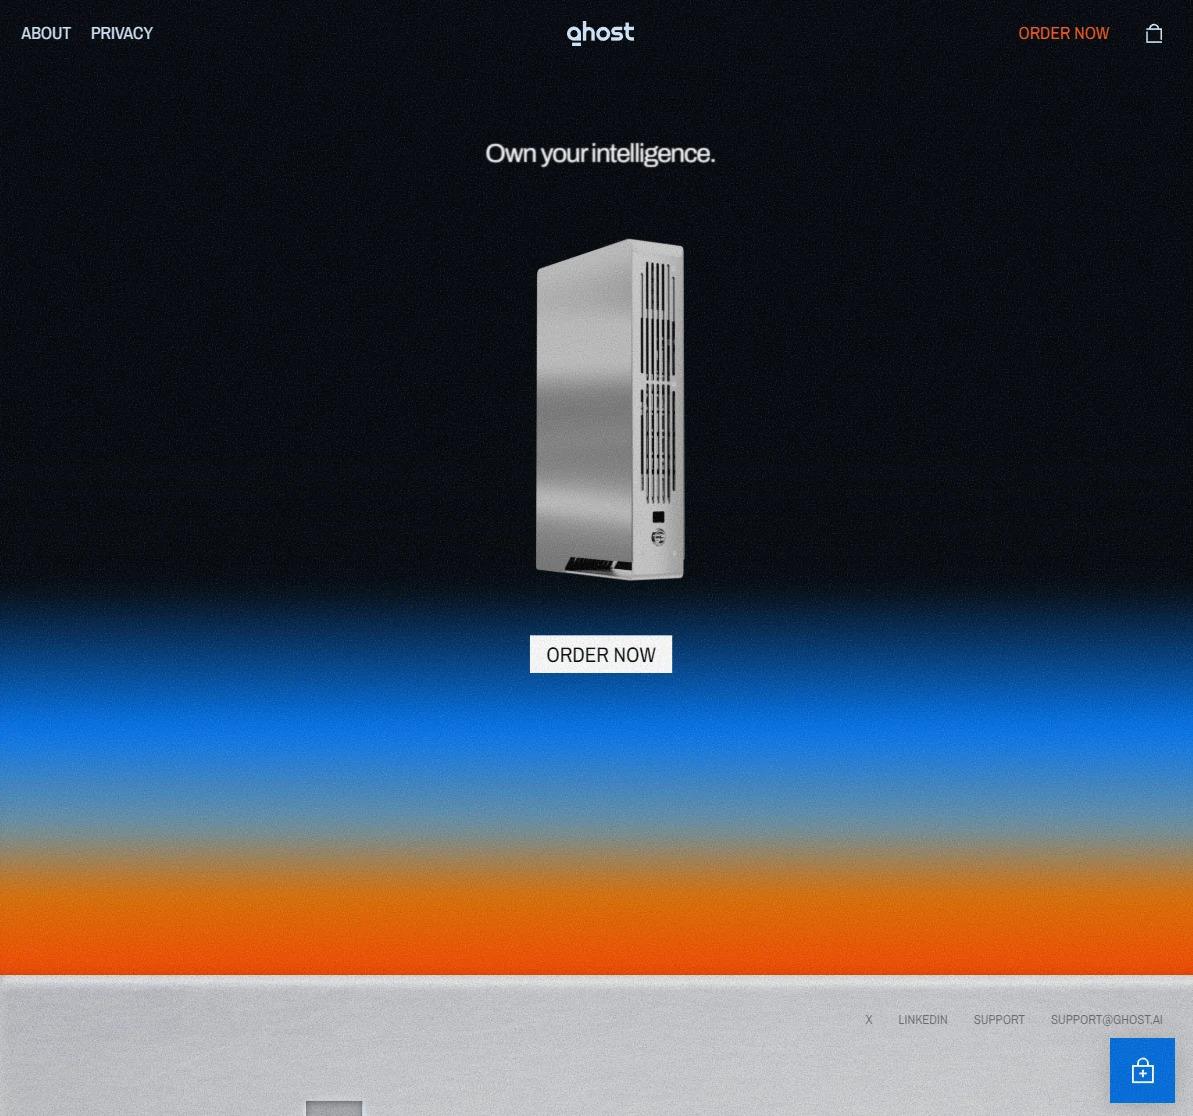
J’avais déjà exploré le Xiaomi AI Cube, la « box Xiaomi » face au DGX Spark, présenté comme un prototype dans cet article, ainsi que le Mac Studio d’Apple pour les LLM locaux. Framework, Lucebox et Ghost viennent élargir ce paysage, avec des architectures et des niveaux de préparation logicielle différents. Entre prototype, précommande et machine commercialisée, il faut garder les statuts visibles pour comparer utilement.
Ce qui me frappe, c’est la vitesse à laquelle les options se multiplient. Le choix dépasse désormais un face-à-face entre NVIDIA et Apple. On voit arriver des stations à grande mémoire unifiée, des configurations hybrides avec GPU dédié et des assistants intégrés. Cet engouement rend le choix plus intéressant, mais aussi plus dépendant du logiciel, du support et du besoin réel que d’un simple nom de puce.
Framework, Lucebox et Ghost suivent trois approches
| Machine | Mémoire et calcul annoncés | Prix observé | Disponibilité annoncée |
|---|---|---|---|
| Framework Desktop AI Max 400 | Ryzen AI Max+ PRO 495, 192 Go unifiés, GPU intégré | 7 659 € dans le configurateur français fourni | Précommande, lot affiché pour novembre 2026 |
| Lucebox Zero 495 | 128 Go unifiés et Radeon AI PRO R9700 de 32 Go ; option 192 Go unifiés | Dès 6 499 € ; 8 698 € avec l’option 192 Go, hors autres options | Livraison annoncée en janvier 2027 |
| Ghost Core | Ryzen 5 7600, 64 Go de DDR5 et RTX PRO 4000 Blackwell SFF de 24 Go | 3 499 $ affichés, fiscalité et livraison française à confirmer | Premier lot ouvert à la commande ; date non confirmée ici |
Le Framework Desktop 192 Go, annoncé le 30 septembre, monte en capacité avec une mémoire LPDDR5X à 8 533 MT/s et une bande passante annoncée de 273 Go/s. La version assemblée sous Fedora et l’édition DIY ne répondent pas au même besoin de simplicité. Cette génération est conçue pour Linux, et la mémoire n’est pas évolutive selon le configurateur. Les 192 Go sont partagés avec le système, pas intégralement réservés aux poids du modèle.
La Lucebox Zero 495 ajoute un GPU dédié à la mémoire unifiée. Les 192 Go constituent une option de 2 199 € au-dessus des 128 Go de base. Le vendeur annonce taxes, droits et livraison inclus dans son tarif en euros, avec Ubuntu Server et son moteur préinstallés. Les « 224 Go » additionnent 192 Go et 32 Go de VRAM. Ce n’est pas un réservoir homogène ayant partout la vitesse du GPU, et la liaison PCIe 4.0 x4 impose aussi ses contraintes.
Ghost Core adopte une autre architecture, avec 64 Go de RAM système et 24 Go de VRAM séparée. Son positionnement est davantage celui d’un assistant personnel local, relié aux applications et aux fichiers. Le constructeur cite notamment Qwen 3.8-27B et Qwen 3.8-Next. Cela ne suffit pas à en déduire leurs débits, leur quantification ou le nombre de sessions simultanées supportées.
Quelle machine pour quel modèle et quel usage ?
Dans ce tableau, B désigne un milliard de paramètres. Les capacités sont mes estimations de dimensionnement, pas des maxima certifiés par les fabricants ni des performances mesurées. Je pars d’une quantification proche de 4 bits, avec un budget simplifié de 0,6 Go par milliard de paramètres pour les poids et leurs métadonnées. Le contexte, le moteur et le système ont besoin de mémoire supplémentaire.
| Configuration | Modèles denses à envisager | MoE et plafond estimé en Q4 | Usages auxquels je la destinerais |
|---|---|---|---|
| Framework Desktop 192 Go | 32 à 70B pour commencer ; 120B envisageable si le débit convient. Plafond mémoire d’environ 260B, sans promesse de vitesse. | Jusqu’à 260B de paramètres totaux selon le moteur. Un MoE de 125B laisse davantage de marge qu’un modèle proche du plafond. | RAG documentaire, développement et expérimentation de gros modèles sous Linux, avec maîtrise de la pile logicielle. |
| Lucebox Zero 495, 128 Go + GPU 32 Go | 32 à 40B peuvent viser le GPU seul ; 70 à 120B demandent de répartir les poids. Plafond agrégé d’environ 200B si le moteur le permet. | Jusqu’à 200B totaux avec répartition entre les mémoires. Les experts souvent sollicités peuvent profiter du GPU, selon le moteur. | Agents et RAG pour une petite équipe, service d’inférence local et MoE avec logiciel préinstallé. La concurrence reste à tester. |
| Lucebox Zero 495, 192 Go + GPU 32 Go | Même capacité sur le GPU seul, davantage de place pour répartir les poids. Plafond agrégé d’environ 300B, potentiellement lent en dense. | Jusqu’à 300B totaux sous ces hypothèses. L’option mémoire augmente la capacité, pas automatiquement le débit. | Gros MoE et expérimentation. Garder de la marge pour le contexte et les documents plutôt que charger systématiquement le plus gros modèle. |
| Ghost Core, RAM 64 Go + GPU 24 Go | 7 à 27B pour commencer ; autour de 30B en GPU seul selon le format et le contexte. Un dense de 70B nécessite un déport en RAM, potentiellement lent. | Plafond agrégé d’environ 110B en Q4, avec un moteur compatible avec cette répartition. Ce calcul ne garantit pas le support par le logiciel Ghost livré. | Assistant personnel, courriels, classement, recherche dans les fichiers et automatisations courantes, avec priorité à la simplicité. |
| Mon PC, RTX 3090 24 Go + RAM 64 Go | Même ordre de grandeur mémoire que Ghost, sans en déduire une vitesse identique. 7 à 27B pour commencer, 70B avec déport. | Environ 110B en Q4 par ce calcul. Mon essai porte sur 125B en IQ3_XXS, plus compact, avec Strata et environ 70 tokens/s à 128K configurés. | Développeur ou passionné qui veut réutiliser son matériel pour des agents et du RAG, en acceptant installation, réglages et maintenance. |
Les paramètres totaux d’un MoE comptent pour le stockage, les paramètres actifs comptent surtout pour le calcul. Un MoE de 125B qui n’active qu’une fraction de ses experts ne tient donc pas en mémoire comme un petit modèle dense de cette seule taille active. Cette distinction est expliquée dans la présentation des MoE par Hugging Face. À quantification comparable, dense et MoE ont un budget de poids du même ordre par paramètre total, mais leur débit et leur cache de contexte peuvent être très différents.
Pour rendre les plafonds vérifiables, je réserve ici 32 Go sur les configurations unifiées, 16 Go sur les machines à 64 Go de RAM et 8 Go ou 6 Go sur les GPU de 32 ou 24 Go. Cela laisse respectivement 160, 120, 184 et 66 Go pour les poids des quatre configurations distinctes, puis je divise par 0,6 et j’arrondis vers le bas. Les additions RAM et VRAM supposent un moteur capable de répartir les poids sans duplication excessive. Elles ne décrivent jamais une mémoire unique à la vitesse du GPU.
Ces réserves ne garantissent pas un contexte de 128K ou 262K. Un long contexte, plusieurs utilisateurs ou certains caches KV peuvent demander beaucoup plus. Q8 et BF16 prennent davantage de place ; Q3 ou Q2 peuvent dépasser ces plafonds avec un compromis de qualité à évaluer. Le déport vers le SSD peut repousser la limite de chargement, mais je ne le compte pas comme capacité utilisable ici. Avant achat, il faut valider le fichier de poids exact, le moteur, le contexte et le débit sur une tâche représentative.
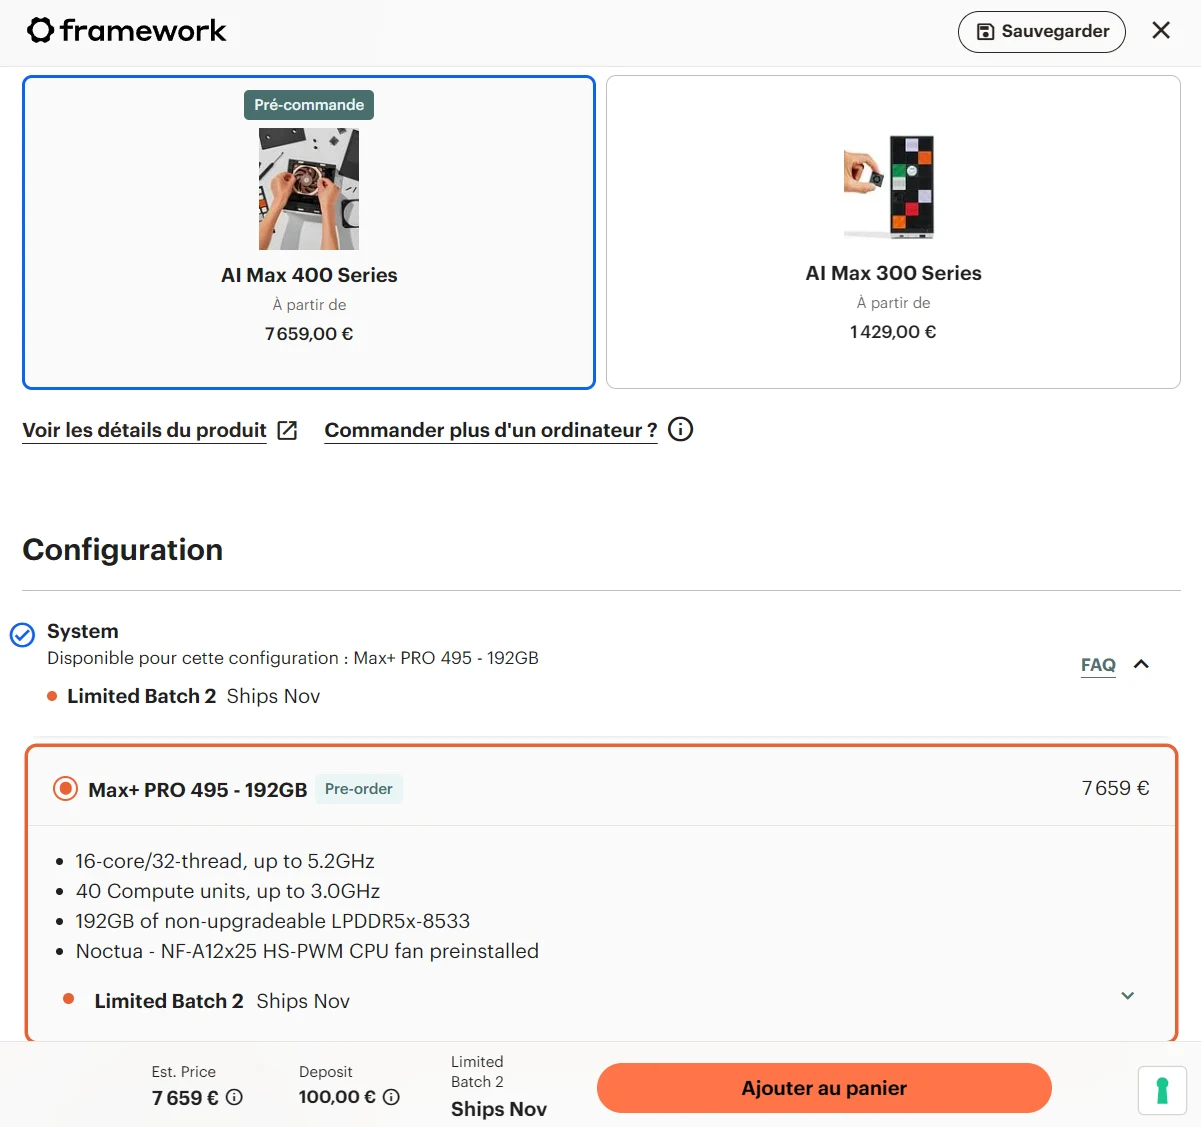
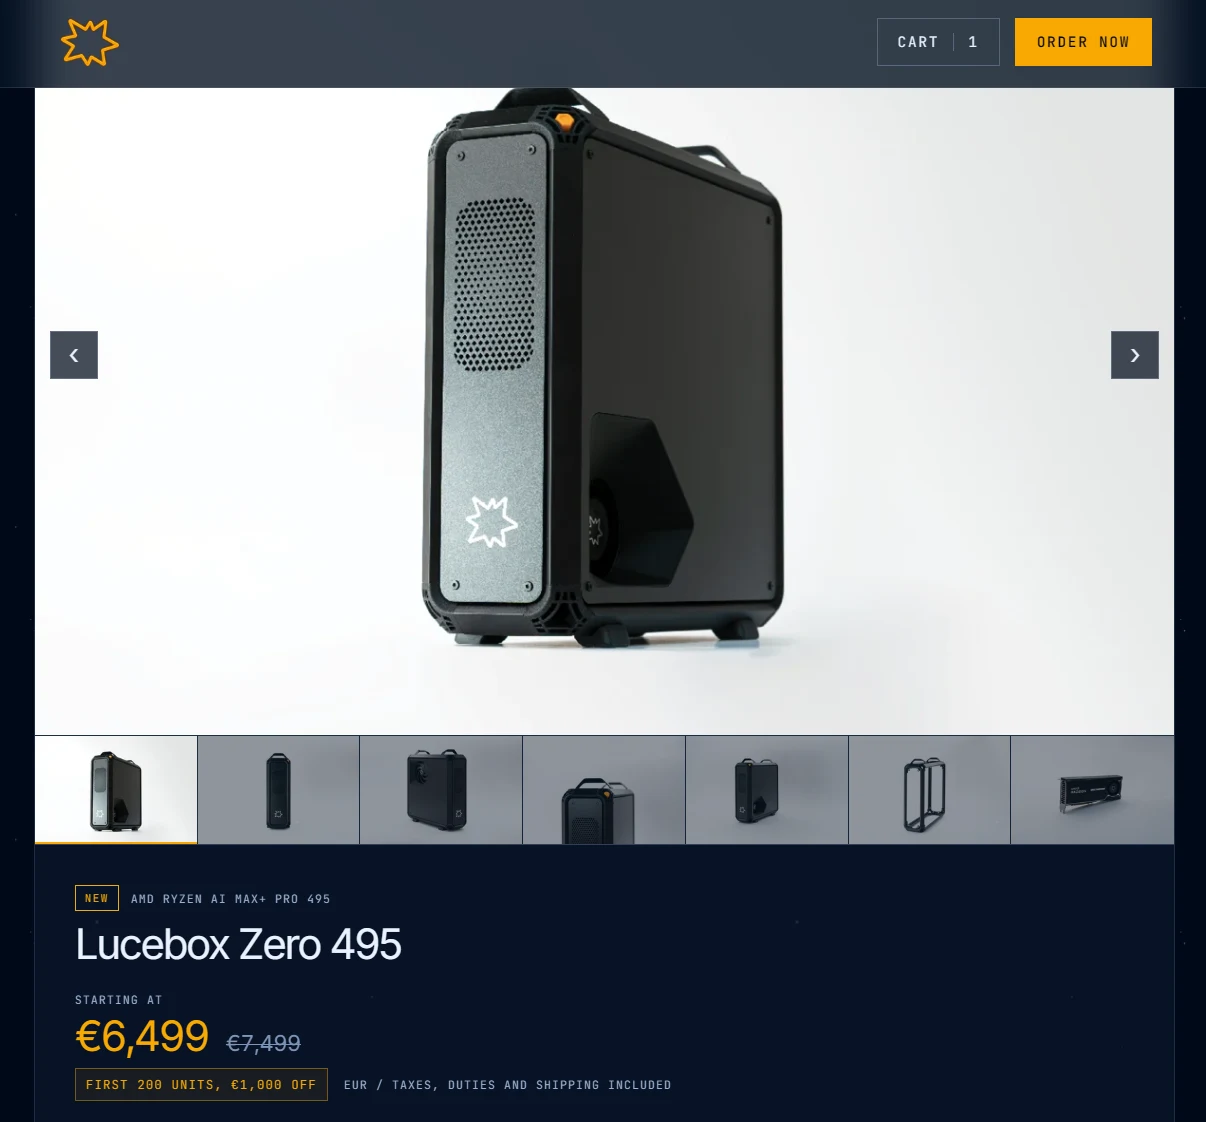
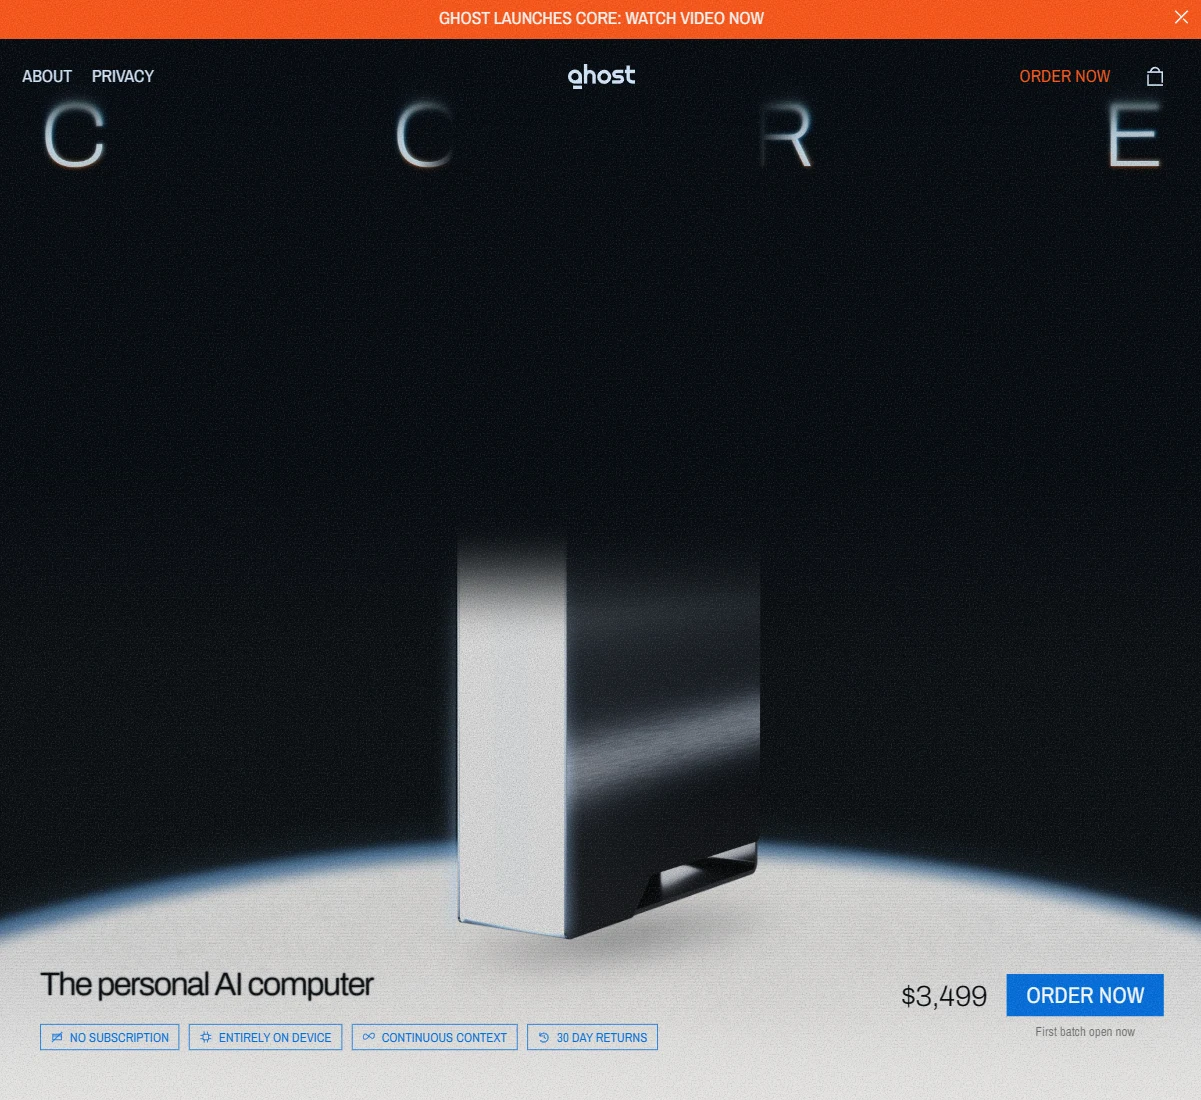
Ces tarifs ne permettent pas un classement sérieux au simple coût par gigaoctet. Il faut comparer le logiciel livré, la maintenance, le stockage, les garanties et la configuration complète, avec les mêmes taxes. Pour un indépendant, plusieurs milliers d’euros restent un investissement conséquent.
Le DGX Spark reste une référence à comparer correctement
NVIDIA a annoncé le 2 octobre une variante DGX Spark de 64 Go, proposée par ses partenaires à partir de 4 999 dollars, avec une disponibilité prévue le 23 octobre. À ce niveau de prix, je trouve la capacité mémoire difficile à défendre si l’objectif principal est de charger de gros modèles. Son environnement logiciel peut néanmoins compter dans un choix professionnel.
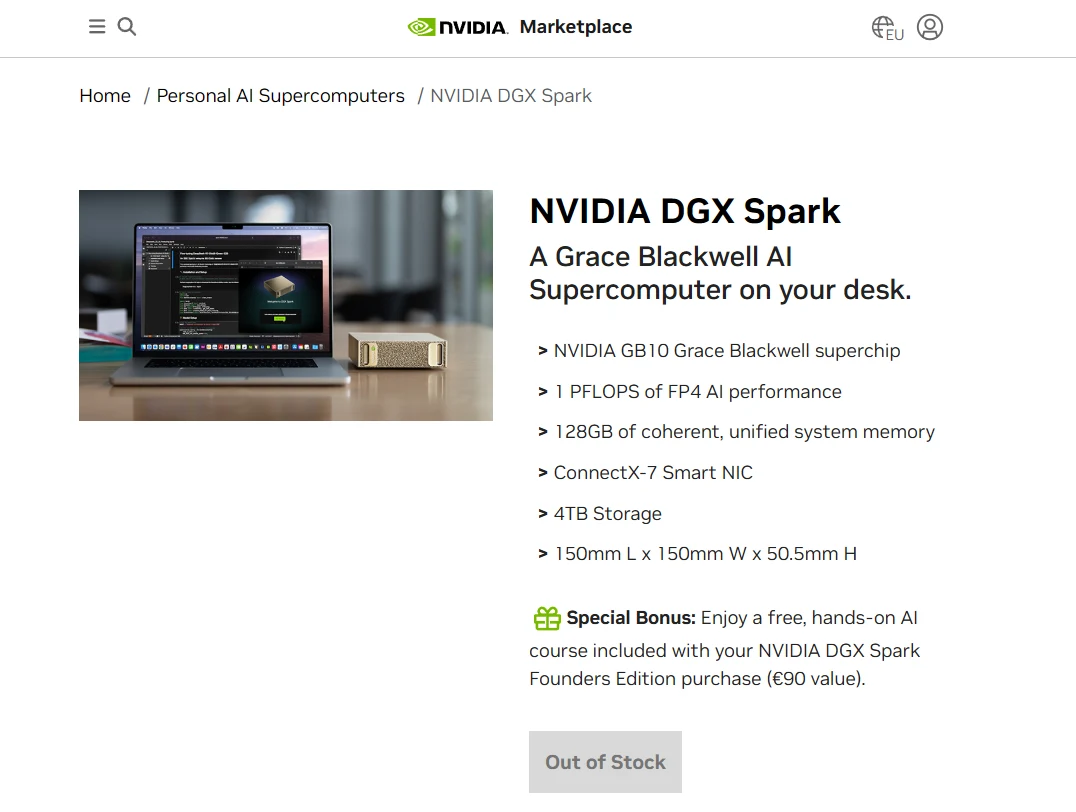
Il faut la distinguer du DGX Spark de 128 Go que montre ma capture. La fiche affiche un produit en rupture de stock, sans prix visible. Les modèles 64 et 128 Go ne doivent pas être confondus, ni comparés à un prix européen toutes taxes comprises sans ajustement.
Ces nouvelles offres prolongent le sujet de mon comparatif des machines DGX Spark et GB10. Mais la question qui devient intéressante est aussi celle de l’achat évité.
Mon PC fait déjà tourner Qwen avec Strata
J’ai acheté ma RTX 3090 d’occasion sur Le Bon Coin pour 750 €. J’ai également 64 Go de RAM, achetés quelques centaines d’euros il y a quelques mois. Ce sont mes coûts d’achat historiques, pas un devis reproductible aujourd’hui et encore moins le prix du PC complet.
Avec Strata, j’utilise Qwen 3.8 Flash en quantification IQ3_XXS, qui réduit la mémoire nécessaire au stockage des poids. Le projet prend en charge Qwen3.8-Flash-Next, un modèle de 125 milliards de paramètres. La version précise du moteur n’a pas été consignée dans ce retour.
Sur mes essais avec IQ3_XXS, je relève environ 70 tokens/s avec une fenêtre de 128K et environ 30 tokens/s avec une fenêtre de 262K. Ce sont mes observations d’usage, pas un comparatif à prompts et réglages identiques. Les tokens sont les unités de texte produites par le modèle. La capture du 5 octobre affiche 73,8 tokens/s en génération, avec une fenêtre configurée à 128K. Elle montre environ 46K de contexte occupé, soit 35 %. Ce résultat n’est donc pas une mesure à 128K entièrement remplis, ni une moyenne garantie sur une session complète.
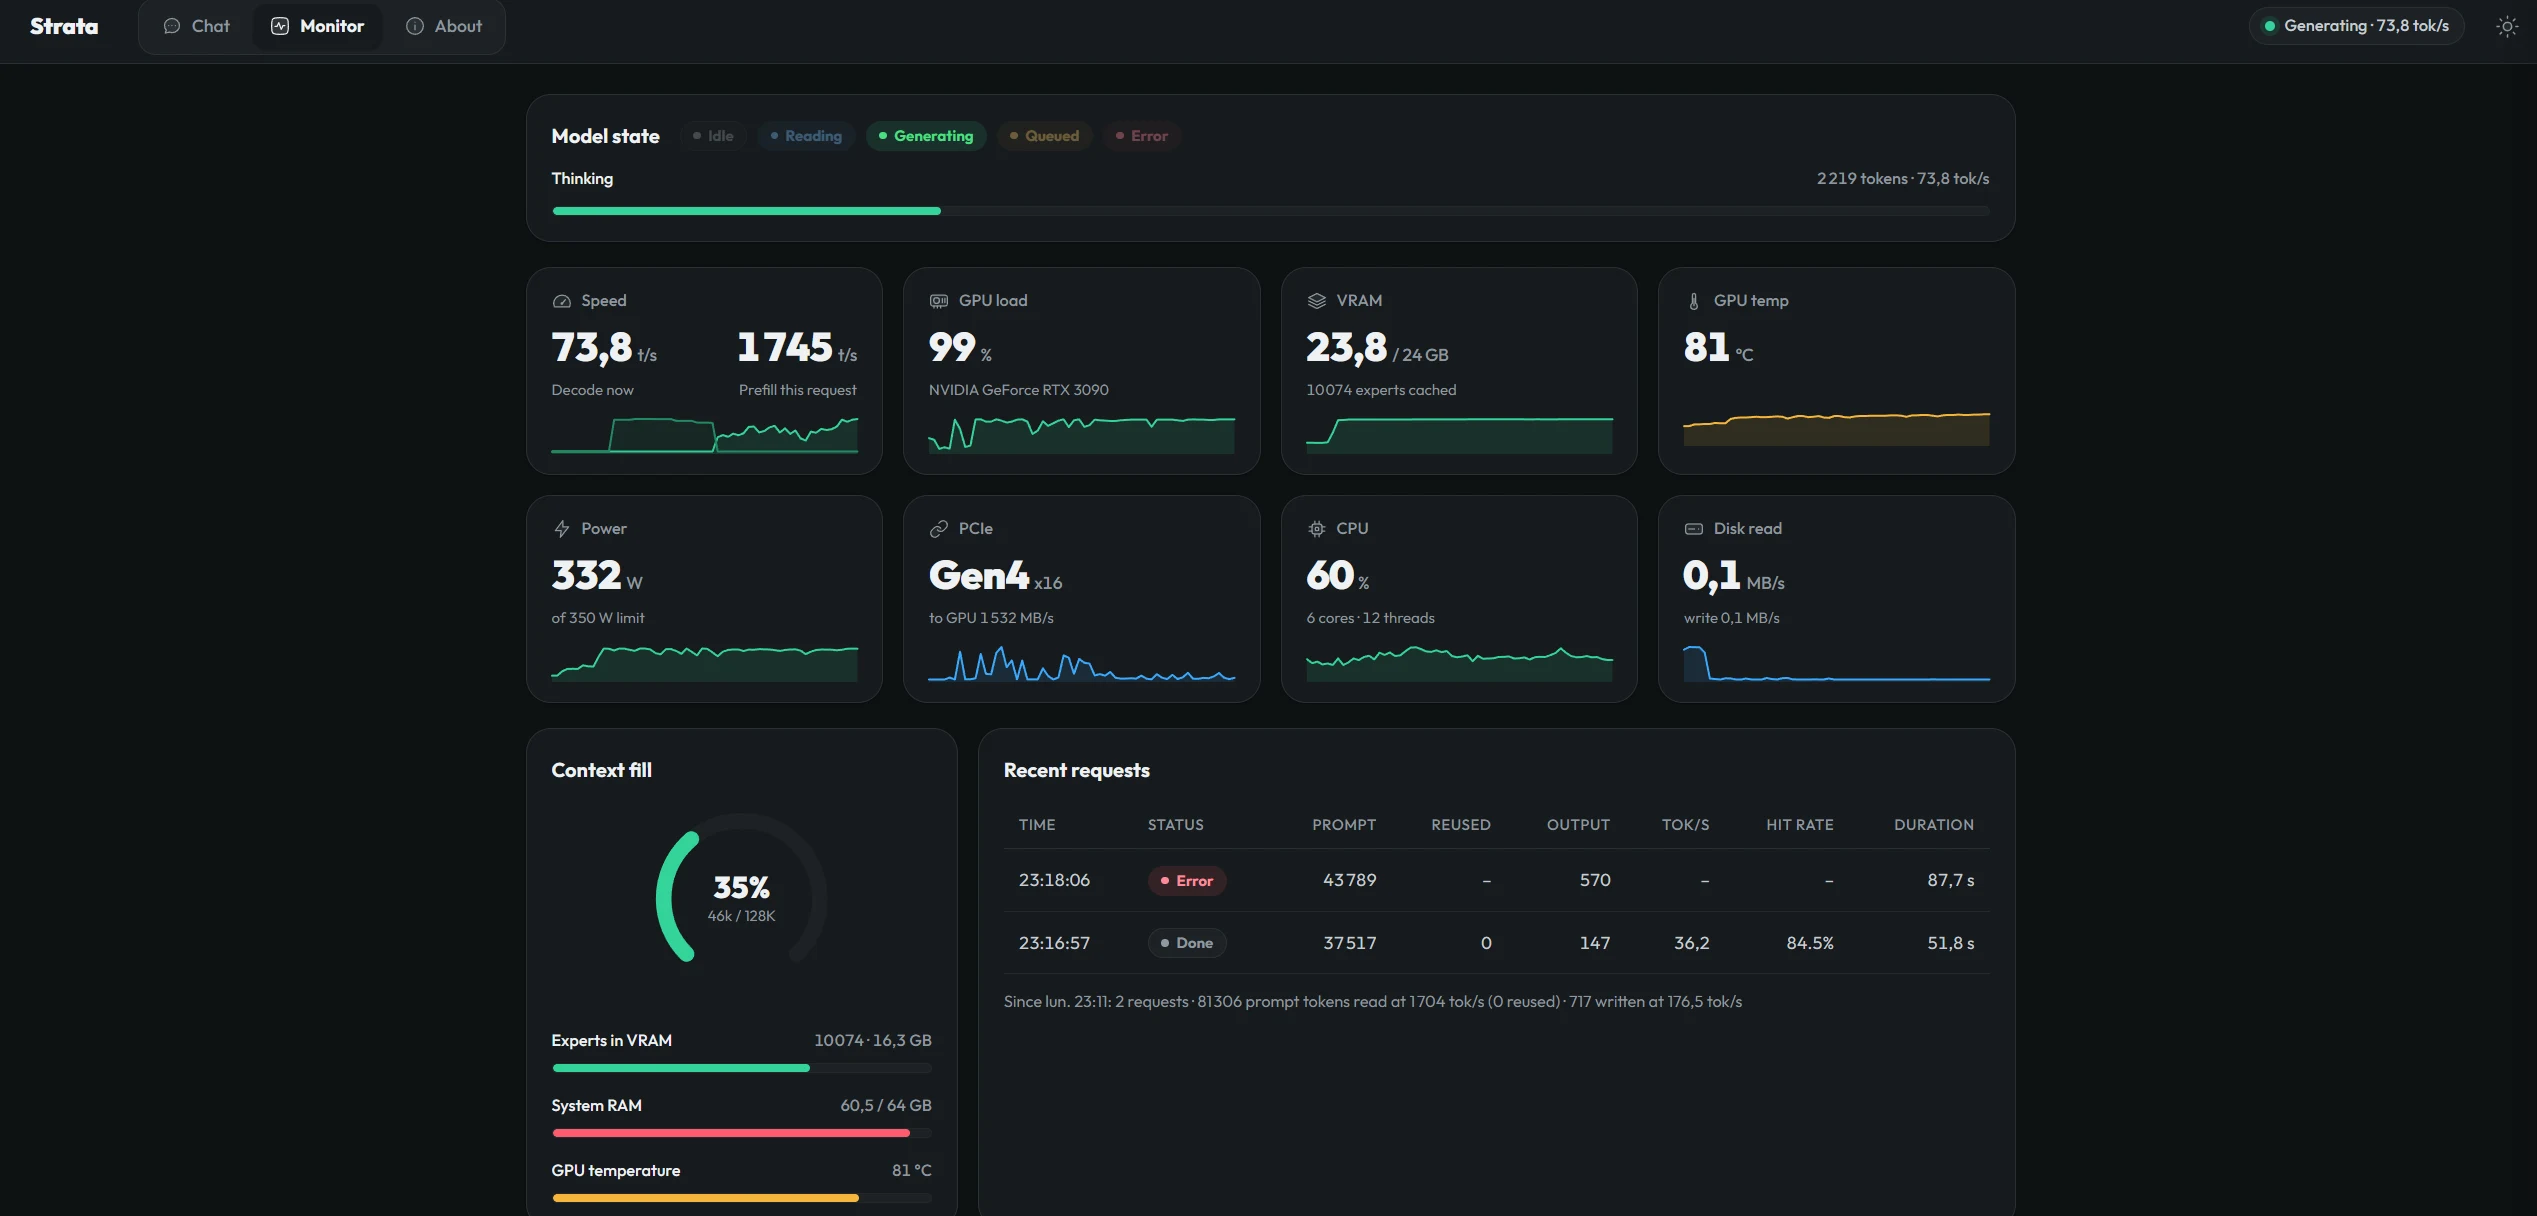
Le moniteur distingue aussi une lecture du prompt à 1 745 tokens/s du débit de génération. Il indique 23,8 Go de VRAM utilisés sur 24, environ 60,5 Go de RAM sur 64, et une consommation GPU de 332 W à cet instant. L’historique comporte une requête terminée à 36,2 tokens/s et une erreur dont la cause n’apparaît pas. Je montre la capture entière parce qu’elle documente un essai réel, avec ses variations, et non un résultat de laboratoire soigneusement isolé.
Malgré ces limites, c’est déjà une alternative solide pour mon usage agentique, où le modèle enchaîne des appels à des outils. Je peux choisir le modèle et le moteur, garder l’inférence sur ma machine et décider quels accès lui donner. Je gagne une maîtrise concrète de mon environnement, sans acheter une nouvelle workstation (station de travail).
Le logiciel repousse les limites de la mémoire
Les modèles à mélange d’experts, ou MoE, n’activent qu’une partie de leurs experts pour chaque token. La documentation technique de Strata explique comment il conserve des experts en VRAM, utilise la RAM et peut lire des poids depuis des fichiers lorsque la mémoire manque. Ce placement évite de demander que tous les poids résident en permanence sur le GPU.
Il ne faut pas confondre ce cache d’experts avec le cache KV, qui conserve des informations liées au contexte de la conversation. Déplacer des poids vers un SSD ne transforme pas ce dernier en VRAM. Les transferts, la bande passante et la latence restent déterminants, surtout quand le contexte s’allonge. Faire entrer un modèle et le servir confortablement sont deux objectifs différents.
TensorFold travaille aussi l’efficience, notamment avec du décodage spéculatif, qui propose puis vérifie plusieurs tokens. Son périmètre comprend Apple Silicon et NVIDIA. À la date de consultation, les kernels CUDA demandent une capacité de calcul 8.9 ou supérieure, donc les RTX 40 et générations compatibles, tandis que les RTX 30 sont explicitement refusées. Le projet signale lui-même des validations matérielles encore incomplètes sur certaines cartes. Je n’annonce donc ni compatibilité actuelle avec ma 3090 ni date de support future.
Ces projets ne rendent pas tous les modèles compatibles avec toutes les machines. Ils montrent néanmoins que l’achat de mémoire ou d’un nouveau GPU n’est plus le seul levier. Le moteur, le format des poids, la longueur de contexte et la manière de traiter les requêtes changent fortement le résultat.
Réserver le modèle le plus puissant aux tâches qui en ont besoin
Faire appel au plus gros modèle pour renommer un fichier ou classer un message ressemble parfois à tuer une mouche au bazooka. Certaines opérations n’ont même pas besoin d’IA. Pour les autres, un modèle local adapté peut suffire, tandis qu’un modèle frontière apporte davantage sur un cadrage difficile, une planification complexe ou une production exigeante.
Sans modèle
Renommer, déplacer ou filtrer selon des règles explicites quand aucune interprétation n’est nécessaire.
Modèle local adapté
Classer, rédiger ou rechercher dans les documents, avec des outils et des accès limités.
Modèle frontière
Planification complexe ou travail exigeant, seulement si les données et les règles autorisent un traitement externe.
C’est le prolongement de mon approche d’Hermes auto-hébergé et des données sensibles. Un agent local peut préparer des courriels, classer des documents ou alimenter un RAG, une recherche dans une base documentaire pour étayer ses réponses. Les envois, suppressions, réservations ou décisions sensibles restent à valider. Le harnais, c’est-à-dire les outils, les permissions, les contrôles et les reprises autour du modèle, fait partie de la qualité obtenue.
Un débit de 20 à 50 tokens/s peut être confortable pour beaucoup de ces tâches. Il ne suffit cependant pas à prédire le temps d’un workflow complet, avec lecture de documents, recherche et appels d’outils. Une réponse rapide ne prouve pas non plus sa justesse.
Pour quelques utilisateurs qui sollicitent la machine de façon intermittente, l’idée est crédible. Pour plusieurs générations simultanées avec de longs contextes, il faut mesurer l’attente et la mémoire consommée. Le besoin de cluster dépend de cette charge et de la disponibilité attendue, pas simplement de la taille de l’entreprise.
La course à l’efficience va aussi changer les puces
Les box de bureau ne sont qu’une partie du mouvement. Google développe ses TPU Ironwood pour l’IA à grande échelle, avec une génération pensée notamment pour l’inférence. OpenAI a de son côté présenté Jalapeño avec Broadcom et Celestica, une puce dédiée aux charges des LLM, avec un déploiement initial annoncé pour fin 2026. Ce sont des stratégies d’infrastructure, pas des cartes que l’on peut commander pour compléter son PC.
Anthropic discuterait avec Samsung, selon The Information. Aucun accord confirmé ici.
Une autre approche consiste à rapprocher le calcul des données. XCENA présente MX1, une plateforme de mémoire computationnelle utilisant CXL, une interconnexion entre processeurs, mémoire et accélérateurs. Elle associe de la DDR5 à des cœurs de calcul et prévoit une extension adossée à des SSD. Le near-data processing, ou traitement près des données, cherche à réduire les transferts plutôt qu’à seulement ajouter de la puissance de calcul centrale.
Les outils logiciels de XCENA visent notamment des traitements analytiques réalisés au plus près de la mémoire. Ce n’est ni un SSD transformé en GPU universel, ni la preuve qu’un LLM complet y tourne plus vite que sur les machines de ce comparatif. C’est une autre manière de s’attaquer aux déplacements de données et aux limites de capacité.
À mes yeux, ces pistes racontent une même évolution. L’efficience se joue dans le modèle, le moteur, la mémoire et désormais dans la spécialisation des puces. Certaines innovations concernent d’abord les centres de données, d’autres nos bureaux. Leur multiplication ouvre des possibilités, sans garantir que chacune deviendra rapidement une solution locale abordable.
Un investissement à dimensionner, pas un achat de panique
La tension sur la mémoire est documentée. Le bilan TrendForce du 30 septembre prévoit pour le quatrième trimestre une hausse trimestrielle de 10 à 15 % des prix contractuels de la DRAM conventionnelle et de 15 à 20 % de la NAND. Ce sont des prévisions sur des marchés de composants, pas une hausse uniforme garantie de chaque SSD, GPU ou ordinateur.
Je comprends l’intérêt de sécuriser une configuration utile à un prix connu. Mais un tarif de lancement ne garantit ni le meilleur achat ni une livraison immédiate. Avant de dépenser 6 000 à 9 000 €, je commencerais par tester le modèle voulu sur la machine existante, puis par estimer les économies réelles de cloud et le temps gagné.
Il faut intégrer l’électricité, l’administration, les sauvegardes et la durée d’usage. À titre de simple répartition sur trois ans, 6 499 € représentent environ 181 € par mois pour le matériel seul, avant ces dépenses. Une API peu sollicitée peut coûter moins cher. Une utilisation régulière, avec des données que l’on souhaite conserver sur place, peut justifier une machine dédiée.
Pour un cabinet, une petite structure ou un freelance, la confidentialité peut peser autant que le calcul financier. L’inférence locale réduit l’exposition à un service de modèle externe, mais un connecteur mail, une recherche web ou une télémétrie peuvent toujours communiquer avec l’extérieur. Il reste à contrôler les accès, les flux et les mises à jour. Posséder le matériel donne de l’autonomie, pas une conformité automatique.
Mon pari sur la nouvelle ruée vers l’efficience
Cette évolution dépasse les box de bureau. Google propose déjà Gemma 4 E2B et E4B dans son aperçu développeur AICore sur Android, sur les appareils compatibles. Cela illustre la place croissante de modèles adaptés au matériel, plutôt qu’un appel systématique à une infrastructure distante.
Pour moi, la nouvelle ruée vers l’or sera celle de l’efficience. Les avancées logicielles et matérielles me donnent le sentiment que laboratoires et industriels convergent vers le même objectif, faire davantage avec les ressources disponibles. Face à une demande d’IA qui s’accélère, les contraintes de raccordement des centres de données, d’approvisionnement en cartes et de disponibilité de la mémoire rendent cette recherche incontournable à mes yeux. Nous avons dépassé la simple preuve de concept et les usages s’installent. Je ne crois pas à un retour en arrière, mais à une transformation de notre manière de consommer l’IA.
Mon scénario est celui d’une détente progressive sur les GPU, à mesure que d’autres solutions de calcul et de meilleurs logiciels prennent une partie des charges. Je suis moins convaincu d’un relâchement sur la RAM et les SSD, qui restent nécessaires à ces architectures. J’envisage malgré tout une stabilisation, voire une légère baisse de certains prix de matériel et de location dans les prochains mois. C’est mon anticipation, pas une baisse acquise ou uniforme.
Je ne vois pas non plus les tarifs des API augmenter indéfiniment. En revanche, une facture stable peut masquer moins de tokens disponibles ou des quotas plus serrés. Ce serait une hausse du coût à usage égal, même sans augmentation du prix affiché. L’efficience technique ne garantit donc pas que tous ses gains seront immédiatement transmis au client.
Je ne parie pas sur un arrêt brutal de l’IA. La concurrence, notamment celle des modèles chinois à poids ouverts et des laboratoires du monde entier, me paraît plutôt pousser vers sa démocratisation. Nous répartirons davantage les usages entre ordinateurs, téléphones, box locales et cloud, en réservant chaque ressource aux tâches où elle apporte quelque chose. Je crois à une IA de plus en plus présente, consommée de manière hybride, et je pense que le meilleur reste à venir.
Sources et méthode
Sources consultées le 6 octobre 2026. Les caractéristiques et délais ci-dessous sont des annonces des vendeurs, pas des mesures indépendantes. Mon essai Strata est un retour personnel, sans protocole comparatif contrôlé.
Framework, annonce du 30 septembre 2026 et configurateur français. La capture fournie documente les 7 659 € affichés pour 192 Go ; le configurateur n’a pas pu être relu par l’outil de recherche.
Lucebox, boutique et configurations et présentation du moteur. Prix, supplément mémoire, architecture et livraison annoncée.
Ghost Core, fiche officielle. Prix en dollars, CPU, RAM, GPU et positionnement logiciel.
NVIDIA, annonce DGX Spark 64 Go du 2 octobre et fiche DGX Spark 128 Go. L’annonce 64 Go et son tarif ont été retrouvés dans l’index de recherche officiel ; la page complète n’était pas accessible lors de cette vérification.
Strata, dépôt du projet et documentation technique. Modèle pris en charge et gestion des experts en mémoire. Le débit de ma capture n’est pas celui d’un test fourni par le projet.
Hugging Face, Mixture of Experts Explained. Paramètres totaux et actifs des MoE. Les plafonds du tableau sont mes calculs, avec hypothèses explicites, pas des benchmarks constructeur.
TensorFold, documentation du dépôt. Compatibilité et limites CUDA observées à cette date, susceptibles d’évoluer.
TrendForce, prévisions du 30 septembre 2026. Évolution attendue des prix contractuels DRAM et NAND.
Google Ironwood, 2025-04-09.
OpenAI Jalapeño, 2026-06.
The Information, 2026-07-02.
Google, aperçu développeur AICore du 2 avril 2026. Modèles locaux sur Android compatible, référence retrouvée dans l’index de recherche officiel.
Les captures produits et tarifs datent du 6 octobre, celle de Strata du 5 octobre. L’illustration de couverture est générée avec l’IA et s’appuie sur les boîtiers des captures et une RTX 3090 Founders Edition de référence. Elle ne constitue pas une photographie de matériels que j’aurais tous testés.