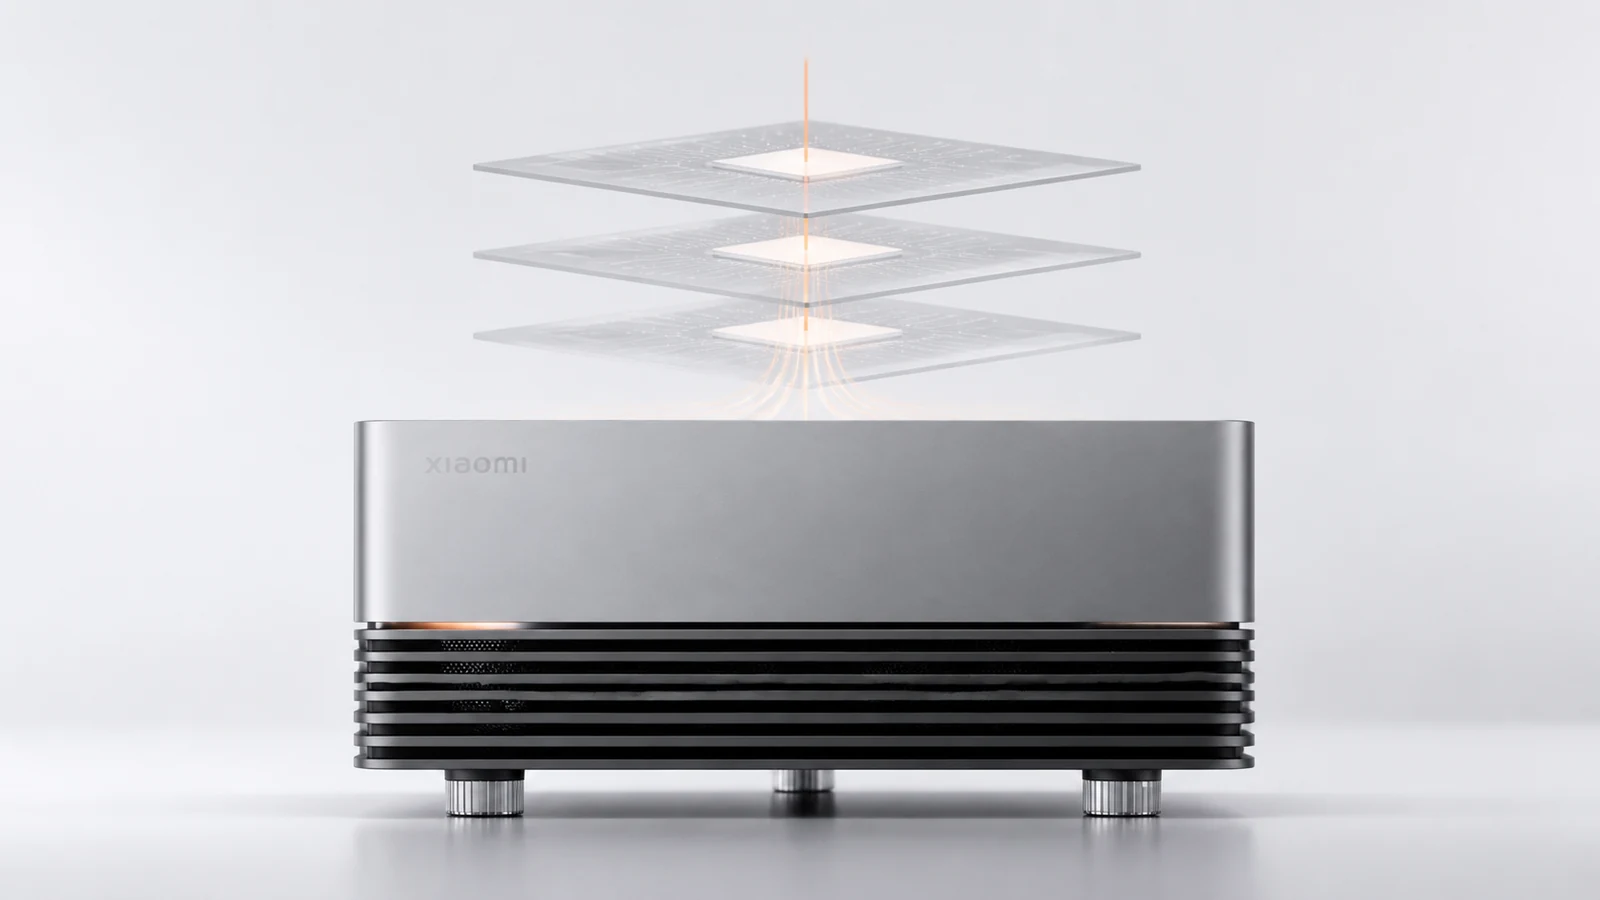
Le 24 août 2026, Xiaomi a montré un objet que je vais suivre de très près. L'AI Cube est un prototype de terminal IA de bureau pensé pour exécuter de grands modèles sans envoyer chaque requête dans le cloud.
La promesse dépasse le simple mini-PC. Xiaomi ne met pas un accélérateur acheté sur étagère dans un joli boîtier. Le groupe assemble trois puces XRING maison, les rapproche de ses modèles MiMo et tente de contrôler la chaîne complète, du silicium au modèle. C'est cette intégration qui peut rebattre les cartes face au NVIDIA DGX Spark et aux autres machines GB10.
Sur le papier, l'AI Cube est une alternative crédible au DGX Spark. Sa bande passante near-memory et son intégration avec MiMo sont très séduisantes. Mais le prix, la date de sortie, le runtime et les performances réelles restent inconnus. Aujourd'hui, on analyse un prototype, pas une machine achetable.
Ce que Xiaomi a réellement montré
Le prototype présenté à la conférence XRING associe les puces O3, O100 et D100. La machine de démonstration dispose de 80 Go de mémoire unifiée, fonctionne à une puissance soutenue de 150 W et exécute localement une configuration annoncée comme « 120B + 3B ». Xiaomi parle d'une bascule entre un système rapide et un système lent, probablement pour répartir les tâches entre un petit modèle réactif et un modèle plus lourd.
Le châssis monobloc en aluminium compte 33 874 ouvertures usinées CNC. Le chiffre est spectaculaire, mais la partie vraiment importante se trouve à l'intérieur. Xiaomi essaie de répartir les charges entre calcul généraliste, accélération à très haute bande passante et grande capacité mémoire.
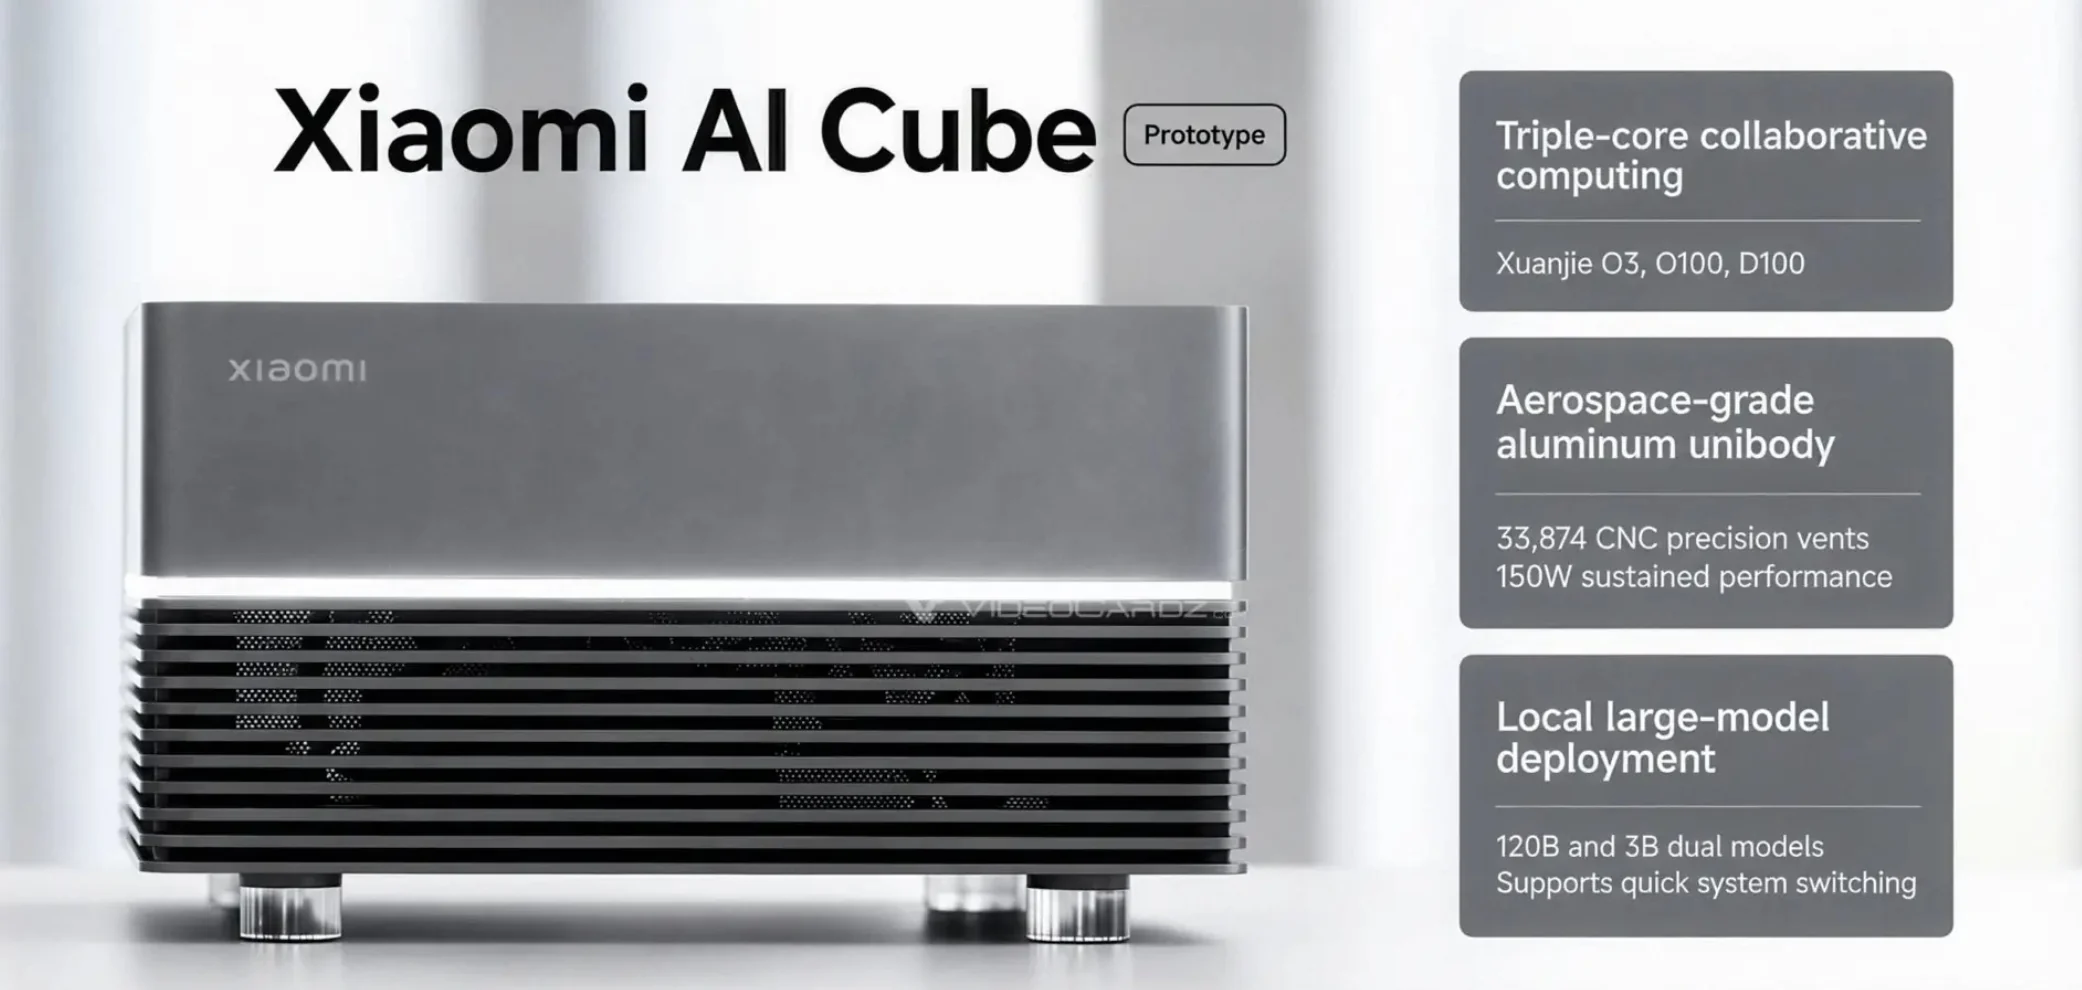
| Élément annoncé | Prototype Xiaomi AI Cube | Ce qu'il faut comprendre |
|---|---|---|
| Puces | XRING O3, O100 et D100 | Architecture hétérogène à trois moteurs |
| Mémoire du prototype | 80 Go unifiés | Moins que le DGX Spark actuel |
| Modèles en démonstration | 120B + 3B | Modèles, précision et contexte non détaillés |
| Puissance soutenue | 150 W | Enveloppe proche d'une station IA compacte |
| Statut | Prototype | Aucun prix ni lancement commercial annoncé |
Trois puces pour trois rôles
Le XRING O3 joue le rôle de SoC généraliste. Xiaomi annonce un CPU à 10 cœurs, un GPU G2-Ultra NX à 16 cœurs et un NPU de 200 TOPS. C'est le chef d'orchestre, capable de gérer le système, les entrées utilisateur et les tâches légères.
L'O100 est la pièce la plus originale. Cet accélérateur 6 nm empile la mémoire et le calcul au niveau wafer grâce à un packaging 3D. Xiaomi annonce 28 672 connexions de données et 1,22 To/s de bande passante near-memory. Pour les LLM, cette proximité compte énormément, car la génération de tokens passe son temps à déplacer les poids entre mémoire et unités de calcul.
Le D100 vient du monde automobile. Cette puce 3 nm associe un CPU à 20 cœurs, un NPU à 16 cœurs et un contrôleur capable de gérer jusqu'à 160 Go de mémoire. Dans le Cube, elle semble apporter la capacité et l'endurance nécessaires aux modèles plus lourds.
Les 1,22 To/s appartiennent à l'O100 et à sa mémoire proche. Ce n'est pas la preuve que les 80 Go du système disposent tous de cette bande passante. Il faudra connaître la topologie mémoire et mesurer un modèle complet avant de comparer directement ce chiffre aux 273 Go/s du DGX Spark.
AI Cube, DGX Spark et Strix Halo
Le DGX Spark reste la référence la plus simple à comprendre. Son GB10 offre 128 Go de mémoire unifiée à 273 Go/s, jusqu'à 1 PFLOP FP4 et surtout un environnement CUDA déjà exploitable. On sait ce que la machine fait, quels moteurs fonctionnent et comment relier deux unités.
Du côté AMD, le bon nom est Strix Halo, ou Ryzen AI Max+ 395. Ces mini-PC proposent jusqu'à 128 Go de mémoire unifiée et 256 Go/s. Le matériel n'est pas coincé dans une impasse. ROCm prend désormais officiellement en charge les APU Ryzen AI Max sous Linux et Windows, avec PyTorch, Ollama, llama.cpp ou LM Studio. L'écart existe néanmoins. Beaucoup d'optimisations sortent d'abord pour CUDA, et certaines recettes demandent encore davantage d'adaptation sur AMD.
| Machine | Mémoire | Bande passante publiée | Écosystème | Disponibilité |
|---|---|---|---|---|
| Xiaomi AI Cube | 80 Go sur le prototype D100 jusqu'à 160 Go | 1,22 To/s sur l'O100 near-memory | XRING + MiMo, runtime public inconnu | Prototype |
| NVIDIA DGX Spark | 128 Go unifiés | 273 Go/s | CUDA, TensorRT-LLM, PyTorch | Commercialisé |
| AMD Ryzen AI Halo | 128 Go unifiés | 256 Go/s | ROCm, PyTorch, Ollama, llama.cpp | Commercialisé |
L'AI Cube ne gagne donc pas automatiquement. Il propose une autre architecture. Si l'O100 alimente réellement les experts actifs à très haute vitesse pendant que le D100 conserve une grande partie des poids, Xiaomi peut obtenir un excellent débit sans reproduire exactement le modèle de mémoire unifiée du GB10.
Le logiciel décidera du vainqueur
Le matériel ne suffit pas. CUDA est devenu une avance faite de milliers de bibliothèques, de kernels, de profils d'optimisation et de comportements connus. C'est la raison pour laquelle une machine NVIDIA obtient souvent de bons résultats rapidement, même lorsqu'une alternative affiche une fiche technique proche.
AMD illustre bien le problème. Strix Halo est très capable et ROCm progresse vite, mais les développeurs doivent encore vérifier les versions, les opérateurs et les quantifications compatibles. Ce n'est plus le désert logiciel parfois décrit, ce n'est pas encore la tranquillité de CUDA.
Xiaomi peut contourner une partie de ce retard en optimisant une pile plus étroite. L'entreprise contrôle les puces XRING, HyperOS, ses runtimes et la famille MiMo. Au lieu de viser tous les modèles sur tous les frameworks dès le premier jour, elle peut obtenir des performances très fortes sur quelques architectures chinoises bien choisies. C'est moins universel, mais potentiellement beaucoup plus efficace.
MiMo, DeepSeek et le bond du MoE
Le rapprochement avec MiMo est logique. Xiaomi a déjà démontré un prototype mobile O3 + O100 exécutant un modèle MiMo à 295 tokens par seconde. MiMo-V2-Flash repose sur une architecture Mixture-of-Experts de 309 milliards de paramètres, avec environ 15 milliards actifs par token. MiMo-V2.5 conserve cette logique et vise directement les usages agentiques.
Les modèles chinois ont largement comblé l'écart avec les meilleurs modèles américains sur de nombreux usages de code, de raisonnement et d'agents. MiMo, DeepSeek, Qwen ou Kimi combinent désormais qualité, poids ouverts pour certains modèles et architectures MoE très efficaces. Une machine conçue autour de leurs besoins peut donc devenir autre chose qu'une alternative économique. Elle peut être une plateforme de premier plan.
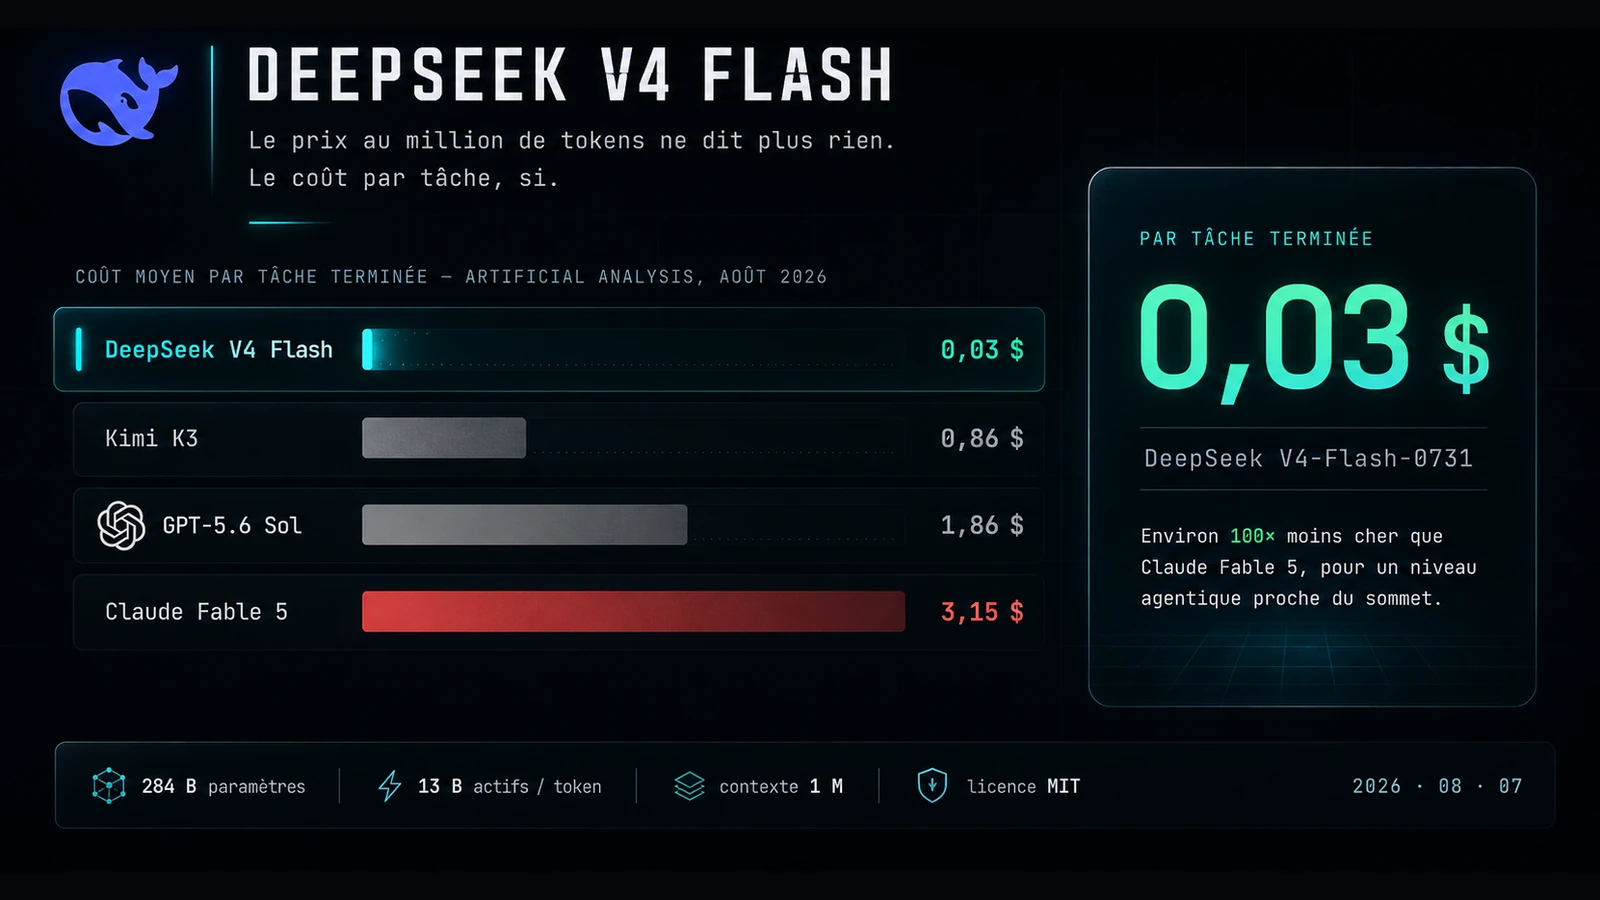
Le MoE change aussi la perception de la taille. DeepSeek V4 Flash compte environ 285 milliards de paramètres, mais n'en active que 13 milliards par token. Les poids complets doivent toujours être stockés, ce qui rend la capacité mémoire importante. En revanche, le débit dépend beaucoup de la vitesse à laquelle les experts actifs sont alimentés. C'est précisément là que l'O100 et sa mémoire proche peuvent avoir du sens.
Des recettes communautaires font déjà tourner DeepSeek V4 Flash sur un DGX Spark avec des quantifications très agressives, tandis que la version native demande plutôt deux machines. Il faut accepter des compromis de précision, de contexte et de runtime, mais le mouvement est clair. Des modèles agentiques extrêmement capables commencent à entrer sur un bureau.
Ce que cela change pour les agents locaux
Pour un agent local, la mémoire ne sert pas uniquement à charger un gros chatbot. Elle permet de garder plusieurs briques actives en même temps. Un modèle 120B peut assurer le raisonnement complexe, tandis qu'un 3B répond vite, classe les demandes ou surveille les événements. Un modèle de vision, un moteur d'embeddings et un reranker peuvent compléter la chaîne.
- Développement assisté. Un agent peut explorer un dépôt, générer du code et lancer des outils sans envoyer la base de code dans un cloud tiers.
- RAG privé. Les documents, embeddings et réponses restent sur la machine.
- Agents spécialisés. Plusieurs rôles peuvent partager une plateforme tout en utilisant des modèles de tailles différentes.
- Multimodalité locale. Captures d'écran, documents et images peuvent être traités sans transfert externe si le runtime le permet.
- Coût prévisible. Une charge régulière se transforme en investissement matériel et en électricité plutôt qu'en facture variable de tokens.
Pour un usage comme Hermes Agent sur un poste de travail, ce type de machine peut devenir un véritable serveur personnel. Les agents restent accessibles depuis le réseau local, conservent leur mémoire et utilisent un modèle ouvert suffisamment fort pour accomplir de longues tâches.
Les inconnues qui comptent
Le prototype est impressionnant, mais les inconnues sont encore nombreuses. On ne connaît ni son prix, ni sa date de vente, ni ses interfaces, ni son stockage. Xiaomi n'a pas publié de benchmark comparable au DGX Spark, de consommation réelle en inférence ou de protocole permettant de reproduire la démonstration 120B.
La question logicielle reste encore plus importante. Quel système sera livré ? Le prototype observé utilisait Android. Disposerons-nous d'un Linux complet, de pilotes documentés, d'un équivalent de vLLM ou SGLang et d'outils pour charger librement des poids Hugging Face ? Sans ces réponses, l'AI Cube peut rester une excellente démonstration verticale limitée aux modèles choisis par Xiaomi.
Il faut aussi éviter de confondre local et souverain. Garder les données chez soi améliore fortement la confidentialité. La souveraineté demande en plus de maîtriser les pilotes, les mises à jour, le firmware, la télémétrie et la possibilité de changer de modèle. Une boîte fermée qui exécute un modèle local n'offre pas le même contrôle qu'une plateforme documentée et ouverte.
Mon verdict
Cette machine m'intéresse vraiment. Si Xiaomi commercialise une version proche de ce prototype, avec un prix voisin du DGX Spark, un runtime ouvert et une compatibilité propre avec MiMo, DeepSeek et les moteurs standards, l'offre peut être agressive. La bande passante near-memory promet un débit largement supérieur sur les modèles optimisés, et la capacité annoncée suffit déjà à construire une plateforme locale très sérieuse.
Je ne vendrais pas encore mon GPU sur une slide. Le DGX Spark a moins de bande passante sur le papier, mais il existe, dispose de 128 Go et bénéficie de CUDA. L'AI Cube doit encore prouver qu'il transforme ses trois puces en une expérience développeur cohérente.
Pour moi, le signal est pourtant majeur. L'IA locale ne se résume plus à NVIDIA face à quelques mini-PC AMD. Xiaomi arrive avec ses propres puces, ses propres modèles et une vision de bout en bout. Si cette vision devient un produit achetable, j'envisagerai très sérieusement son acquisition pour de l'inférence locale.
Questions rapides
Qu'est-ce que le Xiaomi AI Cube ?
Le Xiaomi AI Cube est un prototype de terminal IA de bureau qui associe les puces XRING O3, O100 et D100 pour exécuter de grands modèles en local.
Quand sera-t-il disponible et à quel prix ?
Xiaomi n'a annoncé ni prix ni date de commercialisation. Les puces O100 et D100 sont prévues pour une utilisation commerciale en 2027, mais cela ne garantit pas la vente de l'AI Cube.
Est-il plus rapide que le DGX Spark ?
Impossible de le conclure aujourd'hui. Les 1,22 To/s concernent la mémoire proche de l'O100, tandis que le DGX Spark documente 273 Go/s pour ses 128 Go unifiés. Aucun benchmark comparable de bout en bout n'est encore public.
Pourra-t-il faire tourner MiMo ou DeepSeek en local ?
Le prototype a exécuté une configuration 120B et 3B, et Xiaomi optimise déjà ses puces XRING pour MiMo. La compatibilité exacte, la quantification et le runtime pour MiMo ou DeepSeek n'ont pas été publiés.
Sources
- VideoCardz, présentation du Xiaomi AI Cube et des trois puces XRING.
- IT Home, annonce du prototype AI Cube à la conférence XRING.
- IT Home, 80 Go de mémoire, MiMo et démonstrations locales.
- Portail de Pékin, calendrier commercial des puces XRING.
- NVIDIA, spécifications officielles du DGX Spark.
- AMD, spécifications du Ryzen AI Halo Developer Platform.
- AMD ROCm, inférence LLM sur Ryzen AI Max.
- Xiaomi MiMo, model card officielle de MiMo-V2.5.
- Xiaomi MiMo, rapport technique MiMo-V2-Flash.
- DeepSeek, model card officielle de DeepSeek V4.