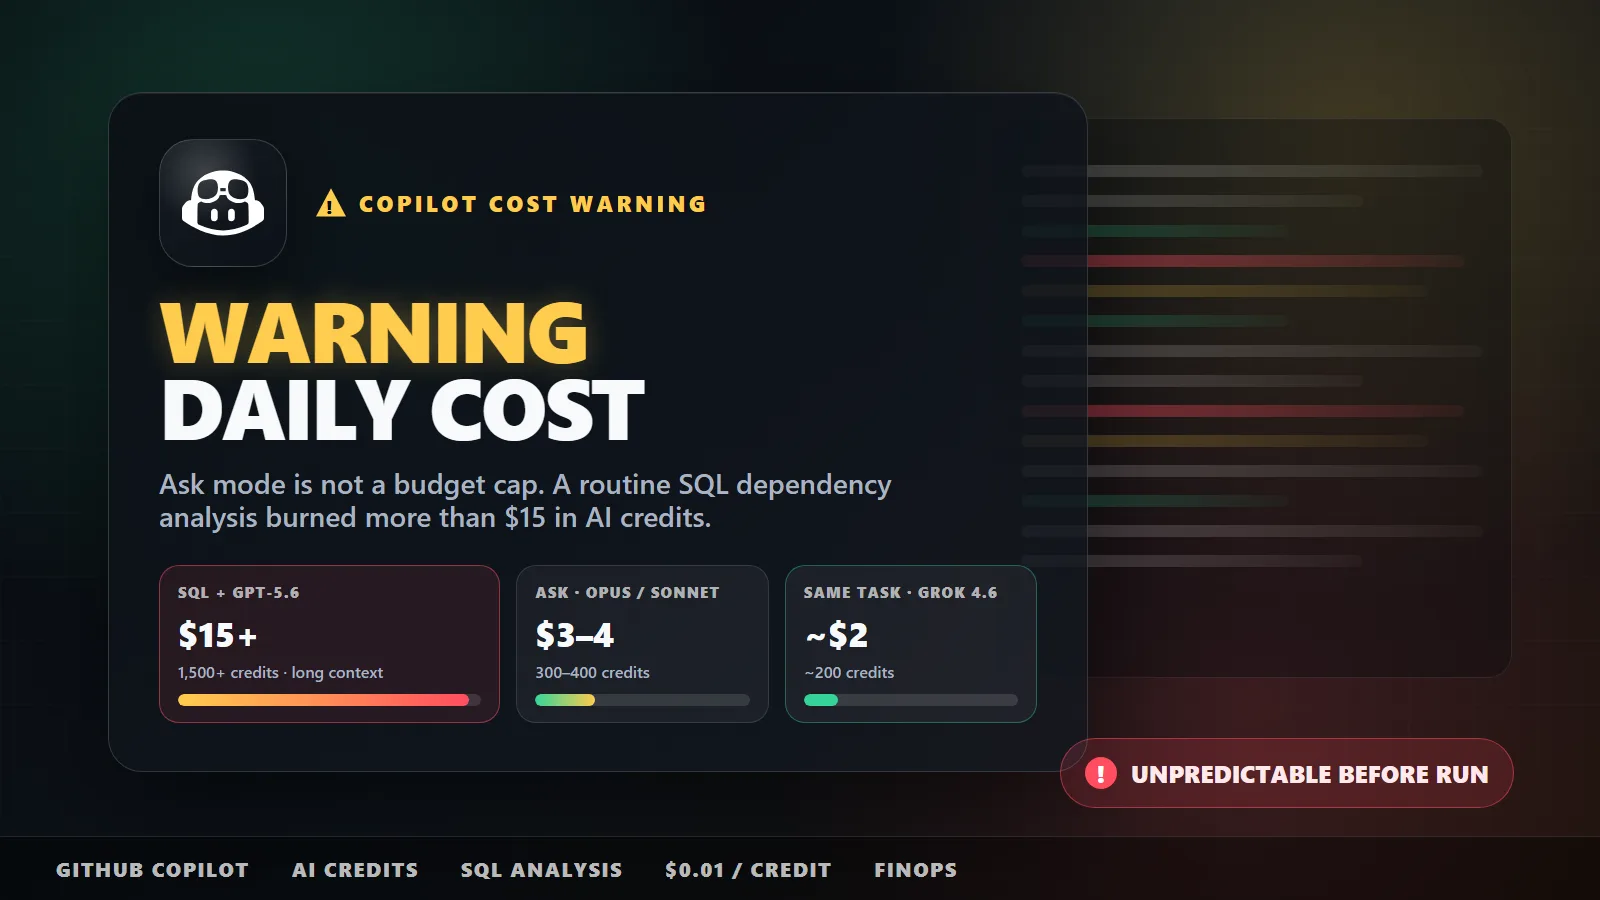
L’autocomplétion reste un très bon argument. Le chat et les agents, eux, me font désormais hésiter avant de lancer une tâche courante, parce que le coût réel n’est visible qu’après coup.
Un produit auquel je croyais
Je trouvais le positionnement excellent. Un assistant directement dans VS Code, au contact du code, avec tout l’intérêt que cela représente dans un environnement Microsoft, Azure et Data. L’autocomplétion reste, à mes yeux, l’un de ses meilleurs arguments. Le chat et les agents avaient prolongé cette promesse.
Je ne critique donc pas un produit que je n’utilise pas. Je critique un outil que j’appréciais, et dont le fonctionnement économique me fait maintenant hésiter avant de lancer une tâche.
Depuis le 1er juin 2026, GitHub remplace les requêtes premium (premium requests) par une consommation en AI Credits, calculée à partir des tokens et du modèle. L’abonnement n’a pas disparu. Il inclut une enveloppe, puis du dépassement peut être facturé selon les paramètres du compte. L’autocomplétion et les suggestions de prochaine modification (next edit suggestions) restent incluses sans consommer ces crédits sur les offres payantes. J’avais déjà posé le cadre dans GitHub Copilot, la fin de l’open bar et le réveil FinOps.
Ce que je constate sur mes tâches SQL
Voici quelques consommations que j’ai observées, pas une moyenne de tous mes prompts.
| Usage observé | Crédits consommés | Équivalent au tarif du crédit |
|---|---|---|
| Questions en mode Ask, avec Claude Opus ou Sonnet en niveau de raisonnement moyen | 300 à 400 | 3 à 4 $ |
| Analyse de dépendances SQL avec GPT-5.6, dans une conversation au contexte très chargé, supérieur à 500 000 tokens | Plus de 1 500 | Plus de 15 $ |
| Nouvel essai de la même analyse avec Grok 4.6 | Environ 200 | Environ 2 $ |
Un crédit vaut 0,01 dollar américain. Il s’agit ici d’une valeur de consommation, pas nécessairement d’un supplément sur la facture. Les crédits peuvent provenir de l’enveloppe incluse. Ces essais ne constituent pas non plus un benchmark (protocole de comparaison) à contexte, cache et nombre d’appels strictement identiques.
Cela n’enlève rien au problème. Consommer l’équivalent de plus de 15 dollars pour analyser les dépendances d’une table SQL, je le trouve excessif sur ce cas d’usage. Descendre à 2 dollars avec Grok 4.6 est mieux. Mais cela ne rend pas automatiquement acceptable la répétition de ces coûts dans le travail quotidien.
Je dispose pourtant d’une enveloppe confortable dans mon contexte d’intervention. Un quota généreux masque plus longtemps le problème. Il ne change pas le coût de la tâche.
La petite question et le gros contexte
Je connais l’objection. Une question courte ne signifie pas un petit appel au modèle.
L’historique, les fichiers, les instructions et les outils peuvent peser beaucoup plus lourd que la phrase saisie dans le chat. Une interaction agentique peut aussi déclencher plusieurs appels successifs. L’équipe VS Code documente elle-même ces coûts, et ses efforts pour les réduire, notamment le cache du préfixe de prompt et le chargement à la demande des définitions d’outils.
Le contexte long ajoute une autre difficulté. Pour GPT-5.6 Sol, la grille Copilot consultée le 15 septembre applique au-delà de 272 000 tokens d’entrée un tarif doublé en entrée (4 $ puis 8 $ par million) et multiplié par 1,5 en sortie (20 $ puis 30 $). Ce n’est pas une règle universelle pour tous les modèles.
Je ne prétends donc pas que mon analyse SQL n’a techniquement consommé que trois petits fichiers. Je dis que le périmètre fonctionnel de ma demande ne me permet pas d’anticiper son coût réel.
Et c’est précisément le problème produit. Le mode Ask n’est pas une garantie de faible consommation. Un réglage de raisonnement moyen n’est pas un plafond budgétaire.
Septembre semble pire, mais je distingue le constat de la cause
J’avais cru retrouver un certain confort pendant l’été. En septembre, je constate à nouveau des consommations que je trouve disproportionnées.
Il existe un changement documenté à ne pas confondre avec une hausse du prix des prompts. Les crédits promotionnels Business et Enterprise étaient prévus pour juin, juillet et août. Les enveloppes standard sont respectivement de 1 900 et 3 900 crédits par siège, contre 3 000 et 7 000 pendant la promotion. Cela peut accélérer l’épuisement d’un budget concerné. Cela ne peut pas, à lui seul, expliquer qu’une même tâche consomme davantage de crédits.
Des témoignages récents expriment une frustration comparable. Le 9 septembre, un utilisateur expliquait renoncer au déploiement auprès de ses collègues. Le 11 septembre, un autre rapportait avoir consommé 1 500 crédits en six heures. Ce sont des retours individuels, pas la preuve d’un changement tarifaire caché.
À ce stade, je n’ai pas identifié dans les annonces consultées de hausse générale des tarifs au token en septembre expliquant mes relevés. Sans les traces détaillées des sessions, je ne peux pas attribuer cette évolution à une cause précise.
Un plafond protège le budget, pas la productivité
GitHub propose des budgets par utilisateur et par organisation, ainsi que d’autres contrôles de dépense. Dire qu’il n’existe aucun levier FinOps serait faux. Des limites souples de crédits existent aussi dans Copilot CLI, en préversion. Elles peuvent être dépassées par la réponse déjà en cours.
Mais bloquer la consommation n’est pas la même chose que prévoir combien de travail utile une équipe pourra réaliser avec son budget.
Une DSI doit pouvoir arbitrer un coût par tâche terminée et validée, pas seulement définir le montant auquel les développeurs seront interrompus. Une tâche à 15 dollars peut être rentable si elle évite plusieurs heures de travail. Mon problème est la répétition de consommations élevées sur des demandes courantes, sans visibilité suffisante avant de les lancer.
Compacter le contexte ne suffit pas
Ouvrir une nouvelle conversation, limiter les fichiers ou compacter l’historique sont des leviers utiles. GitHub recommande aussi de préserver le cache et d’éviter les changements inutiles de configuration.
Mais repartir à zéro et compacter ne sont pas équivalents. Un résumé peut perdre une information dont l’analyse a besoin. Il faut alors réexpliquer, relire ou corriger. L’économie sur un appel peut être annulée par les suivants. Ce n’est pas systématique. C’est le compromis à mesurer.
Le bon indicateur reste le coût du résultat exploitable, corrections comprises. J’avais déjà posé cette lecture du coût par tâche agentique avec DeepSeek V4 Flash.
GitHub a annoncé le 14 septembre trois orientations pour la sélection automatique des modèles, efficacité, équilibre et intelligence, avec une réduction de 10 % pour les abonnés payants utilisant Auto. C’est un levier supplémentaire, pas une garantie sur le coût final d’une tâche. L’usage reste facturé selon le modèle réellement choisi.
Reprendre la main sur la facture
Il vous faut tester, dans vos usages, ces différentes pistes. Surveiller le compteur ne dit pas où une tâche doit vraiment s’exécuter.
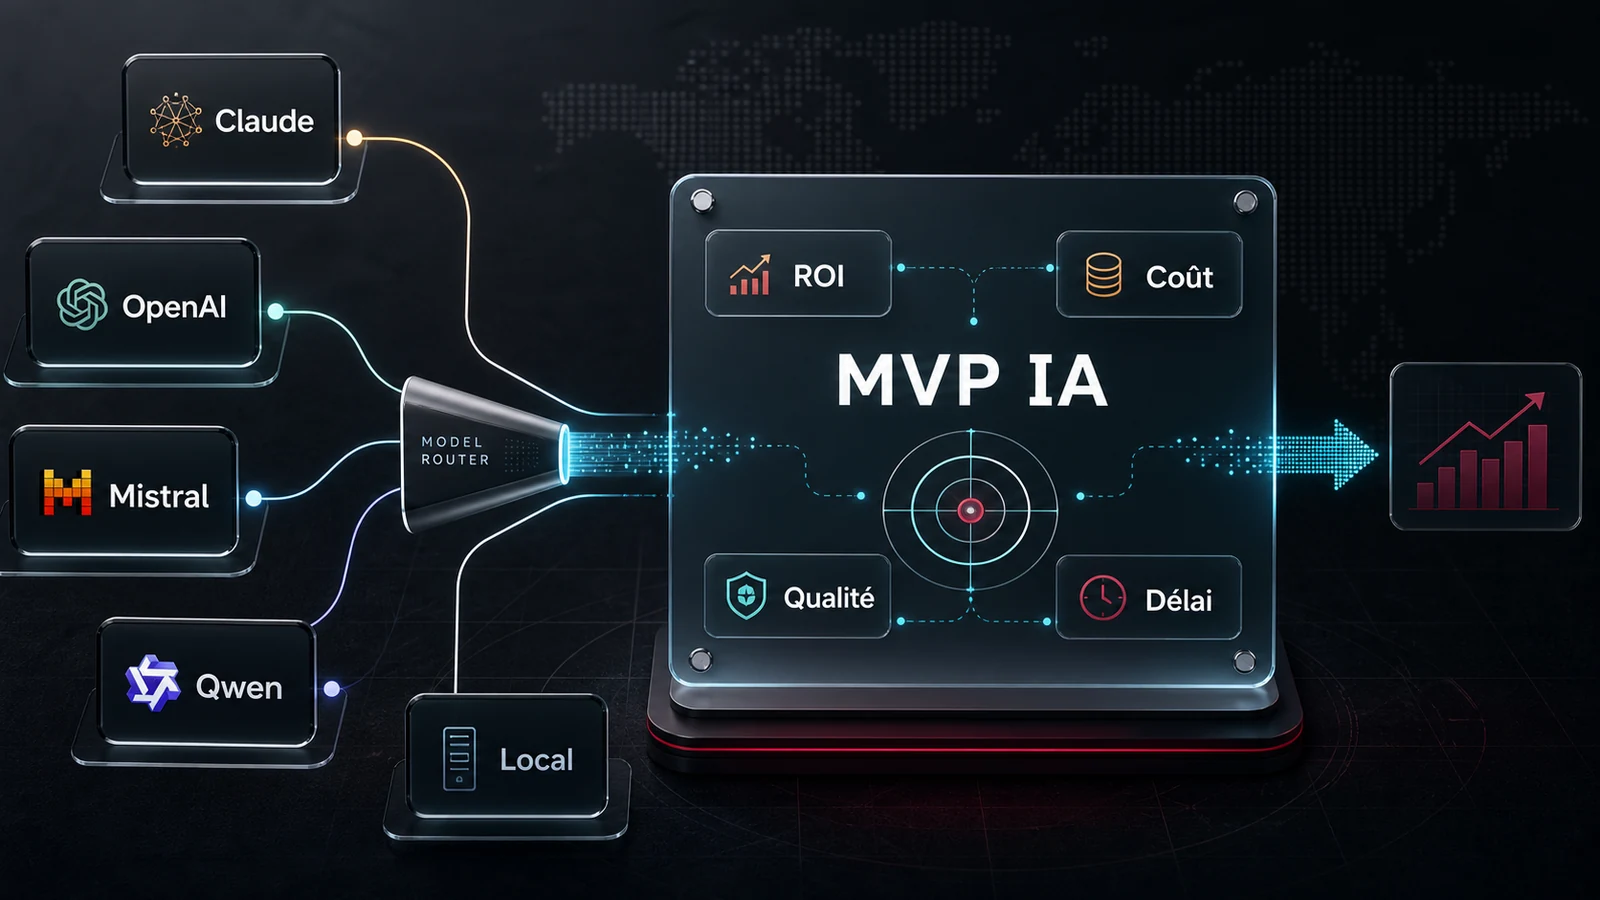
Le BYOK (Bring Your Own Key, apporter sa propre clé API). Utiliser sa propre clé dans VS Code et comparer la facture du fournisseur aux crédits Copilot consommés sur les mêmes tâches courantes. L’économie n’est pas acquise. Il faut tenir compte des crédits déjà inclus et des reprises nécessaires.
Le GPU loué. Nebius, Scaleway, Runpod. Louer une capacité pour héberger des modèles à poids ouverts, avec une durée et un budget définis, éventuellement un engagement selon l’offre. L’objectif est de budgéter du calcul plutôt que chaque prompt, frais annexes compris.
Le GPU local, avec un endpoint depuis Copilot. Garder Copilot comme interface dans VS Code, et pointer une partie des appels vers une machine que vous maîtrisez. Un Mac Studio M5 Ultra, un DGX Spark ou un mini-PC IA GB10, éventuellement un cluster, peuvent servir d’endpoint local pour les tâches courantes et limiter le choc des crédits. Ce n’est pas une rentabilité automatique. Il reste l’électricité, l’exploitation, et le fait que tout le travail n’y tient pas. C’est un levier pour le volume quotidien, pas un remplacement universel des modèles frontier.
Ces pistes ne remplacent pas une stratégie. Elles en font partie. J’avais déjà posé le cadre dans IA en entreprise, ne choisissez pas un modèle, choisissez une stratégie, et le coût de rester trop longtemps dans un seul écosystème dans le triptyque Astra, Fable, Grok.
Le fil conducteur reste le même. Choisir où exécuter chaque tâche, et comparer le coût du résultat validé, pas seulement le prix du token.
Le risque est de décourager l’usage
Dans mes autres outils, je ne retrouve pas le même sentiment de consommation excessive. Mais je ne transforme pas ce ressenti en comparatif tarifaire universel.
Mon reproche est ailleurs. Je veux pouvoir déléguer une analyse courante sans devoir surveiller le compteur comme une opération exceptionnelle.
Ce que j’attends, ce sont des estimations avant exécution, une alerte avant un traitement coûteux, et une lecture claire des dépenses par tâche. Pas seulement un compteur qui m’explique après coup que mon budget a fondu.
Microsoft avait, selon moi, un excellent produit entre les mains. Le risque n’est pas que Copilot disparaisse demain. C’est que les utilisateurs limitent le chat et les agents, conservent seulement l’autocomplétion, puis réalisent leurs tâches importantes ailleurs.
Un assistant qu’on hésite à solliciter à cause de son coût a déjà perdu une partie de sa valeur.
Sources
Les montants des trois essais proviennent de mon retour d’expérience, sans audit externe des sessions. Les sources suivantes documentent la facturation, les mécanismes techniques et les témoignages publics. Vérification effectuée le 15 septembre 2026.
- GitHub Changelog, 1er juin 2026. Mise en service de la facturation à l’usage
- GitHub Docs. Facturation des organisations, valeur des crédits et enveloppes actuelles
- VS Code, 17 juin 2026. Travail sur l’efficience des tokens
- GitHub Docs. Grille des modèles dans Copilot, dont GPT-5.6 Sol long contexte
- OpenAI. Fiche GPT-5.6 Sol
- GitHub Docs. Optimisation de l’usage, du contexte et du cache
- GitHub Blog, 27 avril 2026. Annonce et période promotionnelle de juin à août
- Discussion communautaire GitHub, dont un témoignage du 9 septembre
- Discussion communautaire, commentaire de Donny1717 du 11 septembre
- GitHub Docs. Limites souples de session dans Copilot CLI
- GitHub Changelog, 14 septembre 2026. Niveaux de sélection automatique
- VS Code Docs. Facturation des modèles avec clé externe
- Nebius. Location GPU à la demande
- Scaleway. Instances GPU
- Runpod. Tarifs Pods
- FinOps Foundation. Coût complet des infrastructures détenues