En hébergeant GLM‑5.3, Mistral reconnaît commercialement que la meilleure réponse à un besoin client peut venir d’un autre laboratoire. J’y vois un aveu de retard sur certains usages, mais aussi une adaptation intelligente. Capter la valeur de l’inférence et de la confiance peut compter autant que produire les poids du modèle.
Une nouvelle étape, pas un virage apparu hier
L’annonce relayée le 21 septembre 2026 présente GLM‑5.3 dans Vibe Code pour les offres Pro, Team et Enterprise, avec un hébergement annoncé dans l’Union européenne. Mais la chronologie mérite d’être précisée. La fiche du modèle chez Mistral est datée du 15 septembre et le classe en Public Preview. L’ouverture aux modèles tiers avait été annoncée dès le 11 août, avec GLM‑5.2.
Ce qui m’intéresse dépasse donc l’ajout d’un nom dans un sélecteur. Mistral devient aussi l’endroit où l’on peut consommer l’intelligence produite ailleurs. Pour un client, le choix du modèle et celui de l’opérateur commencent à se dissocier. Et pour un laboratoire européen, c’est une autre manière de rester dans la chaîne de valeur.
L’écart de performance est difficile à ignorer
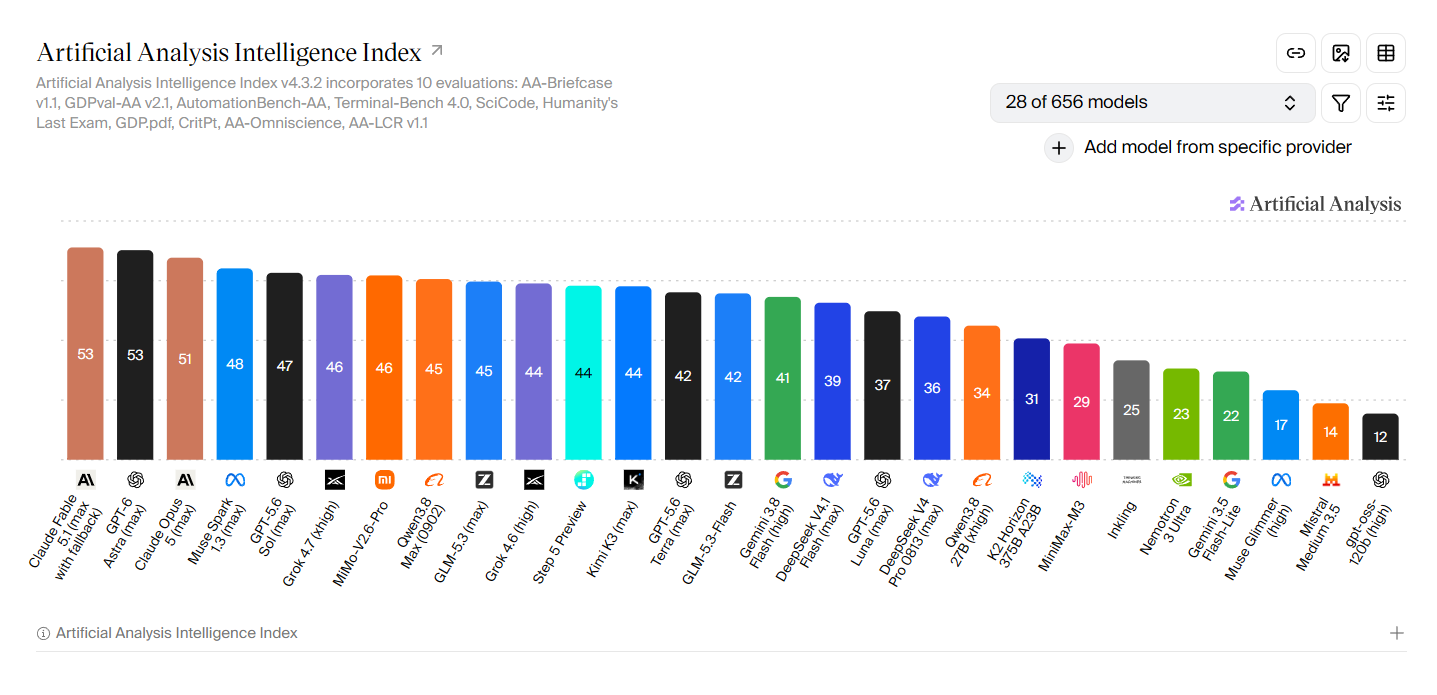
J’ai consulté l’Intelligence Index d’Artificial Analysis le 22 septembre 2026. Dans la version v4.3.2, GLM‑5.3 et Kimi K3 devancent nettement Mistral Medium 3.5. Le modèle ouvert Qwen3.8 2.4T A95B est lui aussi devant. Il faut nommer les variantes précisément, plutôt que comparer des marques.
| Modèle et réglage | Indice, arrondi affiché |
|---|---|
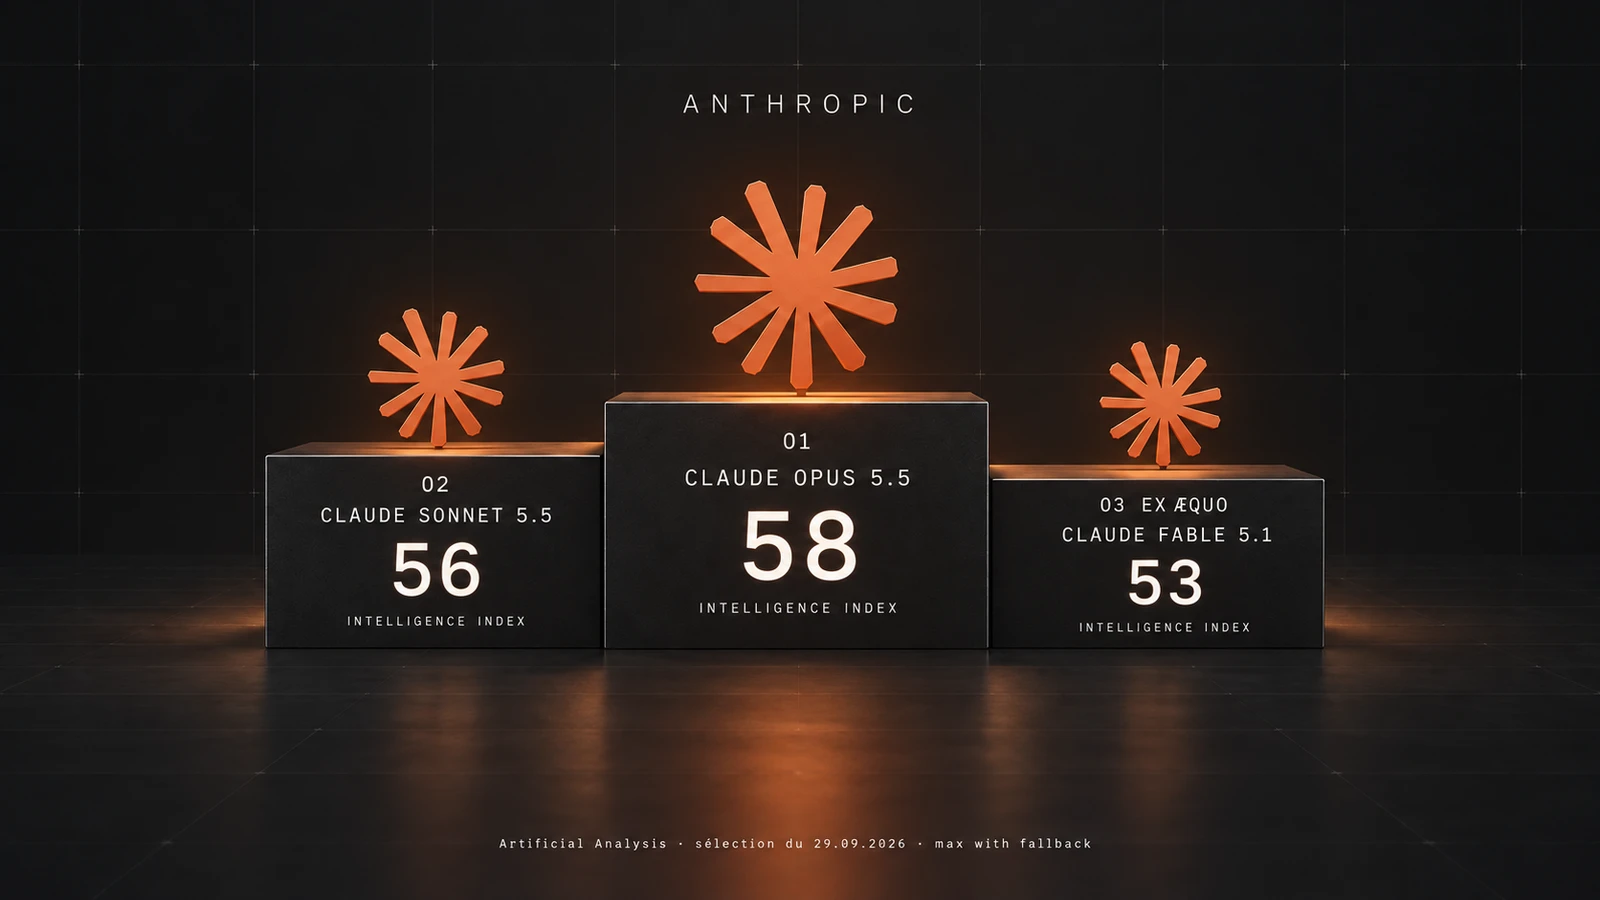
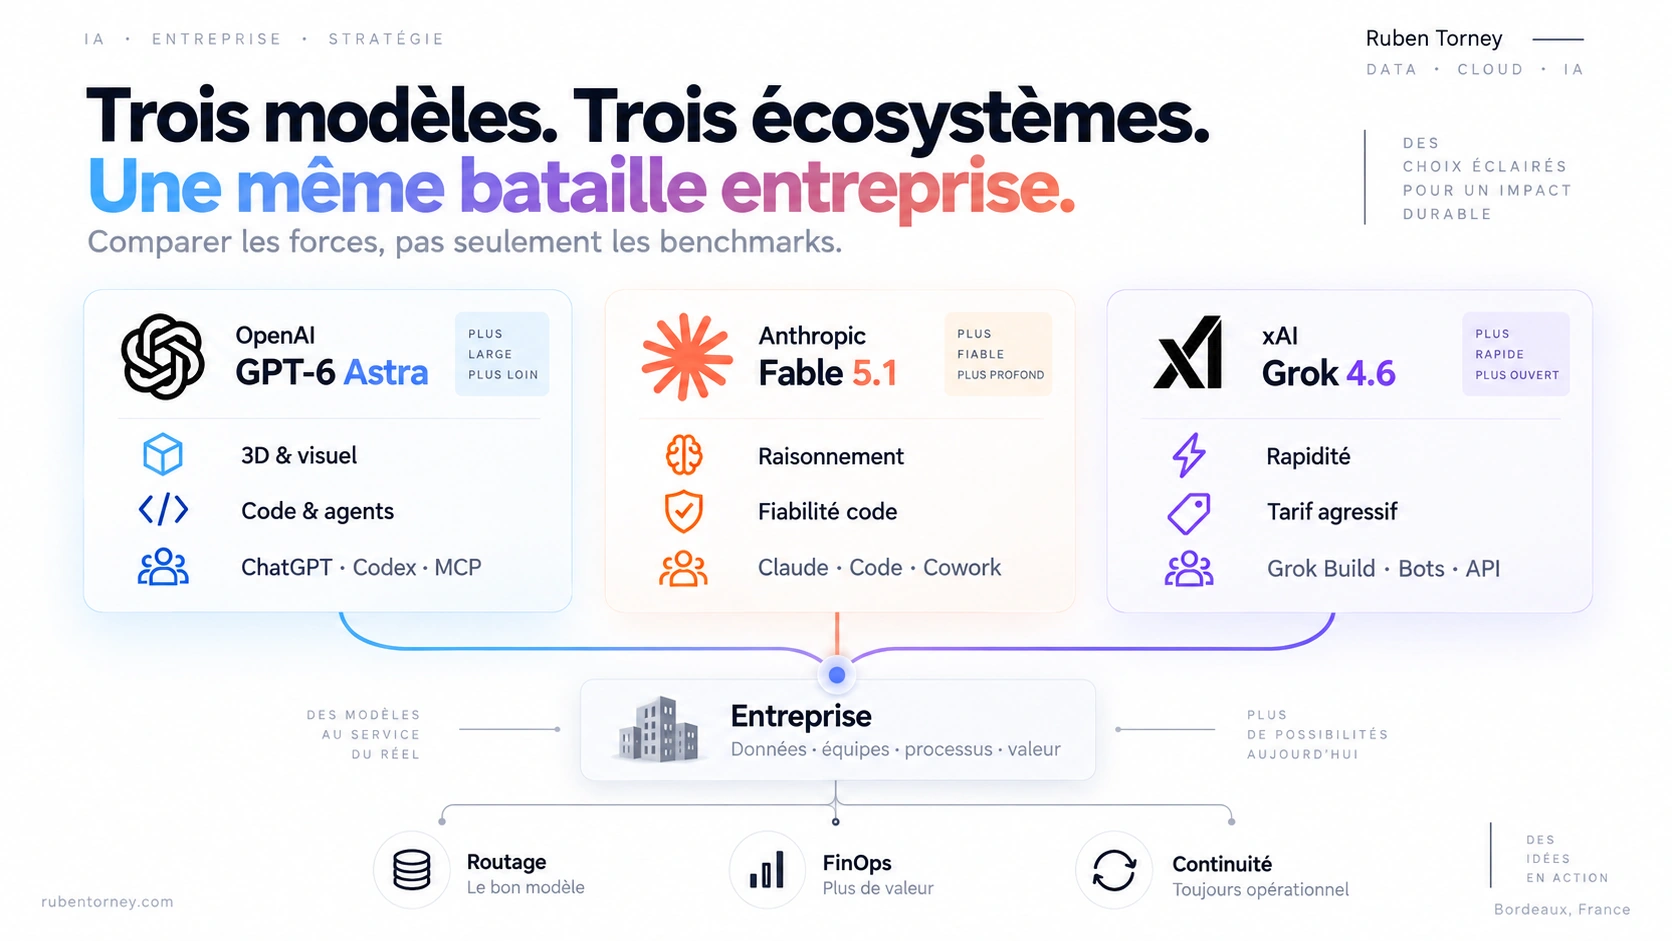
| Claude Fable 5.1 — max with fallback | 53 |
| GPT‑6 Astra — max | 53 |
| Grok 4.7 — xhigh | 46 |
| GLM‑5.3 — max | 45 |
| Kimi K3 — max | 44 |
| Qwen3.8 2.4T A95B | 40 |
| Mistral Medium 3.5 | 14 |
Ces points ne sont ni des pourcentages d’intelligence ni une mesure universelle de qualité. L’indice agrège dix évaluations ; réglages de raisonnement et recours à un modèle de repli comptent. Ce n’est pas non plus un test de GLM servi par Mistral. Méthodologie de l’indice.
Mon interprétation est néanmoins claire. Pour une entreprise qui cherche un agent capable de traiter des tâches difficiles, la promesse « européen » ne suffit pas à effacer un écart d’utilité. Et quand cette alternative existe en poids ouverts, la question devient légitime. Faut-il tout réentraîner, ou investir une partie de cet argent dans l’exploitation, l’intégration et la qualité de service ?
Des poids disponibles ne signifient pas pour autant un projet intégralement open source, ni un modèle facile à exécuter sur un ordinateur personnel. Les licences, le matériel et les conditions d’usage restent à examiner modèle par modèle. Je parle ici de modèles chinois à poids ouverts, pas d’une catégorie uniformément libre ou sans contraintes.
Sur le ring, le talent ne paie pas les GPU
L’image qui me vient est celle d’un boxeur montant sur le ring avec une main attachée dans le dos. Ce n’est pas une façon de dire que Mistral est mauvais. C’est une façon de rappeler que la compétition ne se joue pas uniquement sur le talent des chercheurs. Elle se joue aussi sur l’accès au capital, au calcul, aux données, aux équipes d’exploitation et à l’électricité.
Dans son entretien du 4 septembre avec Stratechery, Greg Brockman explique qu’Astra correspond au premier entraînement d’OpenAI réalisé sur plus de 100 000 GPU. C’est une déclaration du dirigeant, pas un audit indépendant du coût d’entraînement. Mais elle donne une idée de l’échelle industrielle du combat.
Le sujet énergétique est tout aussi matériel. L’AIE projette environ 950 TWh de consommation électrique des centres de données en 2030, contre 485 TWh en 2025. Cela concerne tous les centres de données, pas uniquement l’entraînement des LLM. Acheter des accélérateurs ne suffit pas ; il faut pouvoir les alimenter et les exploiter.
Je me garderais pourtant de transformer cette contrainte en fatalité française. Les coûts varient selon les sites et les contrats. Mistral annonce lui-même une ambition allant jusqu’à 1 GW de capacité en 2030 dans son programme d’infrastructure européenne. Une capacité annoncée n’est pas une capacité déjà disponible, mais ce n’est pas le discours d’une entreprise qui aurait renoncé à construire.
Dire « Mistral ne rattrapera jamais les leaders » me paraît donc trop définitif. Dire « suivre chaque surenchère d’OpenAI, d’Anthropic et de Grok est une stratégie coûteuse et risquée » me semble bien plus défendable. Le classement ne permet pas d’isoler la part du financement, des choix scientifiques ou de la réglementation dans cet écart.
L’AI Act complique le jeu, mais ne crée pas une interdiction de réussir
Les obligations européennes ne sont pas seulement un sujet futur. Pour les nouveaux modèles d’IA à usage général, elles s’appliquent depuis le 2 août 2025, avec une transition distincte pour les modèles antérieurs. La Commission européenne mentionne notamment une politique de respect du droit d’auteur et un résumé du contenu d’entraînement. Les modèles ouverts ne sont pas dispensés de ces deux obligations.
Le point souvent oublié est que les fournisseurs établis hors de l’UE qui placent leurs modèles sur le marché européen sont également concernés. Importer des poids chinois n’efface donc pas les questions de conformité. Et l’AI Act ne fixe pas un plafond de performance au-delà duquel un modèle deviendrait illégal. Questions-réponses de la Commission sur les modèles GPAI.
Ma critique porte sur l’équilibre économique. Si une entreprise doit financer à la fois une course au calcul et une gouvernance exigeante, la pression est réelle. Mais je ne peux pas déduire d’un bon score qu’un laboratoire chinois a violé le droit d’auteur, ni affirmer que Mistral devrait nécessairement enfreindre la loi pour atteindre le même niveau. La nationalité et les benchmarks ne prouvent rien de tel.
La vraie question est celle du retour sur investissement. Est-il raisonnable de multiplier les dépenses pour reproduire une capacité déjà disponible, alors que les clients ont aussi besoin de contrats, de support, d’intégration et de maîtrise opérationnelle ? À mes yeux, le respect des créateurs doit rester une exigence. Il ne devrait pas devenir la variable d’ajustement de la compétition.
Récupérer de la valeur, sans confondre trois souverainetés
Je vois dans cette offre un mouvement pragmatique. Mistral peut vendre une capacité d’exécution et une relation de confiance, même quand il n’a pas entraîné le modèle utilisé. Le B2B me paraît être le débouché le plus naturel, mais un développeur indépendant peut aussi y trouver une alternative intéressante à une API américaine ou à un service de routage comme OpenRouter.
| Ce que je veux maîtriser | Ce que je dois vérifier |
|---|---|
| Les données et leur traitement | Région effective, conservation, journaux, sous-traitants, accès support et transferts. |
| L’exploitation | Disponibilité, quotas, latence, supervision, support et engagements contractuels. |
| Le modèle lui-même | Licence, version des poids, possibilité de changer d’hébergeur, dépendance aux prochaines versions. |
Un opérateur français ne rend pas automatiquement français le lieu d’inférence. La documentation régionale Mistral précise que l’endpoint global ne garantit pas une région. L’option régionale est distincte, facturée 10 % de plus, avec disponibilité des modèles à vérifier. Elle ne régionalise pas toutes les métadonnées du service. « Hébergé en France » serait donc une promesse trop précise pour les éléments vérifiés ici.
De même, le RGPD ne devient pas automatique dès que le fournisseur est européen. La CNIL rappelle les vérifications de sécurité et d’encadrement du cloud. Dans un projet client, je regarderais les contrats et les flux réels avant d’envoyer des documents sensibles. Cela rejoint ma réflexion sur la stratégie IA, la gouvernance et la souveraineté en entreprise.
Il y a malgré tout une valeur concrète à pouvoir choisir son opérateur sans renoncer au modèle qui fonctionne le mieux. Une souveraineté partielle et précisément décrite peut être utile. Une souveraineté totale affichée sans expliquer ses dépendances l’est beaucoup moins.
Une alternative qui devra gagner aussi sur la facture
Au 22 septembre, la fiche GLM‑5.3 affiche, par million de tokens, 1,40 $ en entrée, 0,14 $ en entrée en cache et 4,40 $ en sortie. Ce sont des tarifs API standard ; il ne faut pas les confondre avec les quotas d’un abonnement Vibe.
Prenons un exemple purement arithmétique, hors taxes éventuelles et autres frais. Un million de tokens d’entrée non cachés et 100 000 tokens de sortie coûtent 1,84 $ au tarif standard. Avec la majoration régionale de 10 %, cela devient 2,024 $, sous réserve de disponibilité du modèle sur l’endpoint choisi. Ce calcul ne représente pas le prix garanti d’une tâche agentique.
Un agent peut relire le contexte, recommencer et générer beaucoup de raisonnement. C’est pourquoi je surveille davantage le coût d’une tâche réussie que le tarif d’un token. J’en ai parlé dans mon retour sur le coût imprévisible de Copilot au quotidien. Je m’attends à davantage de pression sur les budgets réels, mais cela ne signifie pas que tous les prix unitaires monteront. Efficacité, concurrence et promotions peuvent agir dans l’autre sens.
Pour moi, l’intérêt de cette offre est de combiner un opérateur français avec des résultats fiables, des coûts prévisibles et une plus grande liberté dans le choix des modèles.
Et les garde-fous sur GLM ? La réponse reste partielle
La fiche Mistral dit que GLM‑5.3 est servi without Mistral modifications
. Cela renseigne sur le modèle, pas sur l’ensemble du service. Le DPA Mistral prévoit de la modération automatisée et de la surveillance des abus sur les API, avec une exception mentionnée pour cette dernière lorsque le zero data retention est activé. Il faut lire ces clauses dans le contexte de son offre et de son contrat.
Mistral propose aussi une API de modération. Son existence ne prouve pas qu’elle soit systématiquement branchée sur chaque requête GLM. La politique d’usage interdit notamment de compromettre la sécurité de tiers et de contourner les protections. Modèle ouvert ne veut donc pas dire service sans règles.
Pour un pentest autorisé, je veux savoir ce que le service accepte réellement. Les sources consultées ne détaillent pas suffisamment le filtrage propre à GLM‑5.3 pour conclure qu’il est identique à celui des modèles Mistral, ou absent. Je n’ai pas testé cet endpoint en cybersécurité. Je ne présente donc pas une supposée moindre censure comme une capacité mesurée.
Mes questions seraient concrètes. Quels filtres sont appliqués avant et après l’inférence ? Qu’est-ce qui change entre Vibe et l’API ? Comment sont traités les faux positifs sur des audits autorisés ? Quelles traces sont conservées, et pendant combien de temps ? Voilà un sujet sur lequel une documentation explicite aurait une vraie valeur commerciale.
Et si Mistral préparait déjà la course à l’efficience ?
Le débat a pris un autre relief avec le départ de Jacob Coxon, passé par OpenAI et Anthropic. En septembre, Dario Amodei a publié We Must Pace the Frontier. Il appelle à ralentir la progression des capacités pour laisser davantage de temps aux protections et aux évaluations indépendantes, sans arrêter la recherche. Sam Altman et Elon Musk ont soutenu cet appel. Cela ne constitue pas, à lui seul, une pause mondiale effectivement appliquée.
Leur justification publique est la sécurité, pas l’idée que les modèles seraient devenus assez bons. Mais je me pose aussi la question des intérêts économiques. Quand les acteurs les mieux installés demandent de ralentir la course, cela peut leur donner du temps pour amortir leurs investissements, consolider leurs produits et préserver leur avance. J’y vois une possibilité d’opportunisme, pas une intention démontrée. Une inquiétude sincère sur les risques et un intérêt commercial peuvent coexister.
Mon intuition est que, pour une grande partie des besoins courants en entreprise, la question va de moins en moins être « quel est le plus gros modèle ? » et de plus en plus « lequel réalise correctement cette tâche, au bon coût et dans le bon délai ? ». Ce n’est pas l’annonce d’un plateau universel. Les tâches difficiles, longues ou critiques peuvent encore bénéficier de progrès importants. Mais quelques points supplémentaires dans un classement ne garantissent pas un retour sur investissement pour chaque client.
La prochaine bataille pourrait donc porter davantage sur l’efficience. Il s’agirait de mobiliser moins de calcul pour un résultat utile, d’envoyer moins de contexte inutile, de limiter les reprises et de mieux répartir les tâches entre modèles. Il faut distinguer ces leviers. Diminuer le nombre de tokens facturés, accélérer leur génération et réduire l’énergie consommée ne sont pas trois mesures interchangeables. Ce que je veux comparer, c’est le coût complet d’une tâche réussie, à qualité équivalente.
Dans cette lecture, Mistral a peut-être compris assez tôt qu’il pouvait construire une activité durable sans gagner chaque manche de la course aux capacités. Développer ses modèles, distribuer des modèles à poids ouverts et devenir une référence de l’inférence en Europe peuvent se renforcer mutuellement. Un client achète aussi de la disponibilité, une intégration, du support et un cadre d’exploitation. C’est une ambition industrielle qui mérite d’être soulignée.
Je parle ici d’une stratégie de rentabilité, pas d’une rentabilité déjà établie. Les éléments vérifiés pour cet article ne permettent ni d’affirmer que Mistral réalise un bénéfice net, ni qu’OpenAI perd de l’argent sur chaque requête. Chiffre d’affaires, marge d’inférence, dépenses de recherche et résultat global sont des choses différentes. Mon hypothèse est que Mistral peut chercher une croissance plus rationnelle en monétisant l’usage des modèles, y compris ceux des autres, plutôt qu’en faisant dépendre toute sa valeur de la première place.
Mistral construit aussi une boîte à outils pour les entreprises
Le classement des grands modèles ne raconte qu’une partie de l’histoire. Le catalogue Mistral réunit des modèles généralistes et des outils pour les documents, l’audio, le code, la recherche sémantique et la modération. À mes yeux, cette diversité donne une autre lecture de sa stratégie. Mistral construit progressivement une boîte à outils dont les entreprises peuvent assembler les composants selon leurs besoins.
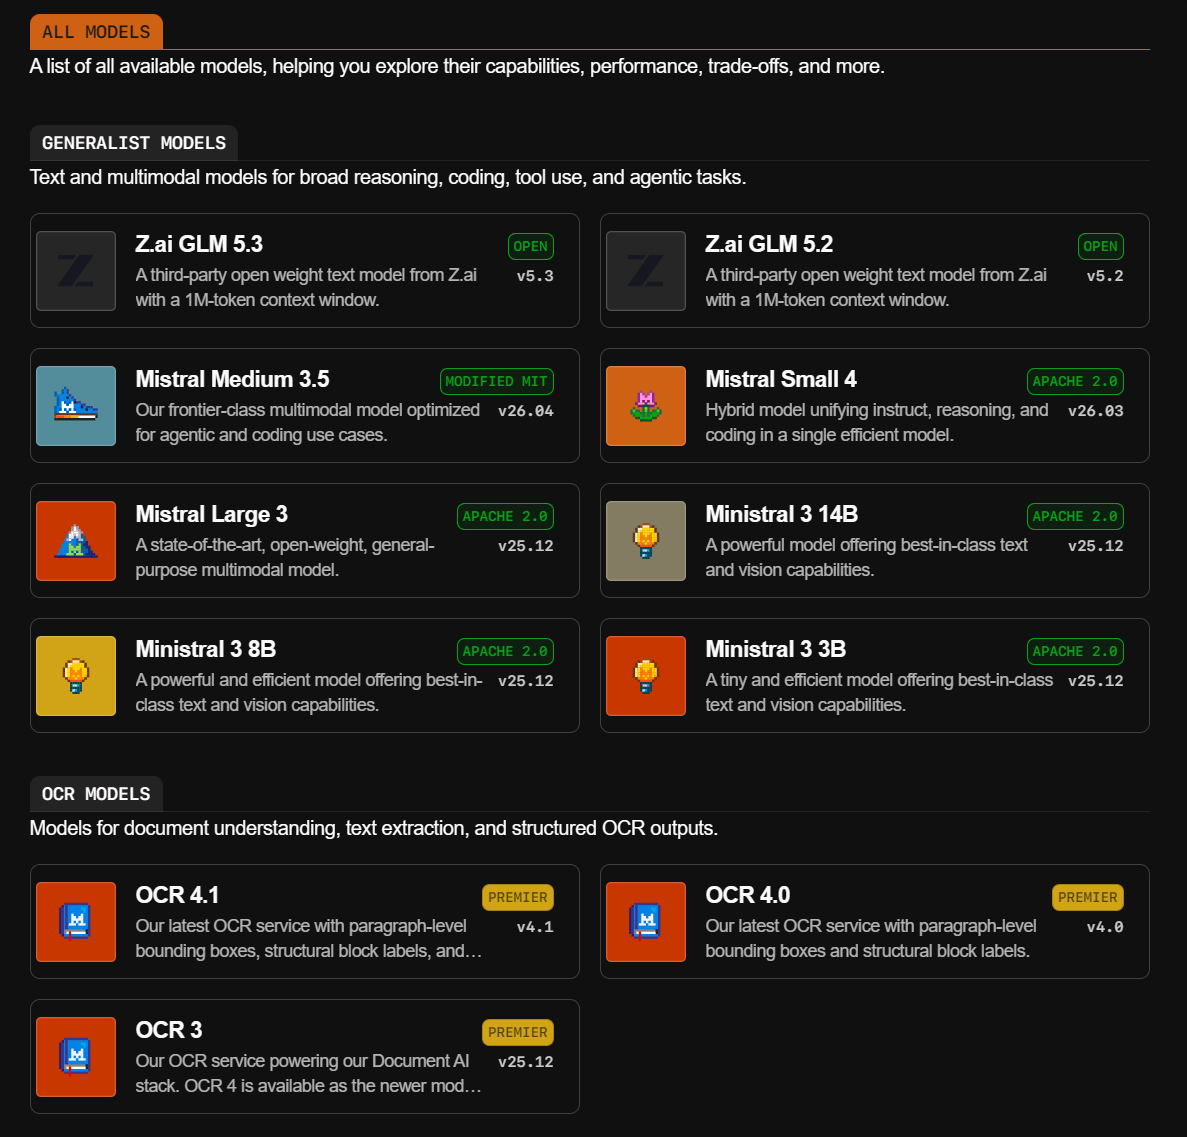
La famille Ministral 3 propose des formats 3B, 8B et 14B. Le 3B vise notamment le déploiement local et les équipements contraints. C’est une approche intéressante pour disposer de capacités de texte et de vision sans mobiliser une infrastructure comparable à celle des très grands modèles. Les plus petits formats peuvent rendre l’hébergement accessible sur des machines relativement modestes, selon la quantification, la mémoire disponible, la longueur du contexte et le nombre d’utilisateurs. Cela ne signifie pas que tout le catalogue tourne sur n’importe quel ordinateur.
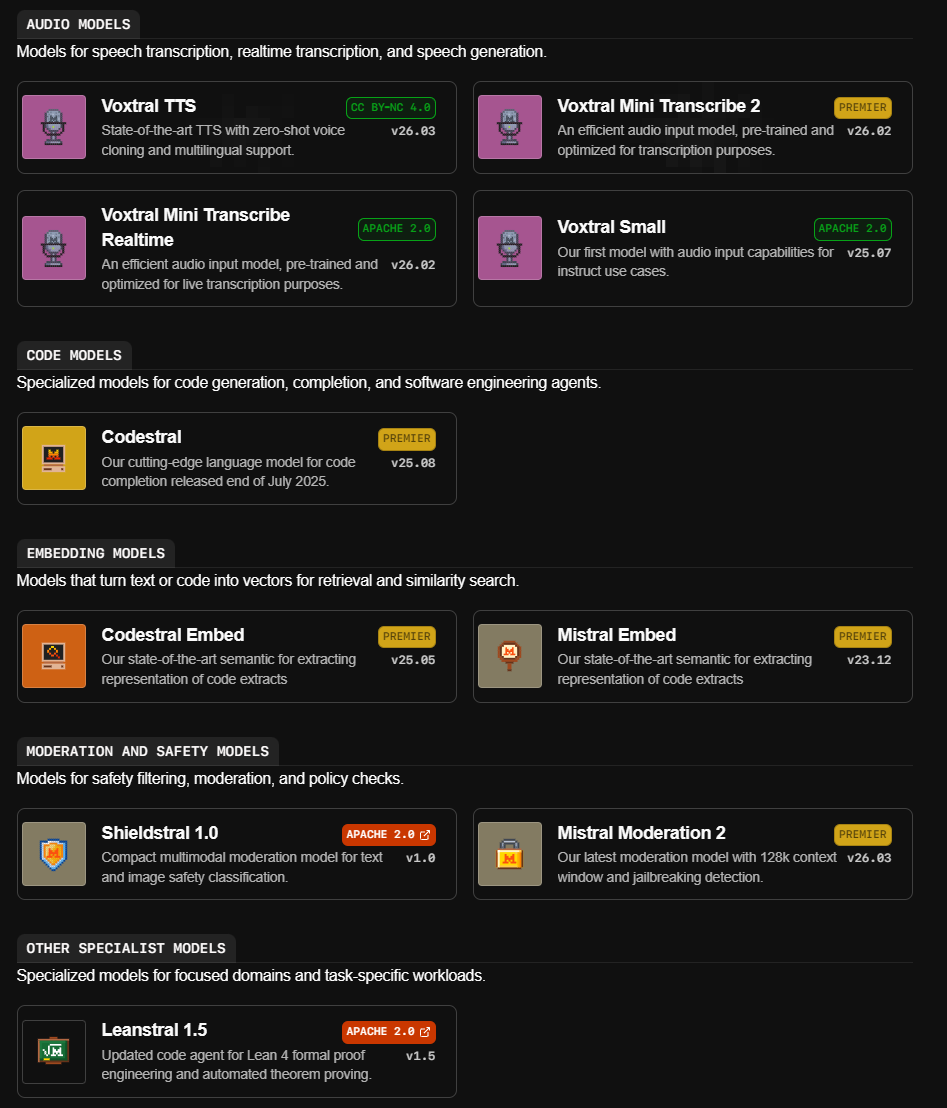
Concrètement, l’OCR sert à extraire le contenu de documents, Voxtral couvre des usages audio, Codestral la complétion de code et les embeddings la recherche par similarité. Shieldstral ajoute un modèle compact de modération du texte et des images sous Apache 2.0. Une entreprise peut ainsi envisager une chaîne adaptée à son métier, plutôt que solliciter systématiquement le modèle le plus puissant pour chaque étape. C’est aussi cela, viser l’efficience.
Il faut toutefois choisir les briques une par une. Les captures mêlent modèles ouverts et offres Premier. Les poids de Voxtral TTS sont publiés sous licence CC BY-NC, ce qui impose de vérifier les droits nécessaires à un usage commercial. Un catalogue étendu ne constitue donc pas une suite intégralement libre, locale et interchangeable.
Pour la souveraineté, l’intérêt est très concret. Héberger les composants adaptés dans un environnement maîtrisé peut aider à limiter les transferts de données, à choisir les versions et à appliquer ses propres règles d’accès et de conservation. Cela peut faciliter la mise en œuvre de certaines exigences réglementaires, à condition de documenter et de sécuriser l’ensemble du système. Ni une licence ouverte ni un filtre de modération ne valent conformité automatique au RGPD ou à l’AI Act.
C’est ce positionnement que je trouve stratégique. Mistral peut devenir à la fois concepteur, distributeur et opérateur d’un ensemble d’outils qui se complète au fil du temps. L’entreprise cliente gagne alors des options pour adapter ses coûts, son hébergement et sa gouvernance. La valeur ne réside plus seulement dans un score maximal, mais dans la capacité à construire une IA utile et maîtrisable au quotidien.
Un aveu de retard peut aussi devenir une bonne stratégie
Oui, j’y vois une forme d’aveu. Quand on propose à ses clients un modèle tiers qui surpasse ses propres modèles dans ce classement, on reconnaît que la réponse au besoin ne viendra pas toujours de son laboratoire. Mais je préfère cette lucidité à une promesse de souveraineté qui demanderait au client de sacrifier trop d’efficacité.
Ce n’est pas une preuve d’abandon de la recherche. C’est, selon moi, une manière de financer une autre place dans le marché. Mistral peut continuer à développer ses modèles tout en vendant l’exploitation de ceux des autres. Le risque serait de devenir dépendant de licences et de sorties qu’il ne contrôle pas. L’opportunité est de conserver ici une partie de la relation client, de l’expertise et des revenus.
Personnellement, cette possibilité m’intéresse. Je la mettrais à l’épreuve sur mes tâches, avec un budget et un périmètre de données définis. Je ne demande pas à Mistral de gagner chaque benchmark. Je lui demande une offre utile, transparente sur ses limites, et suffisamment solide pour être choisie autrement que par patriotisme.
Sources
Sources consultées le 22 septembre 2026. Analyse documentaire et opinion personnelle ; aucun benchmark de l’API Mistral réalisé pour cet article.
- GLM‑5.3 dans Vibe Code pour les offres Pro, Team et Enterprise
- fiche du modèle chez Mistral
- 11 août, avec GLM‑5.2
- Intelligence Index d’Artificial Analysis
- Méthodologie de l’indice
- entretien du 4 septembre avec Stratechery
- AIE projette environ 950 TWh de consommation électrique des centres de données en 2030
- Commission européenne
- Questions-réponses de la Commission sur les modèles GPAI
- documentation régionale Mistral
- CNIL rappelle les vérifications de sécurité et d’encadrement du cloud
- DPA Mistral
- API de modération
- politique d’usage
- Jacob Coxon, passé par OpenAI et Anthropic
- We Must Pace the Frontier
- Sam Altman et Elon Musk ont soutenu cet appel
- catalogue Mistral
- Ministral 3 propose des formats 3B, 8B et 14B
- 3B vise notamment le déploiement local et les équipements contraints
- Shieldstral ajoute un modèle compact de modération du texte et des images sous Apache 2.0
- Voxtral TTS sont publiés sous licence CC BY-NC