Un calendrier qui sert le récit de l’IPO
Opus 5.5 est arrivé le 22 septembre, suivi de Sonnet 5.5 le 28 septembre. Deux lancements rapprochés qui replacent Anthropic dans la conversation. Est-ce un simple hasard du calendrier ? Je n’y crois pas beaucoup, mais il s’agit de ma lecture stratégique et non de la preuve d’un calendrier décidé pour la Bourse.
Le projet d’IPO est bien réel, puisqu’Anthropic a annoncé le 1er juin le dépôt confidentiel d’un projet de prospectus (formulaire S-1) auprès de la SEC, le régulateur boursier américain, et que la presse a rapporté fin septembre le contenu de ce prospectus. Une opération préparée ne signifie cependant ni une cotation réalisée ni une date garantie. Selon les informations reprises le 29 septembre par El País, qui s’appuie sur Reuters et le Financial Times, l’introduction pourrait d’ailleurs être repoussée après les élections américaines de mi-mandat de novembre, et les besoins de financement restent considérables.
Dans ce contexte, arriver avec des modèles convaincants permet de défendre une idée simple auprès du marché. Anthropic peut encore progresser, attirer les développeurs et transformer cette avance en usages payants. Cela peut soutenir la demande et la valorisation espérées. Cela ne garantit ni le prix d’introduction ni le montant effectivement levé.
Une démonstration spectaculaire se comprend immédiatement
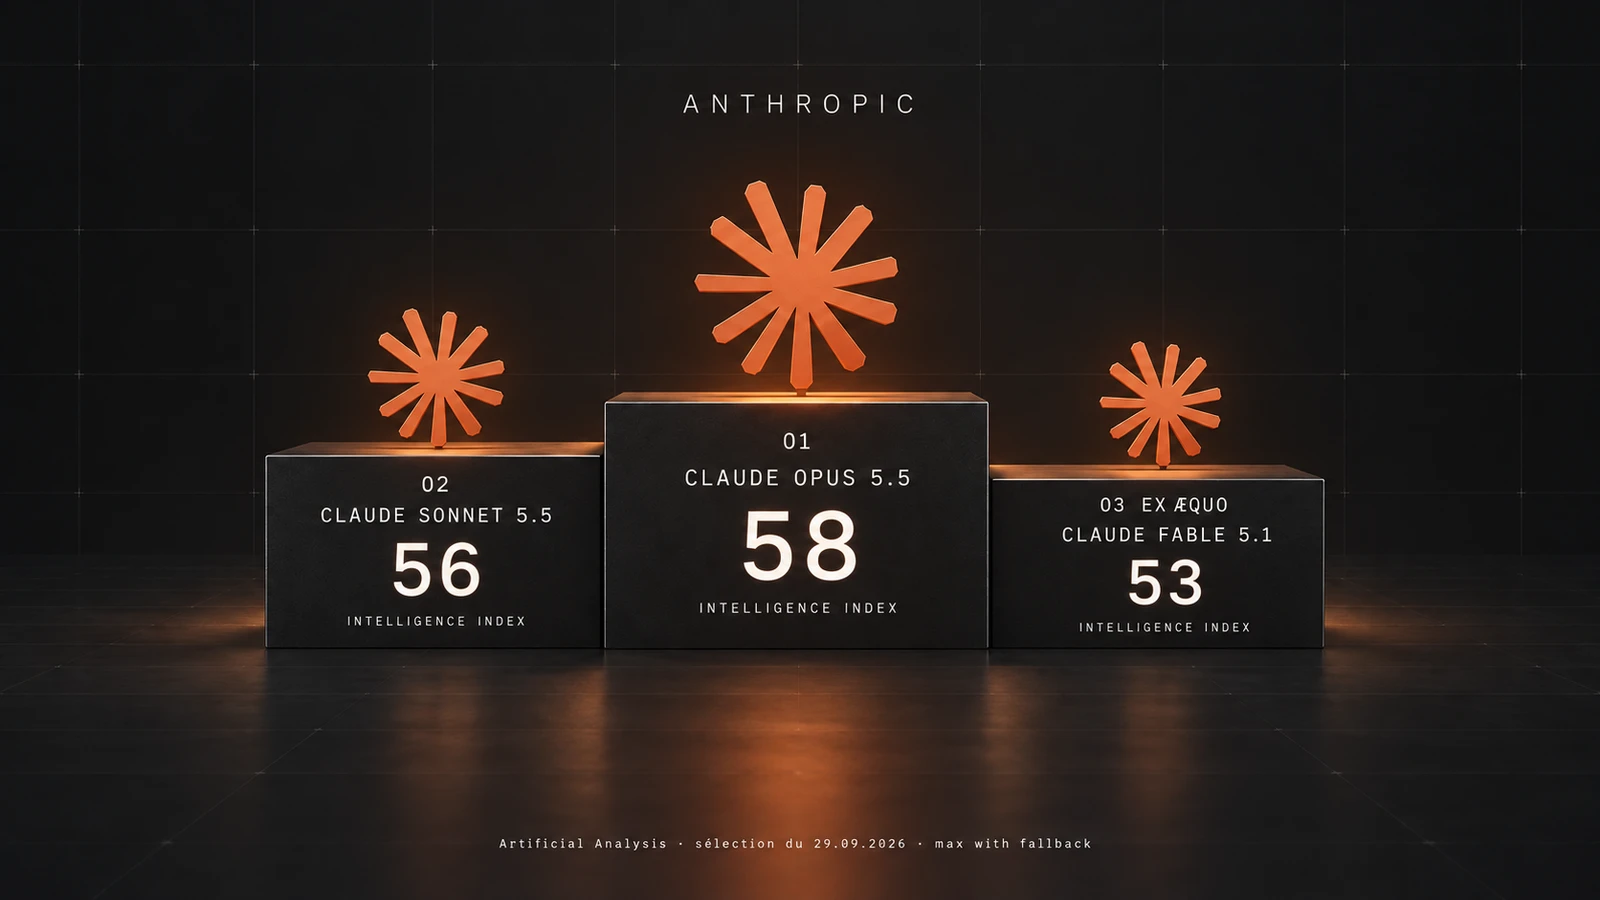
Anthropic prend désormais seul la tête de l’Artificial Analysis Intelligence Index, qu’il partageait jusqu’ici avec OpenAI puisque Fable 5.1 et GPT-6 Astra étaient à égalité à 53 points. Sur le classement complet, Opus 5.5 arrive premier avec 58 points et Sonnet 5.5 est le deuxième modèle avec 56 points. Les deux modèles sont évalués dans la configuration étiquetée « max with fallback » par Artificial Analysis. C’est un signal très lisible pour le marché, au-delà des résultats publiés par Anthropic lui-même.
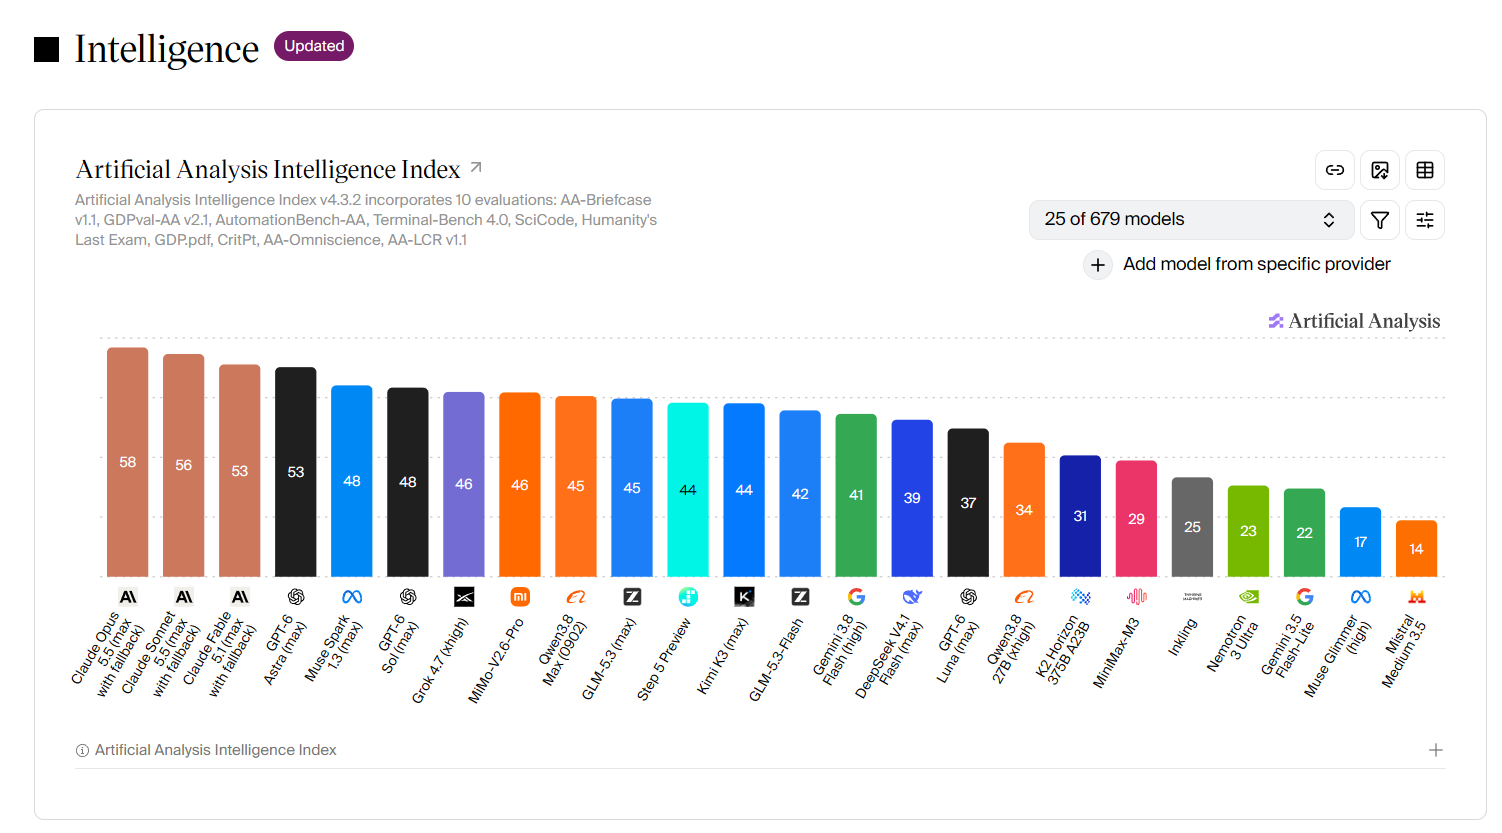
Ce score synthétise plusieurs évaluations. Il ne signifie pas que chaque tâche sera mieux réussie, et les réglages d’effort comptent. Le classement complet comporte aussi plusieurs configurations d’un même modèle. Mais le message de cette comparaison reste fort. Anthropic place ses deux nouveaux modèles devant tous les modèles évalués, exactement au moment où il doit convaincre de sa capacité à rester en tête.
Ce qui me frappe aussi, ce sont les réalisations que je vois passer sur X et LinkedIn, du développement logiciel aux scènes 3D, en passant par le motion design (animation graphique) et des animations avec effets et synchronisation sonore. Une séquence fluide rend le progrès immédiatement visible. Le public comprend le résultat avant de comprendre le modèle.
À mes yeux, quelques secondes de démonstration peuvent davantage marquer les esprits qu’un dossier de recherche de plusieurs centaines de pages. La recherche reste indispensable pour évaluer les limites. Mais pour capter l’attention, le visuel est redoutablement efficace.
Il faut aussi nommer correctement ce que l’on regarde. Un agent peut écrire du code, piloter des outils et assembler un rendu. Cela ne fait pas automatiquement de Claude un générateur natif de vidéos et de sons. Un résultat partagé ne révèle pas toujours les itérations, les outils ni les retouches qui l’ont précédé.
Mon test, deux animations produites par Claude 5.5
Pour voir ce que valent ces démonstrations de l’intérieur, j’ai confié deux animations à des sous-agents de Claude Code (des instances du modèle qui travaillent en autonomie sur une tâche), lancés en parallèle. Opus 5.5 devait présenter ses propres caractéristiques et son score dans l’Intelligence Index, en motion design avec effets visuels et sonores. Sonnet 5.5 devait faire voler des briques 3D qui s’emboîtent pour écrire « Ruben T. ». Chaque animation a suivi le même parcours, avec une première version, une critique indépendante confiée au même modèle, puis une passe de correction.
L’animation d’Opus 5.5 dure 30 secondes. Elle reprend les chiffres publiés par Anthropic face à Opus 5 (coût, prix, vitesse, bancs d’essai et audit comportemental), puis construit le top 10 de l’Intelligence Index du 29 septembre, où Opus 5.5 prend la première place avec 58 points.
Celle de Sonnet 5.5 dure 26 secondes. Quatre-vingts briques générées par le code volent, tournent et s’emboîtent au rythme de clics synthétisés pour écrire « Ruben T. ». En cours de route, j’ai demandé de reprendre les couleurs du Lo Mahavéli, le drapeau populaire de La Réunion (fond bleu, triangle rouge du volcan et rayons jaunes), et cette retouche est incluse dans les chiffres ci-dessous. Le motif se lit à travers les lettres plutôt que comme un drapeau complet.
Il s’agit dans les deux cas de code HTML et JavaScript exécuté en direct dans votre navigateur, avec Three.js pour la 3D et des sons synthétisés à la volée par l’API Web Audio. Aucune vidéo ni aucun fichier audio n’a été généré, ce qui illustre bien la distinction faite plus haut entre un agent qui code un rendu et un générateur natif de vidéo.
| Claude Opus 5.5 | Claude Sonnet 5.5 | |
|---|---|---|
| Sujet | Motion design sur ses caractéristiques et son score | Briques 3D qui écrivent « Ruben T. » |
| Effort de raisonnement demandé | xhigh | xhigh |
| Temps de réalisation | 2 h 16 | 1 h 58 |
| Tokens traités | 81,8 millions | 67,7 millions |
| dont relectures de cache | 78,9 millions (96 %) | 65,9 millions (97 %) |
| Tokens générés en sortie | 640 000 | 515 000 |
| Appels à l’API | 245 | 266 |
| Coût équivalent API | 39,82 $ | 21,63 $ |
Ces chiffres sont mesurés dans les transcripts des agents. Le coût applique le tarif public de l’API Anthropic au 29 septembre 2026, soit 4 $ et 20 $ par million de tokens en entrée et en sortie pour Opus 5.5, 2 $ et 10 $ pour Sonnet 5.5, 0,20 $ pour les relectures de cache et 1,25 fois le prix d’entrée pour les écritures en cache. J’utilise un abonnement Max 20x, ces montants n’ont donc pas été facturés tels quels et donnent l’ordre de grandeur du même travail réalisé via l’API.
En contrepartie, il ne fallait pas être pressé. J’ai volontairement poussé le curseur au maximum, avec l’effort de raisonnement xhigh (le temps de réflexion accordé au modèle à chaque étape), une critique indépendante puis une passe de correction pour chaque animation, afin de mesurer le coût et le résultat les plus élevés possibles. Un raisonnement moins poussé aurait peut-être suffi à respecter mes consignes avec une qualité suffisante, pour un temps et un coût bien inférieurs. Une bonne partie de ces deux heures a d’ailleurs servi aux vérifications automatiques, avec des captures d’écran image par image et un rendu 3D logiciel, sans carte graphique.
Deux enseignements ressortent de ces chiffres. Sonnet 5.5 coûte environ 45 % de moins qu’Opus 5.5 pour un volume de tokens du même ordre, puisque son tarif est deux fois plus bas. Surtout, plus de 96 % des tokens sont des relectures de cache, c’est-à-dire le contexte que l’agent relit à chaque étape de son travail. Facturé 0,20 $ le million, ce poste pèse 40 % de la facture d’Opus 5.5 et 61 % de celle de Sonnet 5.5, ce qui explique pourquoi Anthropic met en avant la baisse de 60 % du prix des relectures de cache sur Opus 5.5.
La critique indépendante a aussi joué son rôle. Sur l’animation d’Opus 5.5, le relecteur a bloqué la première version, dont le classement animé passait brièvement par un ordre faux, et la passe de correction l’a remplacé par une construction fidèle aux scores. Celui de Sonnet 5.5 n’a demandé qu’une correction importante, sur la fluidité de l’horloge d’animation. Je vous laisse juger du résultat en lançant les deux animations ci-dessus.
Sur mes longues tâches, l’efficience change vraiment la donne
J’ai beaucoup testé Opus 5.5 sur des travaux agentiques (confiés à un agent qui enchaîne lui-même les étapes) de plusieurs heures, et sur des travaux étalés sur plusieurs jours. Ce qui me marque, c’est la qualité obtenue, une précision très convaincante et la capacité à poursuivre un travail complexe avec cohérence.
La consommation me paraît aussi relativement raisonnable face à Fable 5.1 ou à l’Opus précédent. Je parle ici de mon expérience quotidienne, sans protocole comparatif normalisé ni pourcentage d’économie mesuré. Mais le gain d’efficience ressenti est suffisamment net pour changer ma manière d’utiliser le modèle.
Cette impression rejoint la direction annoncée par Anthropic pour Opus 5.5, qui estime, d’après ses propres tests, qu’il coûte 40 % de moins qu’Opus 5 sur des charges typiques avec les réglages par défaut. De son côté, Artificial Analysis mesure en effort maximal un coût par tâche équivalent à celui d’Opus 5, malgré 1,6 fois plus de tokens (unités de texte facturées) générés. Ces chiffres restent ceux de leurs essais, pas une économie garantie sur mon abonnement, car les prix API, les tokens consommés et les limites d’un forfait ne mesurent pas la même chose.
Comme dans mon retour sur le coût de GitHub Copilot au quotidien, la bonne question reste le coût d’un travail terminé et vérifié. Une meilleure réponse ne suffit pas si elle demande ensuite trop de corrections.
Réclamer jusqu’à 250 dollars de crédits cloud
L’annonce de ClaudeDevs du 23 septembre prévoit un crédit ponctuel de 100 dollars pour Pro et de 250 dollars pour Max, pour les abonnés existants éligibles. L’annonce ne distingue pas Max 5x et Max 20x. Le montant proposé dans votre compte fait foi.
Dans Claude Code, saisissez la commande suivante, qui s’écrit au singulier.
/claim-creditVous pouvez aussi ouvrir le lien de réclamation officiel donné dans l’annonce, qui demande d’être connecté à votre compte Claude. La consigne officielle demande de réclamer le crédit avant le 7 octobre à 23 h 59, heure du Pacifique, soit le 8 octobre à 8 h 59 à Paris. Le visuel de l’annonce précise qu’il expire le 4 novembre à 23 h 59, heure du Pacifique (le 5 novembre à 8 h 59 à Paris), et que des conditions s’appliquent.
Sur le site Claude, vous pouvez également ouvrir Paramètres → Utilisation, puis cliquer sur Obtenir le crédit dans le bandeau. Voici ce que l’offre affiche sur mon compte Max 20x.
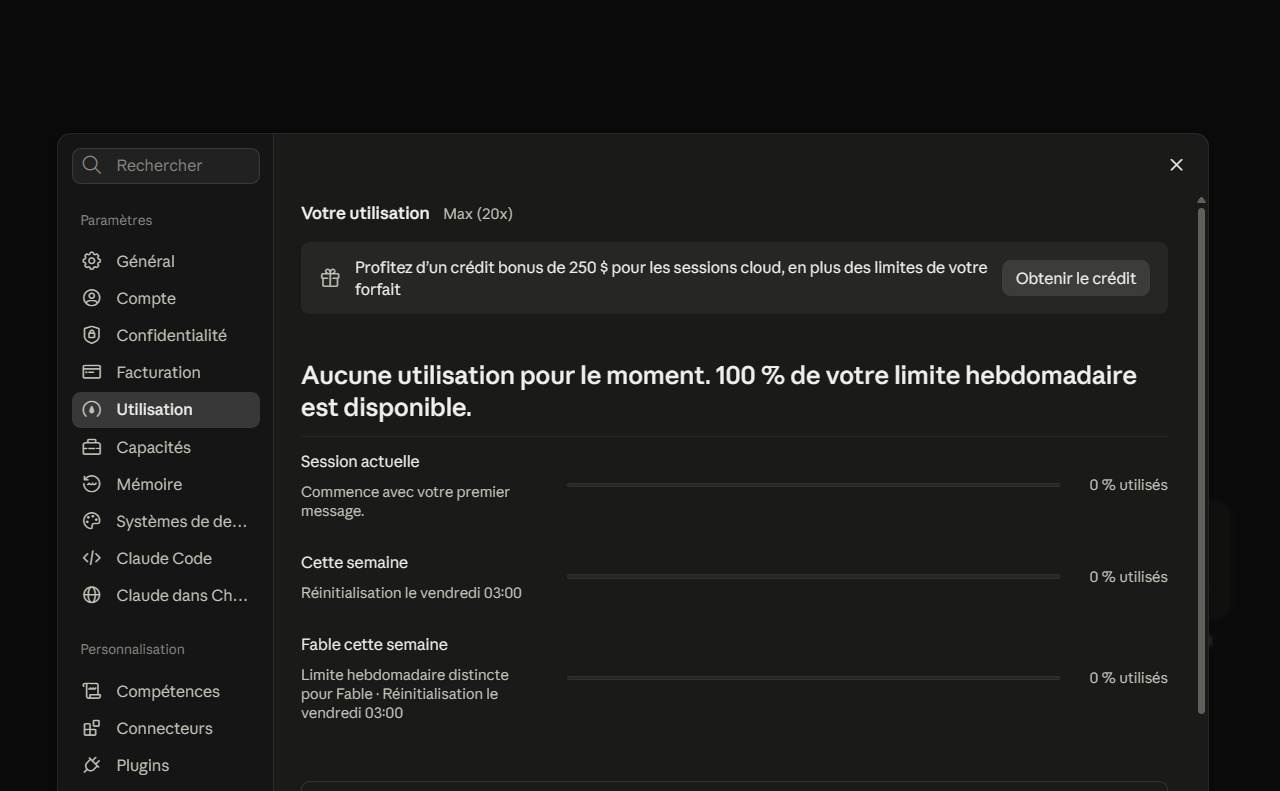
Ce crédit est réservé aux sessions cloud, avec un seul crédit par compte, et ce n’est ni du crédit API général ni un bonus pour les conversations locales. Comme le précise la suite de l’annonce, il est distinct des limites d’usage et s’applique automatiquement dès que vous démarrez une session cloud. Une fois consommé ou expiré, les limites habituelles du forfait reprennent. Cette offre ne doit pas être confondue avec la remise à zéro des quotas proposée par ailleurs.
Pour démarrer par le parcours web, connectez GitHub et choisissez votre dépôt. La documentation des sessions cloud explique comment le travail peut continuer lorsque votre ordinateur est fermé. C’est un format intéressant pour éprouver un agent sur un vrai chantier plutôt que sur une seule réponse impressionnante.
Convaincre les développeurs avant de convaincre le marché
Je vois là une séquence cohérente, qui consiste à montrer des progrès, à rendre leur bénéfice visible, puis à donner aux abonnés les moyens de les essayer. Les crédits peuvent favoriser l’adoption, les retours terrain et de nouvelles démonstrations. Tout cela nourrit un récit favorable avant une IPO, même sans preuve d’une intention boursière derrière chaque annonce.
Mon analyse du positionnement de Mistral insistait déjà sur la valeur de l’efficience et de la distribution. Anthropic peut jouer ces leviers tout en défendant ses performances de pointe. C’est précisément cette combinaison qui me semble forte aujourd’hui.
Une belle démonstration attire l’attention, alors qu’un outil que l’on conserve plusieurs mois crée une activité. Pour moi, le véritable enjeu sera là, dans la conversion de cette avance visible en revenus durables, avec des coûts maîtrisés. L’enthousiasme autour de Claude 5.5 aide à raconter cette ambition, sans remplacer sa réalisation.
Sources et méthode
Références consultées le 29 septembre 2026. Les annonces du fournisseur, les évaluations indépendantes et mon retour personnel sont distingués dans le texte.
- Anthropic annonce son dépôt confidentiel auprès de la SEC, le 1er juin 2026. Cette annonce confirme le projet d’introduction en Bourse, sans fixer son prix ni sa date.
- Présentation officielle d’Opus 5.5, le 22 septembre 2026, et présentation de Sonnet 5.5, le 28 septembre. Ces pages documentent les sorties et les performances annoncées par Anthropic.
- Classement Artificial Analysis Intelligence Index et analyse indépendante d’Opus 5.5 du 22 septembre. Ils étayent les scores et la comparaison du coût par tâche. Le classement évolue après la publication.
- Annonce de ClaudeDevs du 23 septembre, périmètre des crédits cloud et instructions de réclamation. Ce fil officiel précise les montants, l’usage et les conditions de l’offre.
- Documentation des sessions cloud de Claude Code. Elle décrit leur fonctionnement et le parcours de connexion au dépôt.
- Article d’El País du 29 septembre 2026, qui reprend des informations de Reuters et du Financial Times sur le prospectus et le calendrier envisagé. Il s’agit d’informations de presse, et non d’une date de cotation confirmée.
Les captures illustrent le classement sélectionné et l’offre affichée sur mon compte. L’illustration du podium est une création éditoriale générée avec l’IA, pas un graphique officiel. Les deux animations ont été produites le 29 septembre 2026 par des sous-agents Claude Code, et leurs tokens, coûts et durées sont relevés dans les transcripts de ces agents. Mon appréciation de l’efficience repose sur mes usages, sans protocole comparatif contrôlé. Le lien entre les lancements et la stratégie boursière reste mon analyse, et les démonstrations évoquées sur les réseaux ne constituent pas un banc d’essai reproductible.