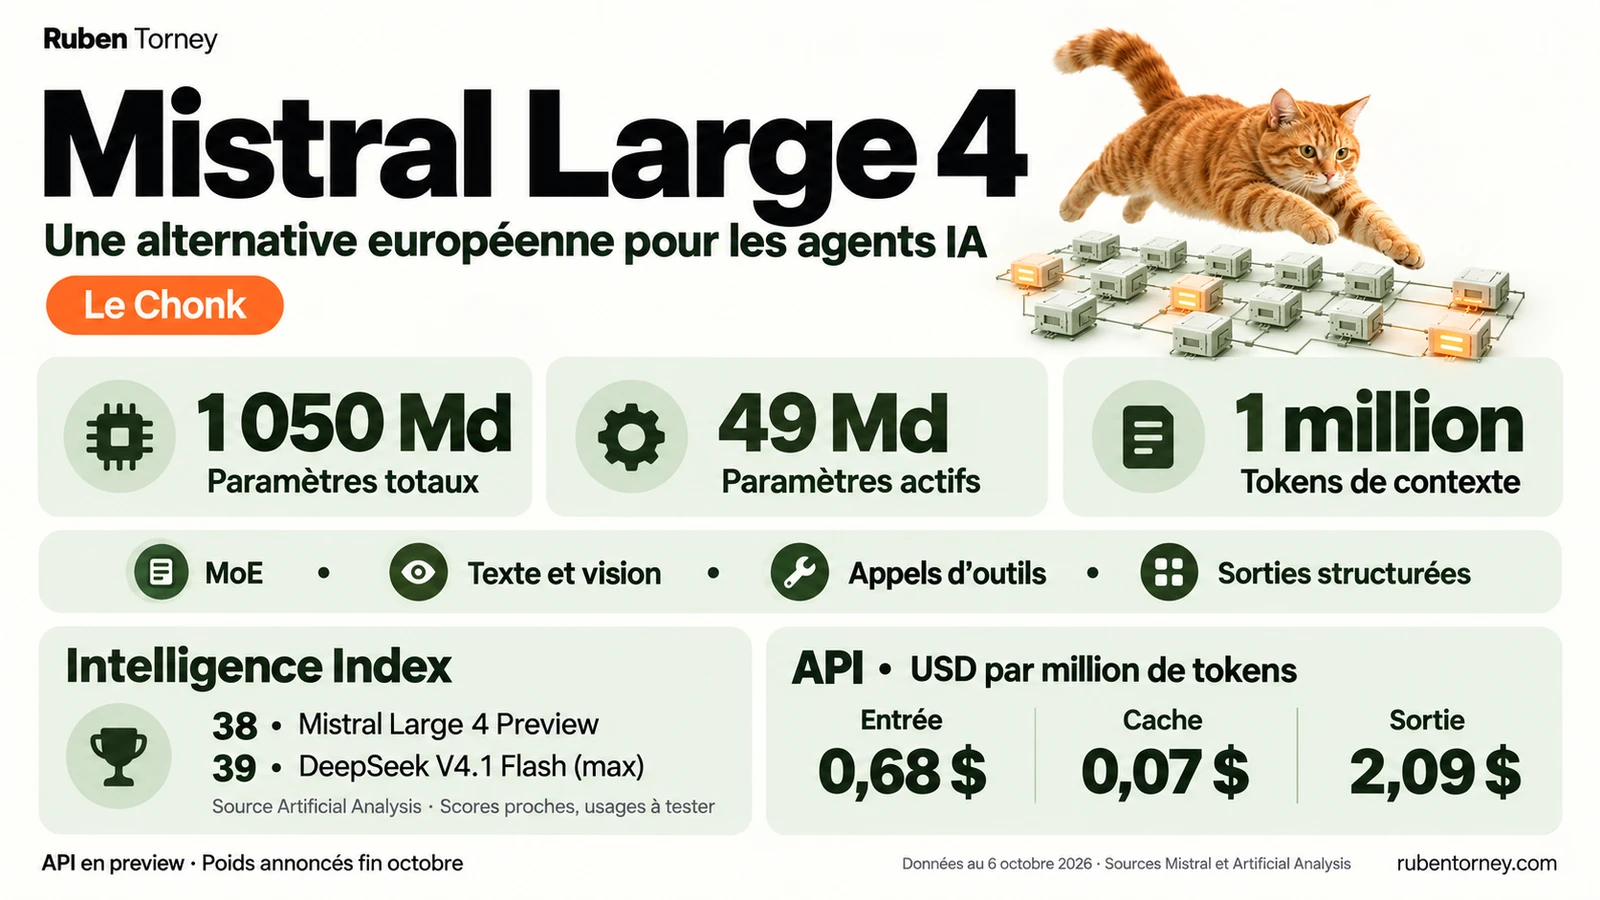
Il y a quelques jours, je provoquais un peu
J’écrivais « Mistral héberge GLM‑5.3, aveu de retard ou pari de souveraineté ? ». Le titre était volontairement provocateur. Quand je regardais Mistral Medium 3.5 à 14 dans l’indice d’intelligence et les modèles chinois à poids ouverts bien devant, franchement, l’écart sautait aux yeux.
Mais la conclusion de l’article était plus nuancée que le titre. Héberger d’autres modèles, proposer une infrastructure européenne, compléter une gamme d’outils spécialisés, c’était aussi une manière de capter de la valeur différemment. Mistral pouvait s’adapter sans transformer chaque annonce en concours de surenchère.
Et aujourd’hui, Le Chonk arrive. Pour moi, ça renforce cette lecture. Distribuer des modèles et continuer à en développer peuvent très bien aller ensemble. Mistral ne s’était pas forcément résigné à rester derrière.
Les caractéristiques de Large 4, sans mélanger les chiffres
La fiche technique de Mistral donne les éléments suivants pour la version v26.10.
| Caractéristique | Valeur annoncée |
|---|---|
| Architecture | MoE granulaire, multimodal |
| Paramètres totaux | 1 050 milliards |
| Paramètres actifs | 49 milliards |
| Encodeur visuel | 1,6 milliard de paramètres |
| Contexte | 1 million de tokens |
| Identifiant API | mistral-large-4 |
| Intégration | Appels de fonctions, sorties structurées, documents, conversations et batch |
| Disponibilité | Preview publique par API, poids annoncés fin octobre |
MoE signifie « mélange d’experts ». Au lieu de mobiliser tous les paramètres à chaque token, une partie du réseau est sélectionnée par un mécanisme de routage. Les tokens sont les unités manipulées par le modèle, et aussi l’unité habituelle de facturation. Le principe permet de dissocier la capacité totale du réseau de la quantité de calcul activée à chaque étape.
Attention, un expert n’est pas forcément un petit agent spécialisé en comptabilité ou en droit. Il s’agit d’un sous-réseau appris pendant l’entraînement. Et le rapport 49 sur 1 050, environ 4,7 %, ne signifie pas que le modèle ne coûte que 4,7 % du prix d’un modèle dense. L’attention, les échanges entre accélérateurs, la mémoire et le routage comptent aussi.
Un gros modèle reste un gros modèle à héberger
Les 49 milliards actifs ne transforment pas Large 4 en modèle de 49 milliards à charger en mémoire. Il faut pouvoir accéder à l’ensemble des poids, éventuellement répartis sur plusieurs machines. Pour donner un ordre de grandeur purement arithmétique, 1 050 milliards de valeurs à deux octets représentent environ 2,1 To. À quatre bits par valeur, on arrive encore à environ 525 Go, avant les surcoûts de quantification, les buffers et le cache de contexte.
Ces calculs ne constituent pas une configuration recommandée par Mistral. Ils montrent simplement pourquoi je ne rangerais pas Le Chonk parmi les modèles qu’on installe tranquillement sur une petite box. C’est un autre sujet que les alternatives d’IA locale sur workstation et RTX 3090.
La vision et le contexte doivent servir le travail réel
Un encodeur visuel transforme les images en représentations exploitables par le modèle. Pour mes usages, l’intérêt serait de lire un document mêlant texte et schémas, comprendre une capture d’écran ou retrouver un élément dans une interface. Comprendre une image ne signifie pas générer une image, encore moins produire une vidéo.
De même, une grande fenêtre de contexte donne de la place pour les documents, les échanges et les retours d’outils. Elle ne garantit pas que chaque détail sera retrouvé correctement, ni que remplir toute la fenêtre sera rapide et économique. Je préfère tester la récupération d’une information utile au milieu d’un dossier plutôt que m’arrêter au chiffre affiché.
Ce qui reste à documenter
Je ne vais pas inventer le nombre de couches, le nombre d’experts sélectionnés par token, le mécanisme d’attention ou une recette de cache distribué. Les références consultées ne suffisent pas à les établir. L’annonce renvoie à la publication des poids pour davantage de détails techniques. La licence exacte et les conditions d’auto-hébergement devront aussi être examinées à cette étape. Des poids annoncés ouverts ne sont pas encore des fichiers disponibles à télécharger.
Le bond dans les classements est réel, le verdict terrain reste à faire
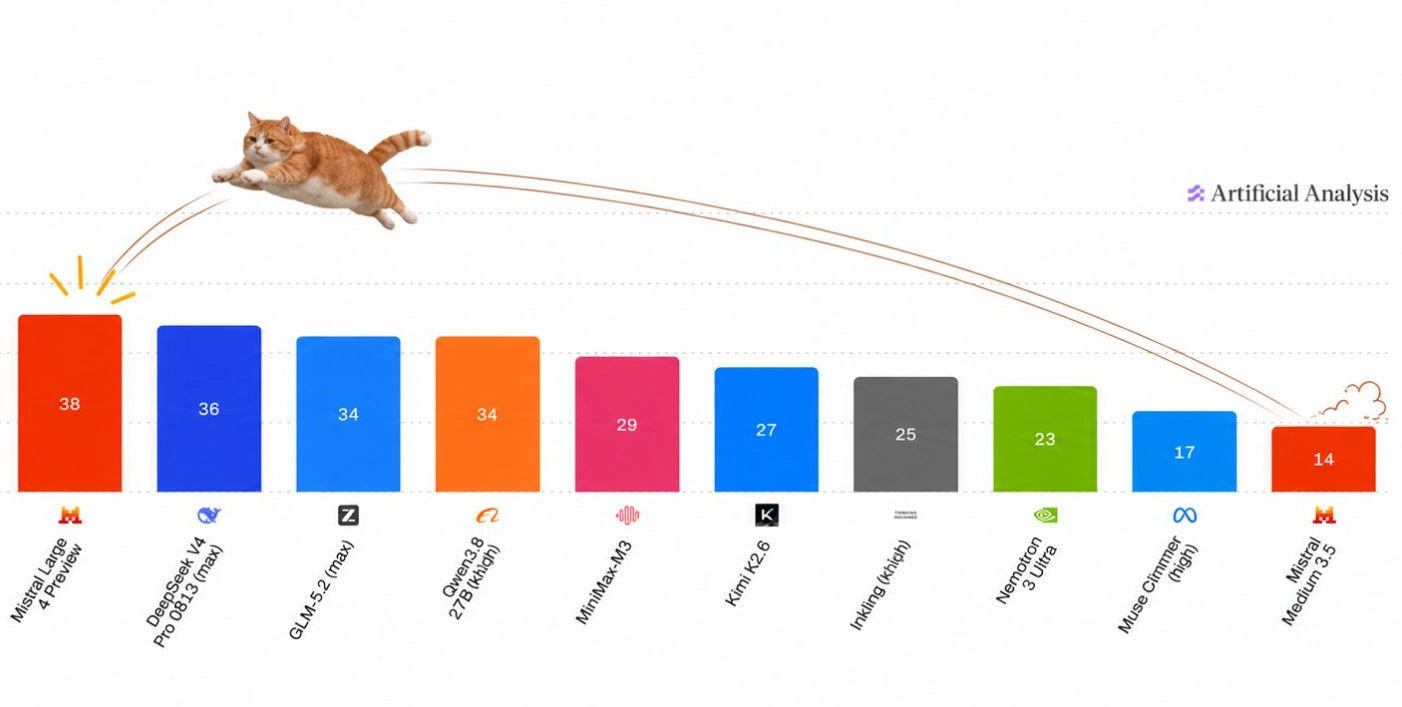
Sur cette sélection de benchmarks, c’est-à-dire de tests de performance, Large 4 Preview affiche 38, contre 14 pour Medium 3.5. On compare deux modèles, pas « toute l’intelligence de Mistral » avant et après. Et 38 n’est pas une mesure permettant de dire « presque trois fois plus intelligent ».
La fiche Artificial Analysis de DeepSeek V4.1 Flash en mode max indique 39. Un point d’écart, c’est prometteur. On est quasiment au même niveau sur cet indice, mais ça ne prouve pas une équivalence sur chaque tâche, chaque langue ou chaque chaîne d’outils.
Autre précision utile, le DeepSeek présent dans la capture est V4 Pro 0813 à 36. La comparaison avec V4.1 Flash vient de sa fiche séparée. Le graphique est une sélection de modèles, pas le classement complet de toutes les IA.
Dans son annonce, Mistral met en avant la cyberdéfense, la finance, l’industrie et la localisation d’éléments dans les images. Ce sont des indications intéressantes pour choisir mes tests, pas encore des résultats que j’ai reproduits moi-même.
Une stratégie plus rationnelle qu’elle n’en avait l’air
Mistral indique avoir entraîné le modèle depuis zéro sur 3 800 GPU NVIDIA Grace Blackwell dans ses centres de données européens. L’annonce décrit aussi un post-entraînement par renforcement, avec des environnements d’outils et des vérifications des résultats. Source Mistral.
Le post-entraînement sert notamment à façonner le comportement d’un modèle déjà entraîné. Pour un agent, produire une phrase correcte ne suffit pas. Il faut choisir un outil, interpréter son résultat, corriger une erreur et poursuivre sans perdre l’objectif. Récompenser des trajectoires qui aboutissent peut donc être aussi important que d’augmenter la taille du réseau.
Je pense que temporiser peut avoir du sens dans un écosystème où les méthodes et les outils progressent aussi vite. Mais je ne peux pas en déduire que Mistral aurait repris la recette d’un MoE chinois, ni chiffrer une économie d’entraînement. Ce serait raconter une histoire que les sources ne démontrent pas.
Le contexte européen bouge aussi. Aleph Alpha vient de présenter Kolibri. Les annonces se multiplient, et c’est une bonne nouvelle. Je ne vais pas leur attribuer un podium européen sur la base de tests différents. Ce qui m’intéresse, c’est d’avoir davantage d’options sérieuses.
Ce que ça peut changer pour une entreprise en France
Pour moi, l’intérêt dépasse la place dans un classement. Une alternative performante avec un opérateur européen, des possibilités de déploiement et une gamme d’outils autour, ça peut compter dans un choix d’architecture. C’était déjà le sujet de mon article sur GLM chez Mistral.
Mais choisir Mistral ne rend pas automatiquement une application conforme au RGPD ou à l’AI Act. Il faut regarder le traitement des données, les contrats, les accès, la conservation et les obligations liées à l’usage. Le cadre européen distingue les responsabilités selon les systèmes et leurs risques.
Dans mes workflows, le modèle ne doit pas non plus décider seul de ses permissions. Un agent qui consulte des documents n’a pas besoin, par défaut, du droit de les supprimer ou de les envoyer à l’extérieur. Les garde-fous du système et la validation humaine restent à construire, même avec un bon score de cybersécurité.
Je vais le mettre face à DeepSeek dans mes agents Hermes
Je suis très optimiste et je compte essayer Mistral à la place de DeepSeek V4.1 dans mes workflows, notamment avec mes agents Hermes. Je veux commencer sur un périmètre de test, puis élargir si les résultats suivent. À la publication de cet article, je n’ai pas encore de mesures personnelles sur Large 4.
Je reprendrai les mêmes tâches, les mêmes documents et les mêmes outils pour comparer ce qui m’intéresse vraiment.
| Ce que je vais tester | Ce que je vais mesurer |
|---|---|
| Recherche dans mes documents | Réponse juste, sources retrouvées, informations inventées |
| Enchaînement d’outils | Arguments corrects, erreurs, reprises et respect des permissions |
| Travail sur du code | Tests réussis et corrections nécessaires |
| Documents visuels | Extraction et compréhension des éléments utiles |
| Sessions longues | Temps total, perte de contexte et interventions humaines |
| Coût d’une tâche terminée | Tokens consommés, cache, nouvelles tentatives et facture |
Un modèle moins cher par token peut revenir plus cher s’il recommence trois fois. À l’inverse, un modèle un peu plus coûteux peut être rentable s’il termine correctement et m’évite une demi-heure de correction. Voilà le genre de comparaison que je veux publier.
La page tarifaire affiche au moment de la consultation 0,68 $ par million de tokens entrants, 0,07 $ en entrée mise en cache et 2,09 $ en sortie. Les conditions et le mode de service doivent être vérifiés au moment du test. Je consignerai le tarif effectivement appliqué, la version du modèle et les réglages, plutôt que de promettre aujourd’hui un coût mensuel théorique.
Je mettrai cet article à jour avec mes impressions, mes tests grandeur nature et une estimation des coûts. Ce que je veux savoir, c’est si Large 4 peut devenir une alternative cohérente et pérenne pour les entreprises en France. L’annonce donne envie. Maintenant, place aux usages réels. Et sur cette relance, franchement, bravo Mistral.
Sources et méthode
Article rédigé le 6 octobre 2026. Il distingue les annonces du fournisseur, une capture issue du thread d’annonce de Mistral AI sur X, mon analyse et un protocole de tests à venir. Aucun résultat Hermes personnel sur Large 4 n’est présenté comme acquis.
- Mistral, annonce de Large 4 du 6 octobre 2026. Disponibilité, entraînement, positionnement et calendrier des poids.
- Mistral, fiche Large 4 v26.10. Architecture, paramètres, vision, contexte et capacités API.
- Mistral, tarification. Prix affichés lors de la consultation, susceptibles d’évolution.
- Artificial Analysis, DeepSeek V4.1 Flash. Score de 39 pour la configuration max, consulté le 6 octobre.
- Mistral AI, thread d’annonce sur X. C’est dans ce thread que se trouve la capture du classement reproduite dans cet article.
- Artificial Analysis, modèles et Intelligence Index. Attribution du classement. Le graphique partagé dans le thread Mistral présente une sélection, pas tous les modèles.
- Aleph Alpha, présentation de Kolibri. Annonce du 5 octobre 2026.
- Commission européenne, cadre de l’AI Act. Responsabilités liées aux usages des systèmes d’IA.
Toutes les références ont été consultées le 6 octobre 2026. Illustration de couverture et visuel LinkedIn générés avec une IA sous ma direction. Les petits modules de la couverture évoquent le MoE, sans représenter le plan technique de Large 4. Le graphique original est reproduit séparément avec son attribution. Les ordres de grandeur mémoire sont mes calculs théoriques, pas des mesures d’inférence.