Ce qui change dans les forfaits Pro
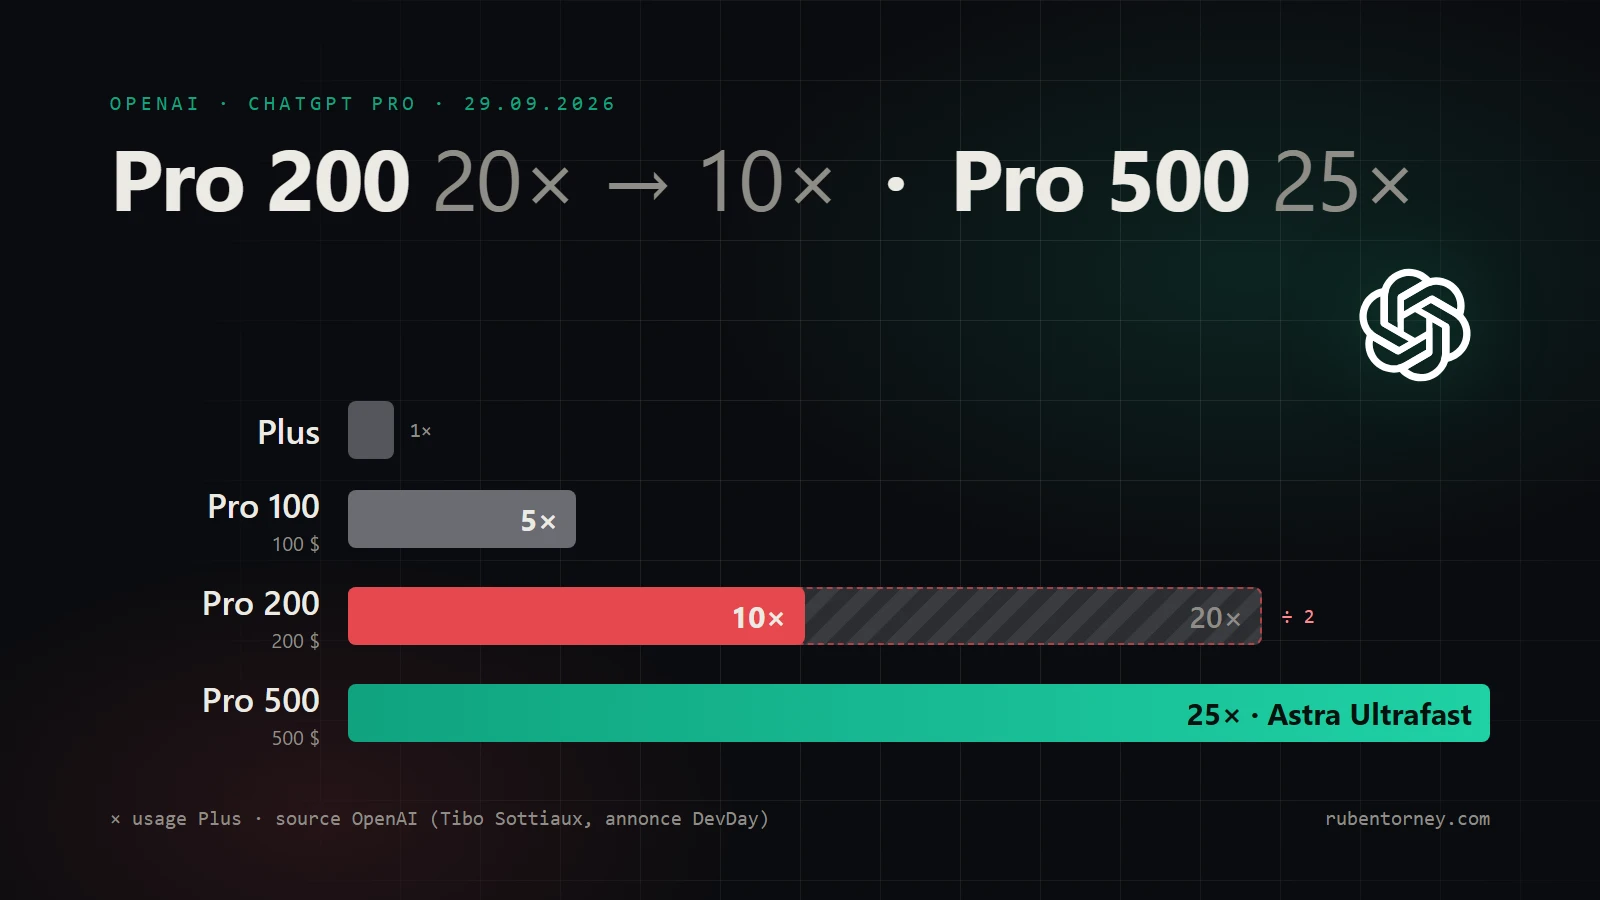
L’annonce est venue de Tibo Sottiaux, qui dirige les produits ChatGPT, Codex et API chez OpenAI, le jour du DevDay 2026. Les multiplicateurs sont exprimés par rapport à l’usage inclus dans le forfait Plus.
I’ll explain the new Pro 200 plan differently, before I start live tweeting from DevDay on things that are going out!
Today we are going to ship a number of things that increase what you can do across the Plus and Pro plans. A lot of compute is online for this increase. As we increase the floor, we are changing the relative difference between plans to be Plus = 1X, Pro 100 = 5X, Pro 200 = 10X, and we are reopening subscriptions for Pro 200 (we had paused it). If you have an existing plan you will keep the 20X multiplier for a bit and also receive a lot of additional credits because we know changes are hard even if it means that everyone will get more in the end.
Quelques heures plus tôt, dans un message plus long publié le même jour, il résumait l’effet pour les abonnés du Pro 200 d’une phrase sans détour. « If you do the math, it will net out at half the dollar in API spend compared to the old Pro $200 plan. » Autrement dit, le même prix donne désormais droit à environ la moitié de l’usage, exprimé en dollars d’API.
| Forfait | Prix mensuel | Usage inclus par rapport au Plus |
|---|---|---|
| Plus | forfait de référence | 1× |
| Pro 100 | 100 $ | 5× |
| Pro 200 | 200 $ | 10×, contre 20× avant le 29 septembre |
| Pro 500 (nouveau) | 500 $ | 25×, avec Astra Ultrafast |
Le nouveau Pro 500 donne 25 fois l’usage du Plus selon l’annonce du DevDay d’OpenAI, et il est le seul à ouvrir Astra Ultrafast, une version de GPT-6 Astra qui génère jusqu’à huit fois plus vite dans Codex. Les pages d’aide d’OpenAI précisent que les abonnés existants conservent leur ancien usage jusqu’au 29 octobre 2026. La presse, dont The Next Web, évoque en compensation un crédit d’environ 2 500 dollars valable jusqu’à la fin de l’année, et un plafond de messages GPT-6 Pro dans le chat qui passerait de 200 à 100 par semaine sur le Pro 200. Je n’ai pas trouvé ces deux derniers chiffres sur une page officielle.
OpenAI met aussi en avant plusieurs contreparties. La limite de cinq heures ne reviendra pas sur les forfaits Pro, seul le quota hebdomadaire s’applique. GPT-6 Sol et son successeur GPT-6.1 Sol coûtent 2 dollars par million de tokens (unités de texte facturées) en entrée et 10 dollars en sortie, soit deux fois moins que le tarif promotionnel de GPT-5.6. Les conversations avec les dots, les nouveaux agents personnels, ne comptent pas dans les limites, mais les tâches qu’ils lancent dans Codex ou ChatGPT Work, si. Et leur déploiement exclut pour l’instant l’Espace économique européen, la Suisse et le Royaume-Uni.
Un premier avertissement dès le gel du 10 septembre
Ce changement ne tombe pas du ciel. Le 9 septembre, Tibo Sottiaux prévenait déjà que la demande pour GPT-6 Astra était « really unprecedented ». Le lendemain, OpenAI suspendait les nouveaux abonnements au Pro 200, en expliquant que ces comptes étaient ceux qui mettaient le plus ses systèmes sous tension.
À ce moment-là, on pouvait encore y voir une mesure d’urgence face à un lancement réussi. Trois semaines plus tard, la réouverture montre que la contrainte n’était pas passagère. OpenAI rouvre la porte, mais avec un usage divisé par deux au même prix, et renvoie les gros consommateurs vers un forfait deux fois et demie plus cher.
Comme GitHub Copilot, la fin de l’open bar
J’ai déjà vu ce scénario. Au 1er juin, j’écrivais que GitHub Copilot marquait la fin de l’open bar, avec une enveloppe de crédits qui remplaçait un forfait ressenti comme illimité. Trois mois plus tard, mon retour sur le coût de Copilot au quotidien montrait qu’une simple analyse SQL pouvait consommer plus de 15 dollars de crédits.
OpenAI suit la même pente, avec une différence de taille. Le Pro 200 était devenu l’abonnement de référence des développeurs qui font tourner Codex plusieurs heures par jour, précisément parce qu’il revenait bien moins cher que l’API pour un usage intensif. C’est ce décalage entre le prix du forfait et le coût réel du calcul qui se réduit aujourd’hui.
Les réactions l’ont bien compris. Theo (@theo), développeur et créateur de contenu très suivi, a répondu « Ooooof. Mad respect for the transparency here but this hurts a lot ». Sur le forum des développeurs d’OpenAI, un fil intitulé « Usage Limit Change Rug Pulling » reproche à OpenAI de donner la moitié de l’avantage pour le même prix.
Ma lecture, le GPU devient la ressource rare
Je lis dans cette grille une volonté de freiner l’usage des capacités de calcul, et en particulier des GPU (processeurs graphiques qui font tourner les modèles). Quand un éditeur gèle un forfait, puis le rouvre avec deux fois moins d’usage, il nous dit que chaque heure d’agent a un coût qu’il ne veut plus absorber.
Le Pro 500 le confirme à sa manière. Il sépare les développeurs qui ont les moyens de payer 500 dollars par mois pour garder l’ancien confort de ceux qui ne les ont pas. Ce tri se fait petit à petit, forfait après forfait, jusqu’à rapprocher l’abonnement d’un paiement à l’usage.
On voit ce mouvement de plus en plus souvent, sous deux formes. Soit les quotas se réduisent, soit les utilisateurs ont le sentiment que les modèles deviennent moins bons au fil des semaines, ce que beaucoup appellent des modèles « nerfés » (bridés). Ce second point reste une perception répandue dans les communautés de développeurs, pas un fait que j’ai mesuré. Mais les deux mènent au même endroit, un problème sérieux de disponibilité des modèles et de capacité de calcul.
Je note aussi l’argument d’OpenAI, qui n’est pas absurde. La nouvelle génération de modèles coûte deux fois moins cher au token et se veut plus efficace, si bien qu’une enveloppe divisée par deux ne devrait pas, selon OpenAI, se traduire par une baisse de productivité. Tibo Sottiaux va même plus loin quand il écrit que « everyone will get more in the end ».
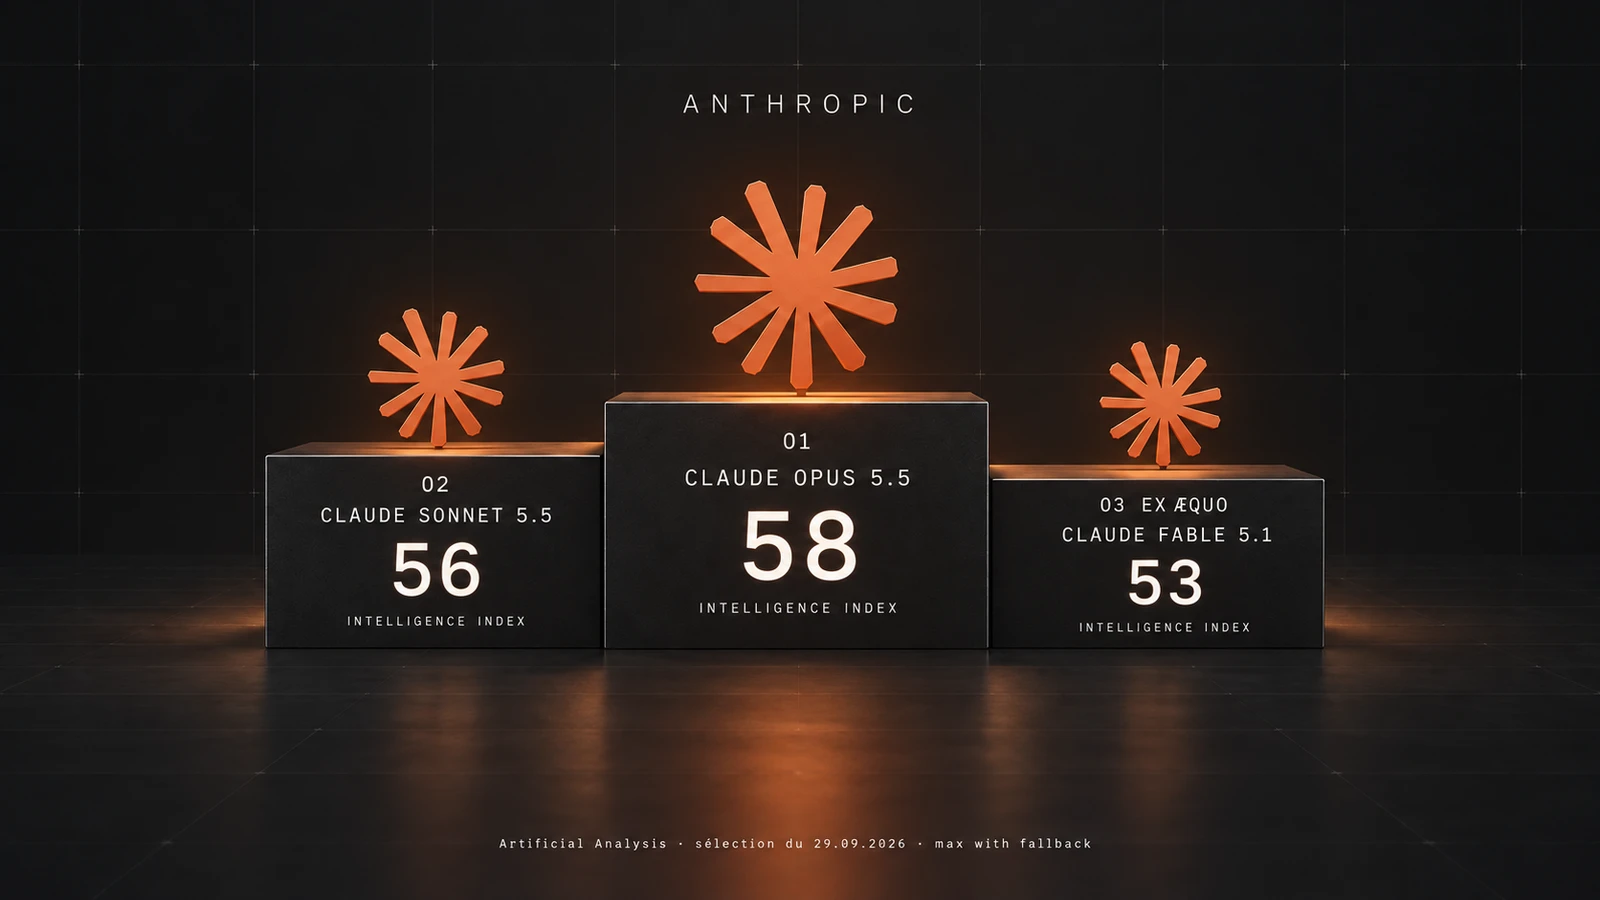
Cela reste à prouver. Un prix au token plus bas ne garantit pas un coût plus bas pour une tâche terminée, parce qu’un modèle peut consommer davantage de tokens pour arriver au même résultat. Artificial Analysis l’a d’ailleurs mesuré sur Claude Opus 5.5, moins cher au token qu’Opus 5 mais au coût par tâche équivalent en effort maximal, avec 1,6 fois plus de tokens générés. Et dans mon usage quotidien, une tâche est rarement réussie du premier coup. Il faut souvent relancer l’agent, corriger une sortie, lui redonner du contexte, et chaque itération puise dans le quota.
Avant de conclure que rien ne change, il faut donc vérifier sur son propre usage qu’il n’y a pas de régression. Je recommande de rejouer quelques tâches représentatives, de compter le nombre d’itérations nécessaires pour obtenir un résultat vérifié et de suivre la vitesse à laquelle le quota hebdomadaire se vide. Si l’efficacité des nouveaux modèles compense réellement la division par deux, tant mieux, mais rien ne le garantit, et c’est sur les factures et les quotas des prochaines semaines qu’on le verra, pas dans une annonce.
Anthropic et OpenAI, deux trajectoires opposées
Le contraste avec Anthropic est frappant. Comme je l’expliquais hier dans mon article sur Claude Opus 5.5 et l’IPO d’Anthropic, Anthropic prépare son introduction en Bourse avec des modèles en tête des classements, des limites de cinq heures relevées sur ses forfaits et jusqu’à 250 dollars de crédits offerts pour ses sessions cloud. Les quotas y restent, à mes yeux, assez généreux.
OpenAI, de son côté, n’est pas pressé. Sam Altman a déclaré à Fortune le 12 septembre que l’introduction en Bourse n’aurait sans doute pas lieu en 2026, en jugeant le moment « ill-advised » au regard des enjeux de sécurité. Sans échéance boursière immédiate, OpenAI peut assumer une politique tarifaire moins séduisante et protéger ses capacités de calcul, quitte à mécontenter une partie de ses utilisateurs les plus intensifs.
Se préparer au paiement à l’usage
Le risque est concret. Une entreprise qui a bâti ses processus sur un forfait très subventionné peut voir son coût doubler du jour au lendemain, ou se retrouver bloquée quand le quota tombe. Si on n’est pas prêt, on se retrouve coincé avec une activité qui ne tourne plus.
Pour donner un ordre de grandeur, mes deux animations produites hier par des agents Claude auraient coûté 39,82 dollars et 21,63 dollars au tarif de l’API, pour environ deux heures de travail chacune. Au paiement à l’usage, ce sont ces montants qu’il faut anticiper, tâche par tâche.
Voici ce que je recommande dès maintenant.
- Mesurer le coût d’une tâche terminée et vérifiée, pas seulement le prix d’un forfait.
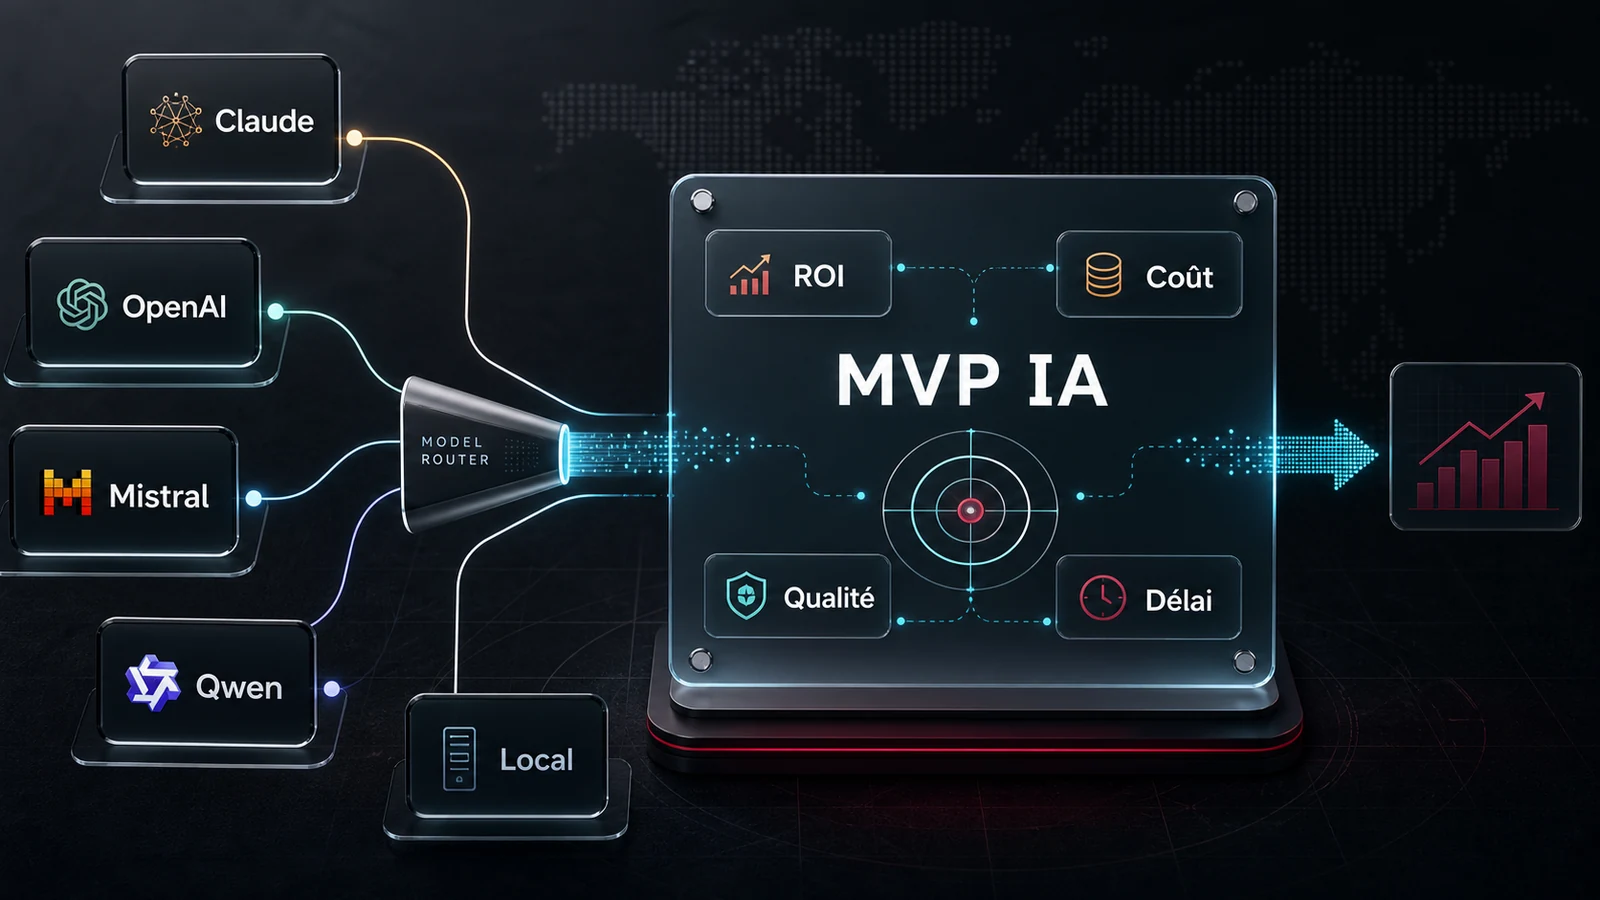
- Garder au moins deux fournisseurs de modèles utilisables, pour ne pas dépendre d’une seule grille tarifaire.
- Réserver les modèles les plus chers aux tâches qui en ont vraiment besoin et router le reste vers des modèles plus sobres.
- Conserver une option ouverte ou locale pour les usages critiques ou sensibles.
Cette dernière question rejoint celle de la souveraineté, que j’aborde dans mon article sur la stratégie IA en entreprise. Quand la capacité de calcul devient rare et que les éditeurs américains décident seuls de ce qu’un abonnement contient, dépendre d’un seul fournisseur devient un risque opérationnel. Le choix de Mistral d’héberger GLM-5.3 montre d’ailleurs que la question se pose aussi côté européen.
Sources et méthode
Références consultées le 30 septembre 2026. Les annonces d’OpenAI, les informations de presse et mon analyse sont distinguées dans le texte.
- Publications de Tibo Sottiaux sur X, annonce de la nouvelle grille et message sur l’usage en dollars d’API du 29 septembre, gel du Pro 200 du 10 septembre.
- Page d’aide d’OpenAI sur les forfaits Pro et annonces du DevDay 2026.
- Présentation de GPT-6 Sol et Luna et présentation des dots.
- Analyse d’Artificial Analysis sur Claude Opus 5.5 pour l’écart entre prix au token et coût par tâche.
- The Next Web pour le crédit de transition et le plafond de messages GPT-6 Pro, non confirmés sur une page officielle.
- Fortune du 12 septembre 2026 pour le calendrier de l’introduction en Bourse d’OpenAI.
La lecture d’un freinage de l’usage GPU, le tri entre développeurs et la bascule vers le paiement à l’usage relèvent de mon analyse. Les modèles « nerfés » décrivent une perception d’utilisateurs, pas une mesure. Les coûts de mes deux animations proviennent des transcripts des agents, au tarif public de l’API Anthropic du 29 septembre 2026.