La méthode
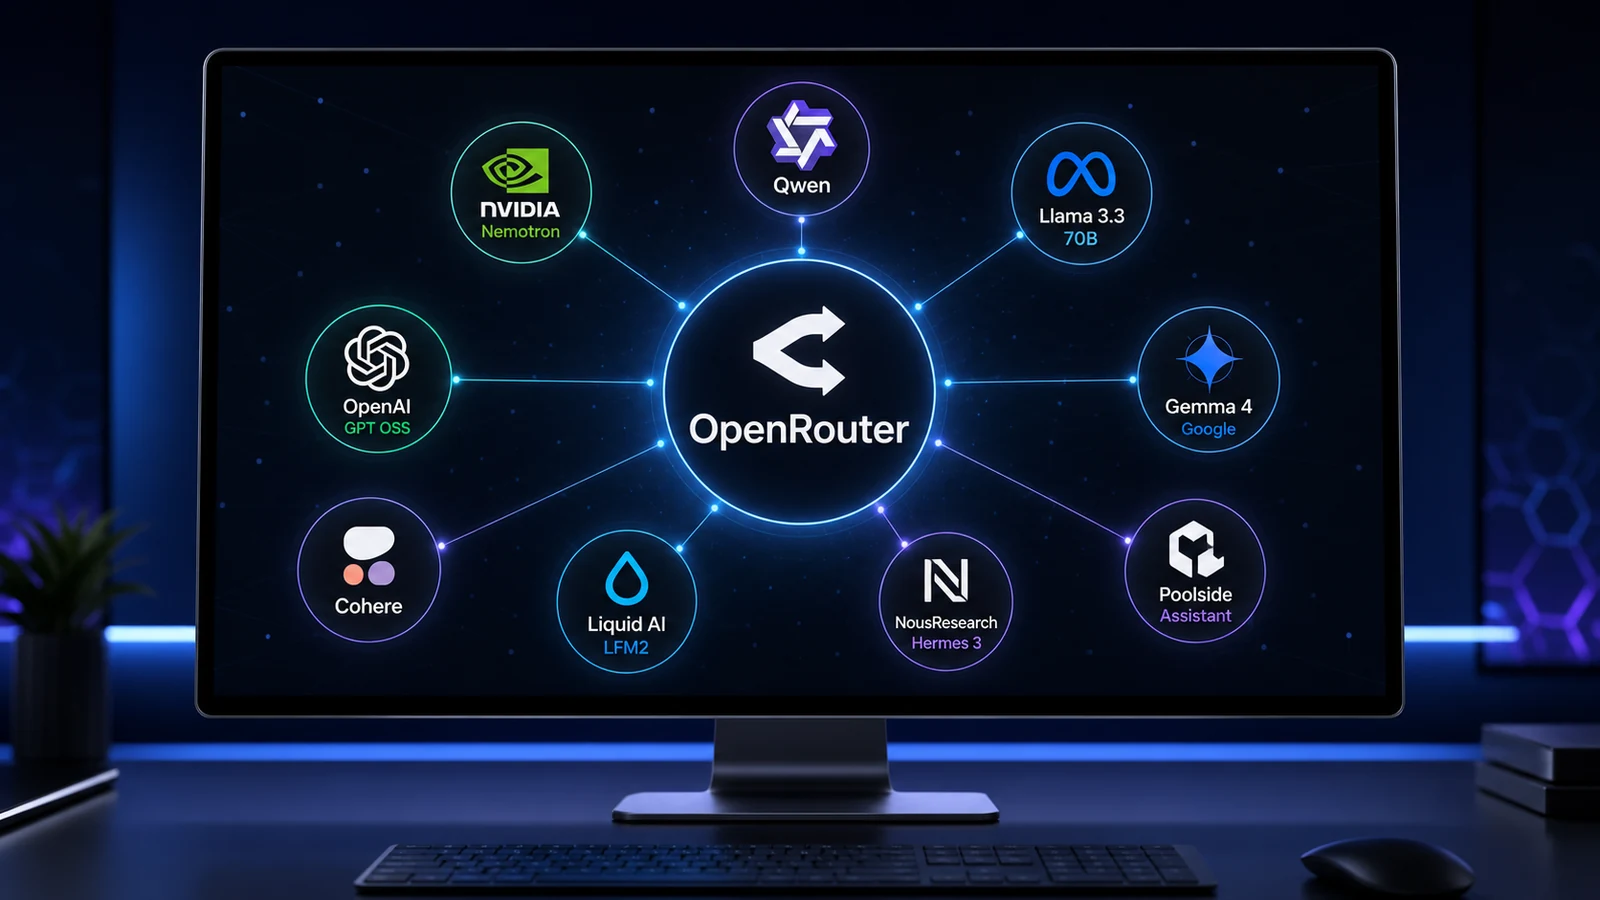
Le plus simple pour éviter les listes obsolètes, c'est de demander directement à OpenRouter. J'ai utilisé l'endpoint public openrouter.ai/api/v1/models puis filtré les modèles avec pricing.prompt == 0 et pricing.completion == 0.
Au 1er juillet 2026, ce filtre retourne 25 modèles gratuits. Attention : gratuit ne veut pas dire illimité, stable ou adapté à la production. Cela veut surtout dire que le coût affiché par OpenRouter est nul au moment du snapshot pour les tokens d'entrée et de sortie.
La disponibilité, les limites de débit et les conditions d'usage peuvent changer sans prévenir. Pour un projet sérieux, vérifiez toujours le modèle dans OpenRouter juste avant de l'utiliser.
Les modèles à tester en premier
La liste complète est intéressante, mais je ne commencerais pas par tout tester. Je partirais plutôt sur quelques candidats par usage.
| Usage | Modèle | Pourquoi |
|---|---|---|
| Coding agent | qwen/qwen3-coder:free | Gros contexte, modèle orienté code, bon candidat pour agents et outils. |
| Gros contexte | nvidia/nemotron-3-ultra-550b-a55b:free | 1M tokens de contexte et plus de 500B paramètres, intéressant pour longs documents, gros repos ou RAG exploratoire. |
| Baseline généraliste | meta-llama/llama-3.3-70b-instruct:free | Modèle connu, utile comme point de comparaison simple. |
| Open model OpenAI | openai/gpt-oss-120b:free | À tester pour comparer l'approche open model d'OpenAI aux familles open weight. |
| Multimodal | google/gemma-4-26b-a4b-it:free | Entrées texte, image et video vers texte, pratique pour expérimenter sans budget. |
| Router automatique | openrouter/free | Laisse OpenRouter router vers un modèle gratuit disponible. |
Pour le code et les agents IA, ces modèles gratuits peuvent être idéaux pour tester une boucle agentique à faible coût, par exemple avec un outil de bureau comme Hermes Agent. Je rapprocherais ce test de mes retours sur ZCode avec GLM-5.2, MiMo Code et mon comparatif LLM coding 2026. Le vrai sujet n'est plus seulement le modèle : c'est le harness autour, les outils, le contexte projet, les limites de coût et la qualité de l'itération.
La liste complète des 25 modèles gratuits
Voici le snapshot brut classé par taille de contexte. Je garde les identifiants OpenRouter exacts pour que vous puissiez les copier dans vos tests.
| Modèle | Contexte | Modalité |
|---|---|---|
google/lyria-3-clip-preview | 1M | text+image → text+audio |
google/lyria-3-pro-preview | 1M | text+image → text+audio |
qwen/qwen3-coder:free | 1M | text → text |
nvidia/nemotron-3-super-120b-a12b:free | 1M | text → text |
nvidia/nemotron-3-ultra-550b-a55b:free | 1M | text → text |
google/gemma-4-26b-a4b-it:free | 262K | text+image+video → text |
google/gemma-4-31b-it:free | 262K | text+image+video → text |
poolside/laguna-m.1:free | 262K | text → text |
poolside/laguna-xs.2:free | 262K | text → text |
qwen/qwen3-next-80b-a3b-instruct:free | 262K | text → text |
cohere/north-mini-code:free | 256K | text → text |
nvidia/nemotron-3-nano-30b-a3b:free | 256K | text → text |
nvidia/nemotron-3-nano-omni-30b-a3b-reasoning:free | 256K | text+image+audio+video → text |
openrouter/free | 200K | text+image → text |
meta-llama/llama-3.2-3b-instruct:free | 131K | text → text |
meta-llama/llama-3.3-70b-instruct:free | 131K | text → text |
nousresearch/hermes-3-llama-3.1-405b:free | 131K | text → text |
openai/gpt-oss-120b:free | 131K | text → text |
openai/gpt-oss-20b:free | 131K | text → text |
nvidia/nemotron-3.5-content-safety:free | 128K | text+image → text |
nvidia/nemotron-nano-12b-v2-vl:free | 128K | text+image+video → text |
nvidia/nemotron-nano-9b-v2:free | 128K | text → text |
cognitivecomputations/dolphin-mistral-24b-venice-edition:free | 32K | text → text |
liquid/lfm-2.5-1.2b-instruct:free | 32K | text → text |
liquid/lfm-2.5-1.2b-thinking:free | 32K | text → text |
Les limites du gratuit
Le gratuit OpenRouter est très utile pour découvrir un modèle, faire un test rapide ou construire un petit benchmark. Mais je ne le traiterais pas comme une base de production sans filet.
- Débit et disponibilité. Un modèle gratuit peut être limité ou indisponible selon le fournisseur derrière OpenRouter.
- Qualité variable. Certains modèles sont excellents sur un usage précis, mais moins fiables sur des consignes longues ou des workflows agentiques.
- Contexte théorique. Un contexte de 1M tokens ne garantit pas une bonne exploitation de tout le contexte.
- Données et entraînement. OpenRouter indique que certains modèles ou fournisseurs peuvent stocker les inputs, voire les utiliser pour améliorer ou entraîner leurs propres modèles. Avant d'envoyer du code client, des données sensibles ou un prompt stratégique, vérifiez la politique du provider, les tags de rétention et les options Zero Data Retention.
- Conditions mouvantes. Un modèle gratuit aujourd'hui peut changer de statut demain.
En clair : utilisez-les comme terrain de jeu et comme filtre de sélection. Pour un usage stable, gardez un modèle payant de secours, mesurez les erreurs et surveillez les coûts.
Mon conseil de départ
Si je devais en choisir un pour commencer, je partirais plutôt sur nvidia/nemotron-3-ultra-550b-a55b:free. Le modèle est puissant, dispose d'un très grand contexte et devient intéressant dès qu'on le place dans un bon harnais : instructions propres, contexte projet maîtrisé, outils bien exposés, évaluations simples et boucle d'itération rapide.
C'est surtout ça qui compte maintenant. La plupart des modèles récents sont suffisamment puissants pour réussir dans énormément de situations. La différence se fait de moins en moins sur le nom du modèle seul, et de plus en plus sur le système autour : prompts, MCP, skills, mémoire, routing, tests, coût et qualité du feedback.
OpenRouter est donc précieux comme terrain de comparaison pour les modèles gratuits. Pas pour chercher le modèle magique, mais pour identifier les bons candidats, les brancher dans un harness complet, puis mesurer lequel donne le meilleur ratio qualité, vitesse, stabilité et coût. En revanche, dès qu'un modèle convient à un usage sérieux, il faut basculer sur les endpoints payants pour avoir une vraie garantie de service, de disponibilité et de débit.