Une carte d’occasion a changé mon arbitrage
Il y a quelques mois, je regardais les petites stations IA avec beaucoup d’intérêt. Une grosse mémoire, un format compact, des modèles que l’on peut exécuter chez soi, tout cela avait de quoi donner envie. J’en ai parlé dans mon comparatif des mini-PC IA DGX Spark, Asus GX10 et GB10, puis dans mon analyse des box IA locales et des moteurs d’inférence.
Aujourd’hui, une carte graphique d’occasion répond déjà à une grande partie de mes besoins. Sur ma RTX 3090, j’obtiens une qualité et une fluidité qui rendent mes agents réellement utilisables au quotidien. Sur mes usages, je retrouve un niveau de qualité comparable à ce que j’attendais d’Opus 4.8.
J’ai récemment poussé l’expérience sur un vrai projet. Avec un flux de travail agentique entièrement local, j’ai produit en trois heures une application web fullstack, avec son interface et sa partie serveur, qui respectait mes standards de qualité et mes contraintes, notamment en matière de direction artistique. Franchement, ça a super bien fonctionné, avec une vitesse moyenne de 120 tokens par seconde pendant la génération. Les tokens sont les unités de texte manipulées par le modèle.
Ce qui m’a convaincu, c’est le résultat obtenu au bout de ces trois heures. L’agent suivait mes consignes et j’arrivais à l’application que je voulais, avec une réactivité suffisamment bonne pour garder un vrai rythme de travail. C’est là que le local a cessé d’être une expérimentation dans mon quotidien.
Dans mon retour sur Qwen, Strata et la RTX 3090, j’avais déjà présenté mes essais avec Qwen 3.8 Flash, Strata, une RTX 3090 et 64 Go de RAM. Depuis, mon arbitrage a continué d’évoluer en faveur de cette machine.
Les 650 € représentent le prix de ma carte, réutilisée dans mon PC. Ils ne représentent donc pas le prix d’une station complète. Mais c’est précisément ce qui m’intéresse. Quand une amélioration logicielle rend utile une machine que l’on possède déjà, elle peut changer la décision d’achat autant qu’une nouvelle génération de puces.
L’IA locale existait bien avant ces dernières semaines. Ce qui a changé pour moi, c’est son niveau de confort. Je ne la lance plus seulement pour voir si ça fonctionne, je m’en sers pour travailler.
Octobre rapproche les modèles ouverts des usages agentiques
Un modèle agentique doit pouvoir enchaîner des actions, utiliser des outils, lire leurs résultats et poursuivre une tâche. Une bonne réponse isolée ne suffit plus. Cela explique l’importance prise par le code, les longs contextes et l’efficacité de l’exécution dans les annonces récentes.
Les annonces d’octobre dessinent cette évolution. Cette sélection du 20 octobre a été complétée le 22 octobre 2026 avec Recursive Flint. B désigne un milliard de paramètres.
| Modèle | Situation vérifiée | Ce que je retiens |
|---|---|---|
| Mistral Large 4 | Preview API annoncée le 6 octobre ; poids attendus à la fin du mois | Un grand MoE multimodal qui remet Mistral dans la discussion sur les agents et les usages professionnels |
| Nemotron 3.5 Super VL et Bolt | Super VL et Bolt 74B-A9B disponibles depuis le 15 octobre ; Bolt E4B annoncé pour le 23 | Une gamme qui vise explicitement plusieurs tailles de machines, du serveur au poste local |
| Muse Spark Open | Poids accessibles ; 816B au total, 42B actifs, contexte de 1 million de tokens | Une offre multimodale ambitieuse, accompagnée d’intégrations dans plusieurs moteurs et plateformes |
| DeepSeek V4.1-Flash-1017 | Mise à jour publiée sous licence MIT, avec un contexte annoncé de 1 million de tokens | Le fournisseur met en avant des tâches terminées plus vite et des réponses plus courtes, en plus des progrès de qualité |
| Beam 1.0 | Poids publiés le 16 octobre sous Apache 2.0 | Un modèle de Reflection orienté code et agents, avec 501,3B de paramètres totaux et 23,4B actifs selon sa fiche |
| Step 5 Preview | Des poids sont proposés dans l’organisation officielle StepFun sur Hugging Face | Une architecture travaillée pour les tâches longues et le coût du contexte, avec 92 blocs Transformer |
| Ornith 1.5-122B et ses GGUF AtomicChat | Modèle MoE de DeepReinforce sous MIT ; poids d’origine et quantifications disponibles | Un acteur américain qui vise le code agentique et l’usage d’outils, dans un format plus compact que les grands MoE de plusieurs centaines de milliards de paramètres |
| Recursive Flint | Poids sous Apache 2.0 ; 39,8B de paramètres, environ 2,5B actifs par token | Un MoE pour le code local, accompagné du moteur rec et d’un travail conjoint sur l’architecture, la quantification et les noyaux d’exécution |
Cette vague couvre plusieurs échelles de déploiement, du poste personnel aux serveurs équipés de plusieurs GPU. C’est précisément ce qui m’intéresse : un écosystème commence à prendre forme autour de besoins et de budgets très différents.
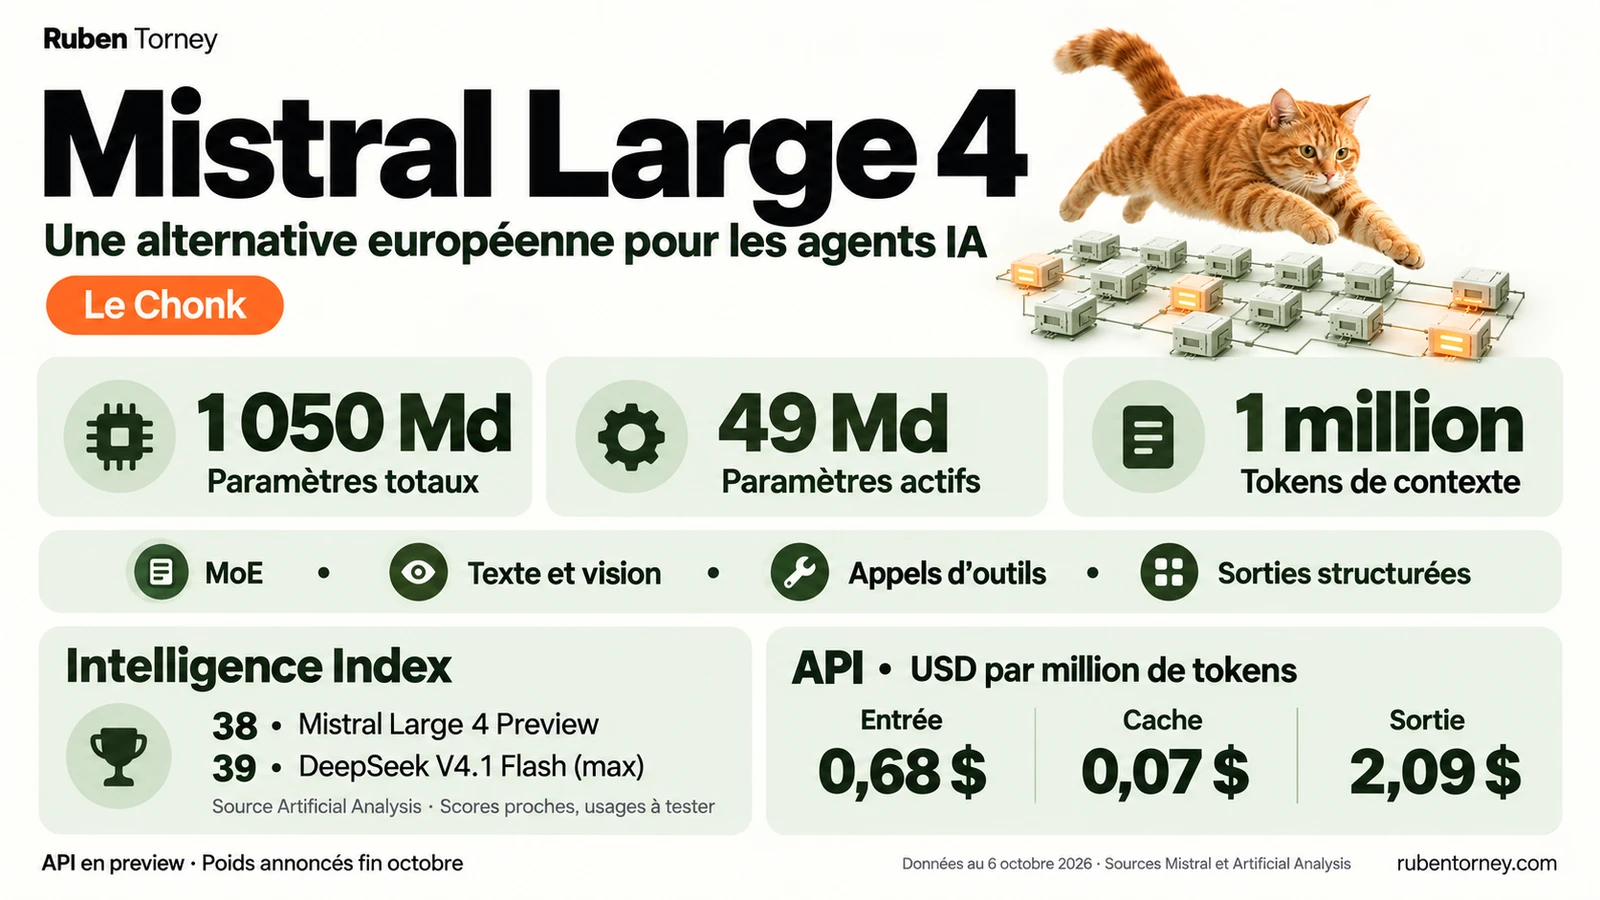
Mistral mérite aussi une précision. Au 19 octobre, Large 4 reste une preview API avec une ouverture des poids annoncée. Mon analyse de Mistral Large 4, Le Chonk et son architecture MoE détaillait déjà cette distinction.
Ornith ajoute un acteur américain dans une taille intermédiaire
Ornith 1.5-122B mérite une place dans cette vague. Il vient de DeepReinforce, une équipe américaine derrière la famille Ornith. Le modèle utilise une architecture Qwen 3.5 MoE, est publié sous licence MIT et propose une fenêtre de contexte native de 262 144 tokens. Sa fiche documente les appels d’outils et les intégrations avec Hermes Agent, que j’ai présenté avec son installation sur Windows, OpenClaw ou OpenCode, ce qui le place directement dans les usages qui m’intéressent.
Dans les évaluations publiées par DeepReinforce, il atteint 74,6 sur MCP-Atlas et 76,9 sur SWE-bench Pro. L’intérêt est de chercher ce niveau de capacité agentique avec un réseau de la classe 122B, plus compact que les très grands modèles évoqués plus haut. C’est exactement le genre de candidat que j’ai envie de tester en local.
Le dépôt AtomicChat que je retiens ici apporte la couche pratique. AtomicChat convertit les poids d’Ornith en GGUF, un format utilisé notamment par llama.cpp, avec plusieurs niveaux de quantification. Sa fiche donne par exemple 71,2 Go pour AD-Q4_K-IQ4_XS et 47,6 Go pour AD-IQ3_XXS-IQ2_S, hors mémoire de travail et contexte. On arrive à une classe de modèles intéressante pour les stations disposant de 64 à 128 Go de mémoire, avec une répartition entre GPU et RAM selon la machine et le moteur.
Ce cas enrichit aussi la lecture industrielle. La valeur se construit à plusieurs étages, entre l’équipe qui travaille le modèle, celle qui prépare les quantifications et les logiciels qui rendent l’ensemble utilisable. L’écosystème ouvert permet ainsi à d’autres acteurs américains de proposer des agents locaux, aux côtés des grands fabricants de puces et des laboratoires déjà installés.
Recursive Flint associe un petit MoE et son moteur local
Avec Flint, Recursive propose un format encore plus compact pour les agents de développement. Les poids sont ouverts sous Apache 2.0 et le modèle gère le raisonnement ainsi que les appels d’outils successifs. Sa fiche technique et son fichier de configuration permettent de préciser ce que recouvre l’étiquette « 40B-A2.5B ».
| Caractéristique | Recursive Flint |
|---|---|
| Paramètres totaux | 39,8 milliards |
| Paramètres actifs par token | Environ 2,5 milliards, tête de sortie incluse |
| Couches | 49, dont 2 denses et 47 MoE |
| Experts par couche MoE | 256 experts routés, 6 sélectionnés par token et un expert partagé toujours actif |
| Attention | 35 couches à fenêtre locale de 513 tokens et 14 couches d’attention globale |
| Têtes d’attention | 32 têtes de requête et 4 têtes clé/valeur |
| Contexte du checkpoint publié | 262 144 tokens, entrée et sortie comprises |
| Modalités | Texte en entrée et en sortie |
L’annonce de lancement évoque une prise en charge jusqu’à 512 000 tokens et recommande de rester dans 256 000 pour les meilleurs résultats. Dans les mesures publiées par Recursive, Flint dépasse 125 tokens/s sur MacBook Pro M4 Pro et 150 tokens/s sur RTX Spark 64 Go, à contexte court. La fiche du modèle rapporte également 54,9 % sur Terminal-Bench 2.1, 89,7 % sur SWE-bench Pro v2 et 74,2 % sur SWE-bench Verified.
La partie logicielle est tout aussi intéressante. Recursive publie rec, un moteur sous Apache 2.0 qui télécharge le modèle et connecte automatiquement Pi ou OpenCode. Les prérequis actuels sont un Mac M4 Pro, M5 Pro ou M5 Max avec au moins 48 Go de mémoire unifiée et environ 30 Go de stockage disponible. Le support RTX Spark de rec est annoncé comme à venir. La documentation llama.cpp fournit aussi des parcours Metal et CUDA, ce dernier sous Linux ou WSL2, avec un GGUF et une révision du moteur compatibles.
Ce que je retiens chez Recursive, c’est le travail sur toute la chaîne. Son système de recherche automatisée Eureka Machine intervient dans la conception du modèle et l’optimisation de son exécution. Cela rejoint le mouvement que je décris ici. Une architecture économe devient beaucoup plus utile lorsqu’elle arrive avec les poids adaptés, les bons noyaux de calcul et un moteur que l’on peut réellement installer sur sa machine.
Ce que montrent les classements aujourd’hui
Sur Artificial Analysis, j’ai retenu une sélection des modèles ouverts évoqués ici, en ajoutant GLM-5.3 et Kimi K3 pour situer cette vague dans un paysage plus large. En face, j’ai gardé les deux premiers modèles du classement, Claude Opus 5.5 et Sonnet 5.5, ainsi que GPT-6 Astra et GPT-6.1 Sol.
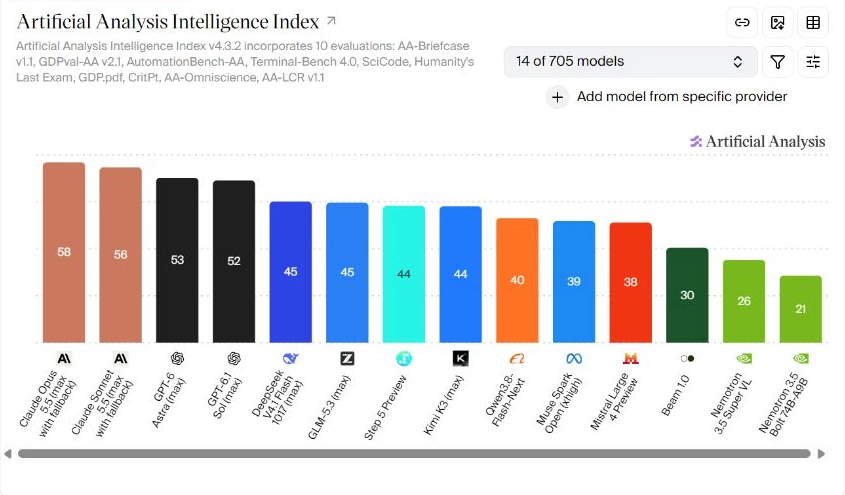
Opus 5.5 et Sonnet 5.5 atteignent respectivement 58 et 56, devant GPT-6 Astra à 53. DeepSeek V4.1 Flash 1017 et GLM-5.3 sont à 45, Step 5 Preview et Kimi K3 à 44. Qwen3.8-Flash-Next atteint 40, Muse Spark Open 39 et Mistral Large 4 Preview 38. Beam et les Nemotron occupent d’autres positions dans cette sélection, avec des compromis de capacité et d’efficacité différents.
L’écart avec les modèles fermés les plus puissants reste visible. Mais mon choix quotidien ne se résume pas à acheter le plus haut score. La vitesse, la disponibilité, le coût et la qualité sur mes propres tâches déterminent ce que je peux réellement en faire. Ce sont aussi les critères de mon comparatif des LLM pour le code et les agents.
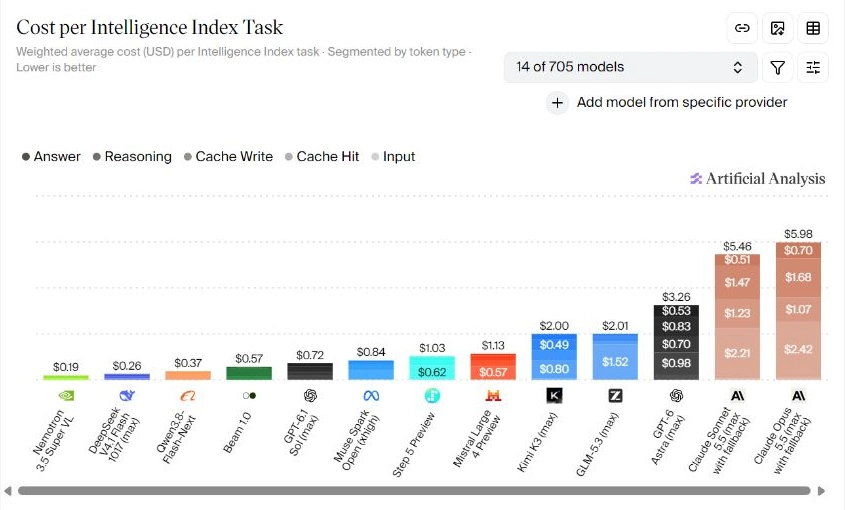
La seconde capture éclaire un autre aspect de la compétition. Dans cette sélection, Nemotron 3.5 Super VL et DeepSeek V4.1 Flash 1017 se situent à 0,19 et 0,26 dollar par tâche, contre 5,46 pour Sonnet 5.5 et 5,98 pour Opus 5.5 dans les configurations affichées. Les niveaux d’intelligence diffèrent aussi. Pour les industriels, améliorer ce rapport entre résultat et ressources consommées ouvre un marché bien plus large que la seule course au meilleur score. J’avais déjà exploré cette logique de coût par tâche dans mon analyse de DeepSeek V4 Flash pour les agents en entreprise.
Le MoE réduit le calcul, pas magiquement la mémoire
Le point commun de nombreuses annonces est le MoE, ou mélange d’experts. Un mécanisme de routage sélectionne une partie des sous-réseaux pour traiter chaque token, au lieu de mobiliser tous les paramètres à chaque étape.
L’image d’un assemblage de petits modèles est tentante, mais elle est imparfaite. Un expert n’est pas forcément un assistant autonome, doté d’une spécialité lisible comme le droit ou la comptabilité. C’est une partie du réseau, apprise pendant l’entraînement.
Cette architecture dissocie en partie la capacité totale du modèle et le calcul nécessaire à son exécution. En revanche, les poids des experts doivent rester accessibles quelque part. La VRAM du GPU, la RAM du PC, le stockage et les transferts entre ces espaces conservent leurs limites.
Prenons un exemple purement arithmétique. Un réseau de 500 milliards de paramètres représente environ 250 Go à quatre bits par paramètre, avant les métadonnées, les buffers et la mémoire liée au contexte. Même avec peu de paramètres actifs, il ne devient pas un modèle de 24 Go.
Le progrès vient donc de plusieurs leviers qui se rejoignent. Le MoE réduit une partie du calcul. La quantification réduit la précision de stockage des poids et leur encombrement. Le moteur d’inférence organise leur chargement et leur utilisation. Les architectures d’attention et la gestion du contexte limitent d’autres dépenses de mémoire et de calcul.
On voit une convergence des objectifs, avec des recettes différentes. StepFun décrit une combinaison d’attention locale et d’attention globale clairsemée. NVIDIA emploie notamment des composants Mamba dans Bolt. « Tous des MoE » ne signifie pas « tous la même architecture ».
NVIDIA dessine le modèle autour de la machine
Le cas Nemotron 3.5 Bolt 74B-A9B 24GB rend cette convergence très concrète. NVIDIA décrit une compression de l’architecture et une quantification pensées pour une cible mémoire inférieure à 24 Go.
Le détail technique est plus intéressant que la formule « modèle en deux bits ». La majorité des poids concernés utilise une quantification très basse précision, mais d’autres parties restent dans des formats différents. Le modèle est ensuite ajusté pour préserver ses capacités.
Pour moi, le signal industriel est là. Le constructeur ne fournit plus seulement une puce sur laquelle les développeurs essaieront de faire entrer un modèle. Il construit aussi un modèle pour une enveloppe matérielle et un usage précis.
Ceux qui possèdent le calcul veulent aussi l’écosystème
Chez NVIDIA, l’ensemble devient lisible. Le matériel, CUDA, les moteurs optimisés, les modèles Nemotron et les intégrations pour les agents se renforcent mutuellement. Un modèle ouvert peut faciliter l’adoption d’une plateforme, même lorsque son téléchargement n’est pas directement facturé.
L’ouverture peut réduire notre dépendance à une API tout en renforçant l’attractivité d’un écosystème matériel et logiciel. Les deux mouvements peuvent avancer ensemble.
Mistral suit une autre trajectoire. L’entreprise indique avoir entraîné Large 4 dans ses propres centres de données européens et y servir sa preview. Elle associe donc recherche, infrastructure et distribution. Meta, de son côté, accompagne Muse Spark Open d’un travail d’intégration avec plusieurs fabricants et moteurs. Il ne s’agit pas exactement du même modèle économique que celui d’un vendeur de GPU.
Tous cherchent à peser au-delà du fichier de poids. Les outils, la facilité de déploiement, les usages et les habitudes des développeurs deviennent une partie de la compétition.
La licence fait aussi partie du choix. Des poids téléchargeables ne donnent pas automatiquement les mêmes libertés. DeepSeek annonce MIT, Beam Apache 2.0, tandis que Muse Spark Open relève de la Muse Model License. Le terme « à poids ouverts » est plus précis ici qu’une étiquette « open source » appliquée indifféremment à toute la liste.
Les PC et les petites stations deviennent des points de déploiement
Le DGX Spark et les machines partenaires équipées du GB10 ont installé une proposition de station IA compacte. Les RTX Spark étendent cette ambition aux portables et aux petits ordinateurs Windows, avec une mémoire unifiée pouvant atteindre 128 Go selon la configuration.
Les RTX Spark utilisent des variantes N1/N1X, distinctes du GB10 du DGX Spark, avec la même logique associant Grace et Blackwell.
J’y vois deux chemins vers l’IA locale. Le premier passe par une nouvelle machine, avec une grande capacité mémoire et un ensemble logiciel mieux intégré, comme dans mon analyse du Mac Studio M5 Ultra 256 Go face au DGX Spark. Le second consiste à faire davantage avec le matériel existant, comme dans mon cas avec une RTX 3090.
Le premier peut simplifier l’installation. Le second peut réduire fortement le coût d’entrée. Aucun ne dispense de regarder le modèle réellement utilisé, le temps de réponse, la consommation et la place que prend la machine dans son quotidien.
Le logiciel remet les compteurs à zéro
llama.cpp travaille l’inférence sur différents matériels, les formats quantifiés et la répartition entre CPU et GPU. Strata vise notamment l’exécution de Qwen3.8-Flash-Next sur du matériel grand public. Sa documentation décrit le placement des experts entre plusieurs niveaux de mémoire.
Cela explique pourquoi une configuration peut devenir beaucoup plus intéressante sans changer de carte graphique. Le logiciel améliore la manière d’utiliser les ressources disponibles. Le placement des experts et la réduction des transferts deviennent alors des leviers essentiels de performance.
Prévoir du NVMe et de la RAM dans le budget
Il faut tout de même de la place pour les poids, les différentes quantifications et les fichiers de travail. Je privilégie un SSD NVMe avec suffisamment d’espace libre, pour charger les modèles rapidement et limiter les attentes lorsque le moteur doit lire des données sur disque. La documentation de Strata recommande fortement le NVMe et 64 Go de RAM pour sa configuration de référence. Accumuler plusieurs gros modèles représente vite plusieurs centaines de gigaoctets.
Quand le budget le permet, davantage de RAM apporte aussi du confort. Elle peut accueillir les poids qui ne tiennent pas en mémoire graphique et éviter une partie des lectures sur disque. La vitesse dépend donc de l’ensemble formé par le GPU, la RAM, le stockage, la quantification et le moteur. C’est ce qui permet de tirer le meilleur d’une carte que l’on possède déjà.
Les fenêtres de contexte de 512 000 à un million de tokens ouvrent aussi de nouveaux usages : garder davantage de fichiers, de consignes et d’historique dans une même session de travail. Leur exploitation dépend de la mémoire disponible et de la manière dont le moteur traite les données en entrée et conserve le contexte.
Pour juger mon installation, je préfère regarder si l’agent termine correctement mon travail, combien de temps j’attends et combien de fois je dois reprendre la main. Un chiffre de tokens par seconde apporte une information utile, mais il ne raconte pas toute l’expérience.
Quand les quotas fondent, le local devient un allié FinOps
Ces derniers jours, je vois se multiplier les témoignages de personnes dont les quotas s’épuisent beaucoup plus vite. J’ai le même ressenti. Mon abonnement Claude Max fond à vue d’œil, même sans utiliser Fable et sans lancer des chantiers particulièrement complexes. Cette semaine, je consomme davantage que la semaine passée, et je me retrouve à surveiller un compteur alors que je voudrais simplement avancer.
La capture ci-dessous illustre très bien ce décalage. Le 22 octobre, Priya explique que son usage d’Opus 5.5 lui semblait presque illimité la semaine précédente, puis montre un quota hebdomadaire déjà consommé à 90 %, sans usage intensif selon son témoignage. C’est exactement le genre de retour qui fait écho à mon expérience du moment.
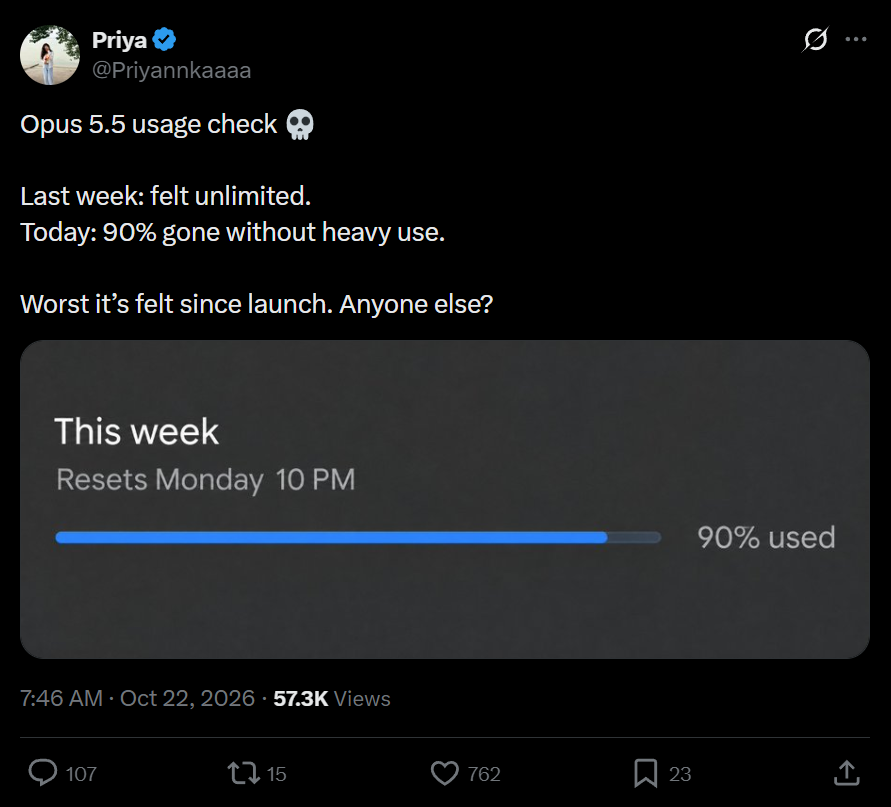
Anthropic documente des limites de session et des limites hebdomadaires. La consommation dépend notamment du modèle, du niveau d’effort, de la longueur des conversations et des fonctionnalités utilisées. Claude, Claude Code et Claude Desktop puisent dans la même enveloppe. Quand je passe d’un outil à l’autre, mon abonnement ne repart donc pas de zéro.
Cette tension entre abonnement et capacité réellement disponible dépasse Claude. Mon article sur ChatGPT Pro, les nouveaux quotas et la fin de l’open bar aborde le même arbitrage chez OpenAI.
Réserver les gros modèles aux décisions qui comptent
Une première réponse consiste à mieux répartir le travail. Fable ou Opus peuvent servir à clarifier le besoin, challenger l’architecture et produire un plan précis. Une fois les contraintes et les critères de validation posés, Sonnet peut prendre le développement, et Haiku les sous-tâches bien délimitées. Un Haiku poussé en effort max est aussi une option à tester sur les tâches qui le justifient, en gardant à l’esprit que monter l’effort consomme davantage de tokens.
Les modèles plus petits ont de solides arguments. Dans les évaluations publiées par Anthropic, Sonnet 5.5 atteint 70,6 % sur Terminal-Bench 4.0 et Haiku 5.5 atteint 39,2 % sur ce même benchmark de code agentique. Haiku est aussi présenté comme un sous-agent pour le développement. Il y a de quoi construire une chaîne de travail efficace sans solliciter le modèle le plus coûteux à chaque modification.
Une API locale pour reprendre la main sur le coût du travail
Pour une organisation, une API locale ajoute un levier FinOps très concret, c’est-à-dire un moyen de piloter le coût de ses usages informatiques. L’agent peut lui confier l’implémentation courante, les corrections, la documentation et les itérations répétées, puis revenir vers un modèle cloud lorsqu’un arbitrage difficile le demande. Chaque boucle exécutée sur la machine préserve de la capacité dans l’abonnement ou évite de la consommation sur une API facturée.
Quand on arrive à faire tourner un modèle de l’ordre de 120 à 125 milliards de paramètres sur un PC gamer accessible, grâce à la quantification et à la répartition des poids entre RAM et mémoire graphique, cette stratégie prend une autre dimension. Ornith et ses 122 milliards de paramètres illustrent cette classe de modèles. Le matériel et le moteur d’inférence deviennent une capacité de production que l’on possède et que plusieurs flux de travail peuvent exploiter.
Je regarde donc le coût par tâche terminée, le temps d’attente et les reprises nécessaires, en incluant l’amortissement de la machine, l’électricité et son entretien. Mon retour sur le coût imprévisible de GitHub Copilot au quotidien montre pourquoi ce suivi compte jusque dans les tâches ordinaires. À ce niveau, les API locales sont un allié FinOps important pour toute organisation qui utilise des agents au quotidien. Elles permettent de continuer à produire lorsque le compteur cloud approche de sa limite, et de choisir où dépenser son budget.
Le NVMe et la RAM ont un prix, et une configuration confortable représente un vrai investissement. Mais cela vaut le coup et le coût lorsque la machine remplace une consommation régulière d’API payantes. Sur des usages agentiques intensifs, les appels, le contexte et les itérations s’accumulent vite, alors que le matériel continue à servir. L’équipement peut ainsi s’amortir rapidement, à mesure des dépenses d’API réellement évitées. À cet intérêt économique s’ajoute la souveraineté, avec des poids, un moteur et des données que l’on peut conserver dans son propre environnement. C’est l’un des choix à cadrer dans une stratégie IA d’entreprise qui associe gouvernance, souveraineté et FinOps.
Le plan de secours peut devenir le chemin habituel
Cette évolution arrive alors que l’infrastructure centralisée fait face à des contraintes très physiques. Dans son rapport Energy and AI, l’Agence internationale de l’énergie estimait en 2025 qu’environ 20 % des projets de centres de données prévus risquaient des retards si les contraintes de réseau n’étaient pas résolues.
À ces contraintes d’infrastructure s’ajoutent les pannes, les saturations de service et les limites des abonnements. Les causes diffèrent, mais pour celui qui travaille avec un agent, le résultat est le même, le travail s’interrompt.
Un modèle local déjà installé apporte une réponse à une partie de cette dépendance. Il peut continuer à traiter des fichiers, rédiger ou travailler sur un dépôt disponible sur la machine lorsque le fournisseur distant est inaccessible. Les recherches web et les outils connectés restent, eux, dépendants du réseau et de leurs propres services.
À force de l’utiliser comme solution de secours, on peut constater qu’il suffit aussi pour les journées ordinaires. C’est ce qui m’intéresse dans le passage du plan B au plan A. Je réserve alors le cloud aux tâches où il apporte un avantage réel, plutôt que de lui confier automatiquement chaque opération.
L’absence de quota fournisseur change également le confort. Je peux relancer, expérimenter et laisser travailler un agent sans surveiller un compteur d’abonnement. Il reste un coût matériel, électrique et de maintenance, ainsi qu’une capacité limitée.
Mon prochain achat peut attendre
Pour mes usages actuels, je n’ai pas besoin d’un DGX Spark à quelque 7 000 €. Ma RTX 3090 d’occasion me suffit. Achetée 650 €, elle s’intègre dans un PC que je possédais déjà, avec un confort de travail et une qualité qui m’impressionnent encore.
La quantification et la répartition entre mémoire graphique et RAM me donnent accès à une très grande variété de modèles, y compris des MoE de la classe 125 milliards de paramètres comme Qwen3.8-Flash-Next avec Strata. Les plus gros demandent de choisir leur format et d’organiser la mémoire disponible. Aujourd’hui, ce que j’arrive à faire sur cette machine répond déjà à l’immense majorité de mes besoins, avec une fluidité qui me permet de travailler au quotidien.
Les sorties d’octobre renforcent cette conviction. Les modèles progressent, les machines se diversifient et les moteurs tirent davantage du matériel disponible. En parallèle, les industriels cherchent à devenir le point de passage naturel entre ces trois éléments.
Mon critère devient donc très concret. Quelle part de mon travail puis-je accomplir correctement, à un coût maîtrisé, avec une capacité que je contrôle ? Aujourd’hui, la réponse est suffisante pour que mon projet de DGX Spark attende. Et pour qu’une carte d’occasion à 650 € occupe une place bien plus importante que prévu dans ma façon de travailler.
Sources et méthode
Article finalisé le 20 octobre 2026, à partir des sources consultées le 19 octobre 2026 et des captures réalisées le 20 octobre 2026. Les caractéristiques et disponibilités viennent des éditeurs ; les interprétations industrielles relèvent de mon analyse.
Article complété le 22 octobre 2026 avec Recursive Flint, ses sources techniques et un retour sur les quotas Claude Max et le rôle FinOps des API locales.
- Mistral, annonce du 6 octobre et documentation de Large 4. Preview, ouverture annoncée et infrastructure. Les documents affichent des décomptes différents des paramètres ; cet article n’en fait pas un comparatif chiffré.
- NVIDIA, annonce Nemotron du 15 octobre et présentation technique de Bolt. Disponibilité, cible mémoire, compression et quantification.
- Meta, guide Muse Spark Open et fiche du modèle. Paramètres, contexte, modalités, intégrations et licence.
- DeepSeek, fiche V4.1-Flash-1017. Objectifs de la mise à jour, contexte et licence MIT.
- Reflection, publication des poids et fiche Beam. Licence et caractéristiques.
- StepFun, présentation technique et organisation officielle Hugging Face. Architecture et présence des poids.
- Ornith / DeepReinforce, fiche Ornith 1.5-122B et site de l’équipe, consultés le 20 octobre 2026. Architecture MoE, licence MIT, contexte, intégrations agentiques et résultats publiés par l’équipe. Dealroom situe l’entreprise en Californie, aux États-Unis.
- AtomicChat, GGUF Ornith 1.5-122B, consulté le 20 octobre 2026. Conversion des poids Ornith, tailles des fichiers et méthode de quantification. Logo Ornith repris comme référence depuis les assets du dépôt d’origine pour l’illustration.
- Recursive, annonce de Flint, fiche du modèle et configuration publiée, consultées le 22 octobre 2026. Paramètres, experts, attention, contexte, licence et performances rapportées par l’équipe.
- Recursive, rec sur GitHub, prérequis de rec et guide llama.cpp, consultés le 22 octobre 2026. Moteur local, intégrations, matériel et disponibilité des différents parcours. Logo Recursive extrait de la marque affichée sur son site officiel pour la mise à jour de l’illustration.
- NVIDIA, fiche RTX Spark. Formats de machines, mémoire et références de puces.
- ggml-org, llama.cpp, et Strata, dépôt et documentation technique, revérifiés le 22 octobre 2026. Capacités des moteurs, Qwen3.8-Flash-Next 125B sur PC grand public, recommandation NVMe et RAM, placement des experts entre mémoire graphique, RAM et stockage.
- AIE, résumé du rapport Energy and AI, 2025. Risques de retards liés aux réseaux électriques, et non diagnostic des incidents API.
- Artificial Analysis, graphiques et sélection de modèles. Captures réalisées dans le navigateur le 20 octobre 2026 ; les scores et coûts correspondent aux configurations visibles.
- Anthropic, limites d’usage et réglages du modèle et de l’effort, consultés le 22 octobre 2026. Enveloppe partagée entre les interfaces Claude, limites de session et hebdomadaires, facteurs de consommation.
- Anthropic, Sonnet 5.5, 28 septembre 2026 et Haiku 5.5, 7 octobre 2026, consultés le 22 octobre. Scores Terminal-Bench 4.0 publiés par l’éditeur et positionnement de Haiku comme sous-agent de développement.
- Priya (@Priyannkaaaa), publication X du 22 octobre 2026 sur les quotas Opus 5.5. Capture fournie par Ruben et reproduite avec son contexte visible ; le lien direct de la publication n’a pas été fourni. Témoignage individuel, rapproché du retour personnel de Ruben sur Claude Max.
- Illustration, miniature créée avec ImageGen dans la direction artistique du blog ; les logos identifient les laboratoires évoqués.
- Retour personnel, article du 6 octobre sur les box IA et expérience de développement fullstack relatée dans cet article.